DRBD+heartbeat实现文件服务器双机热备和高可用
1 需求
目前公司内部有一台文件服务器,它是一个单节点,如果该节点出现意外宕机,将会严重影响业务。
因此,本文用了drbd+heartbeat实现双机热备高可用。
2 架构拓扑
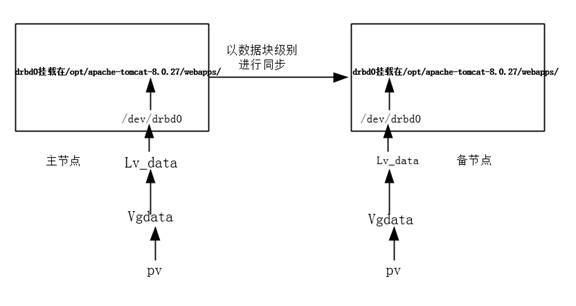
3 系统环境
1、操作系统:CentOS 6.6
2、相关软件:drbd-8.4.8-1、drbd-utils-8.9.6
3、网络要求:/etc/hosts文件添加双方主机名列表。
4、两台机器的分区最好大小一致,至少要保证备节点的分区尺寸大于主节点的,以避免后期因空间不足而出现难以预见的问题
5、为了高效率,可以把drbd对外提供服务的网络和drbd数据同步网络分开,这样可以使业务和数据同步互不影响。
6、规划两台主机之间的心跳线为两根以上,这样能保证不会因为某一线路故障而产生切换 工作。在高可用方案中,一般需要用三根以上心跳线进行心跳检测,以减少误切换和脑裂问题,同时要确认上层交换机是否禁止ARP广播。
7、只有保证两台机器型号或性能一样好,才能保证在切换后备节点能完成原来主节点承担的业务负载。
4 地址规划
浮动 VIP : 172.16.22.9
主机名:drbd1
eth0:172.16.22.7 业务ip----)不配置网关
eth1:172.16.1.71 心跳线 ---->配置网关,我们通过该ip进行ssh登录管理
eth2:2.2.2.10 DRBD千兆数据传输----->不配置网关
主机名:drbd2
eth0:172.16.22.8 业务ip----)不配置网关
eth1:172.16.1.72 心跳线---->配置网关,我们通过该ip进行ssh登录管理
eth2:2.2.2.11 DRBD千兆数据传输 ----->不配置网关
5 安装软件
1、安装支持软件
#在编译安装之前,必须安装内核开发包,以及支持库
[shell]# yum -y install gcc kernel-devel kernel-headers
[shell]# yum -y install perl perl-libs
[shell]# yum -y install flex libxslt libxslt-devel
drbd官网下载地址:http://oss.linbit.com/drbd/
编译安装drbd (drbd1和drbd2两个服务器都安装)
2.1、安装drbd内核模块
## Linux Kernel 2.6.33 起已包含DRBD内核模块,无需再安装。核心版本与DRBD版本对应关系详情参见:http://drbd.linbit.com/download/mainline/
[shell]# tar -xvzf drbd-8.4.8-1.tar.gz -C /usr/local/src
[shell]# cd /usr/local/src/drbd-8.4.8-1
[shell]# cd drbd
[shell]# make KDIR=/usr/src/kernels/2.6.32-504.23.4.el6.x86_64
[shell]# cp drbd.ko /lib/modules/`uname -r`/kernel/lib/
[shell]# depmod ## 更新内核包关联文件modules.dep
[shell]# modprobe drbd ## 安装内核模块
[shell]# modinfo drbd ## 查看drbd内核模块是否加载成功
[shell]#lsmod|grep drbd # 检查drbd是否被正确的加载到内核
drbd 385827 0
libcrc32c 1246 1 drbd
## KDIR= 指定的系统内核源码路径,根据实际情况设置
2.2、安装drbd管理工具
[shell]# tar -xvzf drbd-utils-8.9.6.tar.gz -C /usr/local/src
[shell]# cd /usr/local/src/drbd-utils-8.9.6
[shell]# ./configure --prefix=/usr/local/drbd --sysconfdir=/etc/ --localstatedir=/var/ --with-heartbeat
[shell]# make && make install
##--with-heartbeat 支持heartbeat
3、超链接配置文件、启动脚本
[shell]# ln -s /usr/local/drbd/sbin/drbdadm /usr/sbin/drbdadm
[shell]# ln -s /usr/local/drbd/sbin/drbdmeta /usr/sbin/drbdmeta
[shell]# ln -s /usr/local/drbd/sbin/drbdsetup /usr/sbin/drbdsetup
4、启动软件
[shell]# /etc/rc.d/init.d/drbd start
以上步骤在drbd1和drbd2两个节点都执行。
6 软件配置
1、 修改DRBD配置文件: drbd1&&drbd2节点上都如下操作
a) 编辑主配置文件 /etc/drbd.conf
drbd.conf描述了drbd设备与硬盘分区的映射关系和一些配置参数
[shell]# vi /etc/drbd.conf
# You can find an example in /usr/share/doc/drbd.../drbd.conf.example
include "/etc/drbd.d/global_common.conf";
include "/etc/drbd.d/*.res";
## global_common.conf文件包含global和common的DRBD全局配置部分;
## *.res文件包含DRBD资源的配置信息。
b) 编辑全局配置文件(global_common.conf):
[shell]# vi /etc/drbd.d/global_common.conf
# DRBD is the result of over a decade of development by LINBIT.
# In case you need professional services for DRBD or have
# feature requests visit http://www.linbit.com
global {
usage-count no; # 是否加入DRBD官方统计
}
common {
handlers {
# 定义处理机制程序,/usr/lib/drbd/ 里有大量的程序脚本。
}
startup {
# 定义启动超时时间等
}
options {
# cpu-mask on-no-data-accessible
}
disk {
# 磁盘相关公共设置,比如I/O、数据状态
on-io-error detach; #发生i/o错误的处理方法,detach将镜像磁盘直接拔除
}
net {
# 设置DRBD同步时使用的验证方式和密码信息。
cram-hmac-alg sha1;
shared-secret "drbd";
}
syncer {
verify-alg sha1;
# 定义主备节点同步时的网络传输速率最大值,一般传输速度的30%
rate 50M;
}
}
########
备注:对于rate参数,一般是用千兆网络的同步速率和磁盘写入速率(hdparm -Tt /dev/drbd0测试结果)中最小者的30%带宽来设置rate的值,这也是官方的建议。
例如千兆网络的的同步速率为125M/s,磁盘写入速率为110m/s(hdparm –Tt /dev/drbd0测试结果)
那rate设置为33m/s。这样设置的原因是,drbd同步由两个不同的进程来负责:一个replication进程用来同步block的更新,这个值就受限于rate参数的设置;一个syncchribuzatuib进程用来同步元数据信息,这个值不受rate参数的限制。如果写入了非常大,设置的rate参数超过磁盘写入速度,元数据的同步速率就会受干扰,传输进度变慢,导致机器负载非常高,性能下降得非常厉害,所以这个值应该根据实际环境来进行设置。如果设置的太大,会把所有的带宽占满了,导致replication进程没有可用带宽,最终导致I/O停止,出现数据不同步的现象。
###################
c) 创建资源配置文件(/etc/drbd.d/r0.res)
[shell]# vi /etc/drbd.d/r0.res
resource r0 {
# 公用相同部分可以放到顶部,各节点会自动继承
protocol C; # 使用drbd的第三种同步协议,表示收到远程主机的写入确认后,则认为写入完成
device /dev/drbd0; # DRBD逻辑设备的路径
meta-disk internal; # drbd的元数据存放方式,DRBD磁盘内部。
# 每个主机的说明以"on"开头,后面是主机名.在后面的{}中为这个主机的配置.
on drbd1 { # 此处是节点的主机名‘uname -n’
address 192.168.10.11:7788; # 设置DRBD的监听端口
disk /dev/vg_drbd/drbd_data; # 节点物理设备,用的未格式化的lvm
}
on drbd2 {
address 192.168.10.12:7788;
disk /dev/vg_drbd/drbd_data; #节点物理设备,用的未格式化的lvm
}
}
2、启用DRBD资源
## 创建设备元数据。这一步必须仅在创建初始化设备时完成。它初始化DRBD元数据。
[shell]# drbdadm create-md r0 #drbd1&&drbd2上都执行
这里也可以使用drbdadm create-md all来代替drbadmin create-md r0,r0就是上面r0.res文件里面创建的资源名称
备注:这里面有可能出现创建不成功的现象,
如出现zreo out the device ,shrink that filesystem first,user external meta data这样的错误,说明drbd0这个设备里面有已经存在的数据,这时需要使用如下命令覆盖文件系统中的设备块信息,操作时确认此分区上的数据已经备份过
dd if=/dev/zero of=/dev/drbd0 bs=1M count=128
执行完dd后,再执行drbdadmin create-md all命令
## 启用资源
[shell]# drbdadm up r0
## 启动初始完全同步,设置主节点。
[shell]# drbdadm primary --force r0 #只在主节点drbd1上执行即可
当执行完上面一条命令后初始完全同步就开始了,可以通过cat /proc/drbd来监控同步进程。
[shell]# cat /proc/drbd
3、创建文件系统(仅在drbd1执行)
## 把/dev/drbd0格式化成ext4格式的文件系统。
[shell]# mkfs -t ext4 /dev/drbd0
## 将/dev/drbd0挂载到数据目录
[shell]# mount /dev/drbd0 /opt/apache-tomcat-8.0.27/webapps/
设置drbd开机自启动
[shell]# chkconfig drbd on
7 监控
可以通过/proc/drbd来监控同步进程。
[shell]# cat /proc/drbd
1、ds:UpToDate/Diskless表示其中一个节点没有初始化,
[root@drbd1 ~]# cat /proc/drbd
version: 8.4.6 (api:1/proto:86-101)
GIT-hash: 833d830e0152d1e457fa7856e71e11248ccf3f70 build by root@drbd21, 2015-06-16 15:37:24
0: cs:Connected ro:Primary/Secondary ds:UpToDate/Diskless C r-----
ns:0 nr:0 dw:0 dr:664 al:0 bm:0 lo:0 pe:0 ua:0 ap:0 ep:1 wo:f oos:20970844
2、ds:UpToDate/Inconsistent表示节点已开始同步,
[root@drbd1 ~]# cat /proc/drbd
version: 8.4.6 (api:1/proto:86-101)
GIT-hash: 833d830e0152d1e457fa7856e71e11248ccf3f70 build by root@drbd21, 2015-06-16 15:37:24
0: cs:SyncSource ro:Primary/Secondary ds:UpToDate/Inconsistent C r-----
ns:925056 nr:0 dw:0 dr:925720 al:0 bm:0 lo:0 pe:0 ua:0 ap:0 ep:1 wo:f oos:20045788
[>....................] sync'ed: 1.4% (19572/19836)M #从这可以看到同步进度为%1.4
finish: 0:24:57 speed: 13,380 (10,784) K/sec #从这可以看出同步速度为10m/s
3、节点同步完成,ds:UpToDate/UpToDate
[root@drbd21 ~]# cat /proc/drbd
version: 8.4.6 (api:1/proto:86-101)
GIT-hash: 833d830e0152d1e457fa7856e71e11248ccf3f70 build by root@drbd21, 2015-06-16 15:37:24
0: cs:Connected ro:Primary/Secondary ds:UpToDate/UpToDate C r-----
ns:20970844 nr:0 dw:0 dr:20971508 al:0 bm:0 lo:0 pe:0 ua:0 ap:0 ep:1 wo:f oos:0
备注:
ro是角色信息
ds:是磁盘状态,UpToDate/UpToDate表示同步状态没有延时
ns是网络发送的包,以k为单位
dw是磁盘写操作
dr是磁盘读操作
8 测试主节点写入,备节点是否能同步
drbd1端:
[root@drbd1 ~]#tocuch /opt/apache-tomcat-8.0.27/webapps/1.txt
[root@drbd1 ~]#umount /opt/apache-tomcat-8.0.27/webapps/
[root@drbd1 ~]#drbdadm down r0 # 关闭名字为drbd的资源
drbd2端:
[root@drbd2 ~]#cat /proc/drbd # 主节点关闭资源之后,查看备节点的信息,可以看到主节点的角色已经变为UnKnown
version: 8.4.3 (api:1/proto:86-101)
GIT-hash: 89a294209144b68adb3ee85a73221f964d3ee515 build by root@M2.redhat.sx, 2014-11-11 16:25:08
0: cs:WFConnection ro:Secondary/Unknown ds:UpToDate/DUnknown C r-----
ns:0 nr:136889524 dw:136889524 dr:0 al:0 bm:8156 lo:0 pe:0 ua:0 ap:0 ep:1 wo:d oos:0
[root@drbd2 ~]#drbdadm primary drbd # 确立自己的角色为primary,即主节点
[root@drbd2 ~]#mount /dev/drbd0 /opt/apache-tomcat-8.0.27/webapps/
[root@drbd2 ~]# cd /opt/apache-tomcat-8.0.27/webapps/
[root@drbd2 ~]# ls # 发现数据还在
lost+found 1.txt
[root@drbd2 ~]# cat /proc/drbd # 查看当前 drbd 设备信息
version: 8.4.3 (api:1/proto:86-101)
GIT-hash: 89a294209144b68adb3ee85a73221f964d3ee515 build by root@M2.redhat.sx, 2014-11-11 16:25:08
0: cs:WFConnection ro:Primary/Unknown ds:UpToDate/DUnknown C r-----
ns:0 nr:136889524 dw:136889548 dr:1045 al:3 bm:8156 lo:0 pe:0 ua:0 ap:0 ep:1 wo:d oos:24
9 heartbeat 实现高可用
上面我们可以看到,如果我们只安装drbd,发现主节点故障后,我们需要手工来切换drbd的主备角色,比较不够智能。
那有没有自动切换drbd的方法呢,答案是有,这就需要用heartbeat了。
9.1 安装heartbeat
drbd1&&drbd2两个节点上都安装heartbeat
用epel源安装heartbeat。
wget https://ftp.yzu.edu.tw/Linux/Fedora-EPEL/6/x86_64/epel-release-6-8.noarch.rpm
rpm -ivh epel-release-6-8.noarch.rpm
yum –y install heartbeat
9.2 heartbeat配置文件
[root@DRBD1 yum.repos.d]# cd /usr/share/doc/heartbeat-3.0.4/
[root@DRBD1 heartbeat-3.0.4]# ll |egrep 'ha.cf|authkeys|haresources'
-rw-r--r--. 1 root root 645 Dec 3 2013 authkeys # heartbeat服务的认证文件,也就是心跳线连接加密文件
-rw-r--r--. 1 root root 10502 Dec 3 2013 ha.cf # heartbeat服务主配置文件,也就是监控文件
-rw-r--r--. 1 root root 5905 Dec 3 2013 haresources # heartbeat资源管理文件
[root@DRBD1 heartbeat-3.0.4]# cp ha.cf authkeys haresources /etc/ha.d/
[root@DRBD1 heartbeat-3.0.4]# cd /etc/ha.d/
[root@DRBD1 ha.d]# ls
authkeys ha.cf harc haresources rc.d README.config resource.d shellfuncs
下面我列出这三个文件的配置信息。
drbd1节点:
a)、ha.cf 文件
debugfile /var/log/ha-debug #打开错误日志报告
logfile /var/log/ha-log
logfacility local0
keepalive 1 #一秒检测一次心跳线连接
deadtime 5 #5 秒测试不到主服务器心跳线为有问题出现
warntime 5 #警告时间(最好在 2 ~ 10 之间)
initdead 10 #初始化启动时 10 秒无连接视为正常,或指定heartbeat,也就是说在启动时,需要等待10秒才去启动任何资源。
udpport 694 #用 udp 的 694 端口连接
ucast eth1 172.16.1.71 #单播方式连接(主从都写对方的 ip 进行连接)
ucast eth0 172.16.22.8 #单播方式连接(主从都写对方的 ip 进行连接),写两个心跳是为了安全,其实写一个就行
node drbd1 #声明主服(注意是主机名uname -n不是域名)
node drbd2 #声明备服(注意是主机名uname -n不是域名)
auto_failback off #自动切换(主服恢复后可自动切换回来)这个不要开启
respawn hacluster /usr/lib64/heartbeat/ipfail #监控ipfail进程是否挂掉,如果挂掉就重启它
b、authkeys 文件
[root@drbd1 ha.d]# cat authkeys
auth 1 # 采用何种加密方式
1 crc # 无加密
#2 sha1 HI! # 启用sha1的加密方式
#3 md5 Hello! # 采用md5的加密方式
[root@drbd1 ha.d]# chmod 600 authkeys # 该文件必须设置为600权限,不然heartbeat启动会报错
c、haresources
[root@drbd1 ha.d]# vi haresources
drbd1 drbddisk::r0 Filesystem::/dev/drbd0::/opt/apache-tomcat-8.0.27/webapps IPaddr::172.16.22.9/24/eth0 tomcat
heartbeat就按照上述顺序挂载资源。
注释:
drbd1表示主节点的主机名。
IPaddr::172.16.22.9/24/eth0设置虚拟ip
drbddisk::r0 表示管理资源r0,就是在/etc/drbd.d/r0.res里面定义的资源r0
Filesystem::/dev/drbd0::/opt/apache-tomcat-8.0.27/webapps/::ext4表示执行umount和mount时的操作
tomcat是必须有/etc/init.d/tomcat脚本。
drbd2节点上的配置和drbd1的基本一致,只是标黄色的不一样。
drbd2节点:
a)、ha.cf 文件
debugfile /var/log/ha-debug #打开错误日志报告
logfile /var/log/ha-log
logfacility local0
keepalive 1 #1秒检测一次心跳线连接
deadtime 5 #5 秒测试不到主服务器心跳线为有问题出现
warntime 5 #警告时间(最好在 2 ~ 10 之间)
initdead 10 #初始化启动时 10 秒无连接视为正常,或指定heartbeat,在启动时,需要等待10秒才去启动任何资源。
udpport 694 #用 udp 的 694 端口连接
ucast eth1 172.16.1.72 #单播方式连接(主从都写对方的 ip 进行连接)
ucast eth0 172.16.22.7 #单播方式连接(主从都写对方的 ip 进行连接)
node drbd1 #声明主服(注意是主机名uname -n不是域名)
node drbd2 #声明备服(注意是主机名uname -n不是域名)
auto_failback off #自动切换(主服恢复后可自动切换回来)这个不要开启
respawn hacluster /usr/lib64/heartbeat/ipfail #监控ipfail进程是否挂掉,如果挂掉就重启它
b、authkeys 文件
[root@drbd2 ha.d]# cat authkeys
auth 1 # 采用何种加密方式
1 crc # 无加密
#2 sha1 HI! # 启用sha1的加密方式
#3 md5 Hello! # 采用md5的加密方式
c、haresources
[root@drbd2ha.d]# vi haresources
drbd2 drbddisk::r0 Filesystem::/dev/drbd0::/opt/apache-tomcat-8.0.27/webapps IPaddr::172.16.22.9/24/eth0 tomcat
备注:172.16.22.9是vip
9.3 测试主节点宕机后,备节点是否自动挂载drbd
a)、首先把drbd1主节点给宕机,执行reboot
b)、然后到备节点drbd2上查看vip(通过命令 ip addr show查看)已经获取,通过df –h命令查看/dev/drbd0已经挂载到相应目录下面
c)如果主节点drbd1恢复好后,该节点会置为备,并且设置为不会夺回vip。
如果想切换回原来的主备状态,只需要把drbd2的heartbeat服务重启一下就行了(/etc/init.d/heartbeat restart),查看到drbd1上查看vip已经出现,drbd0挂载到了相应的目录下面。
至此,heartbeat +drbd配置成功。
10 ·LVM下增加drbd设备容量
如果发现drbd管理的磁盘逻辑卷空间不足时,可以给该逻辑卷动态增加容量。
如果容量过大,想减小容量也是可以的。不过扩容容易,回收空间就容易出问题了。
不建议收回空间。
假设drbd resource资源r0 对应的media为drbd0,逻辑卷为/dev/vg_drbd/drbd_data
挂载的目录为/data。则扩容步骤:
1. 备份文件并卸载逻辑卷(只需在primary主机上执行)
[root@DRBD1 conf]# cp -r /data /backup
[root@DRBD1 conf]# umount /data
2. 给逻辑卷扩容20G空间(在primary和secondary主机上都要执行)
[root@DRBD1 conf]# lvresize -L +20G /dev/vg_drbd/drbd_data
3. 重置drdb resource资源 r0。因为drbd服务没有停止,因此不需要执行e2fsck了。
(只需在primary主机上执行)
[root@DRBD1 conf]# drbdadm resize r0
4. 挂在逻辑卷(只需在primary主机上执行)
[root@DRBD1 conf]# mount /dev/drbd0 /data
5. 重置文件系统容量
[root@DRBD1 conf]# resize2fs /dev/drbd0
[root@DRBD1 conf]#
到这里,drbd扩容已经完成。其实第1和第4步可以不用执行的。
减小空间类似操作,将+20G变为-20G就是减少20G空间。
11 错误处理
11.1 软件编译时,错误解决办法:
1、configure: error: Cannot build utils without flex, either install flex or pass the --without-utils option.
解决方式:yum install flex
11.2 软件运行时,错误解决办法:
1、[shell]# /etc/rc.d/init.d/drbd start
Starting DRBD resources: no resources defined!
解决办法:没有配置DRBD资源,或编译时没指定配置文件路径(/etc/drbd.conf)。
2、当执行命令”drbdadm create-md r0”时,出现以下错误信息。
Device size would be truncated, which would corrupt data and result in
'access beyond end of device' errors.
You need to either
* use external meta data (recommended)
* shrink that filesystem first
* zero out the device (destroy the filesystem)
Operation refused.
Command 'drbdmeta 0 v08 /dev/xvdb internal create-md' terminated with exit code 40
drbdadm create-md r0: exited with code 40
解决办法:初始化磁盘文件格式, dd if=/dev/zero of=/dev/sdXYZ bs=1M count=1
11.3 drbd脑裂手动恢复过程
drbd出现脑裂的几种情况:
a)备节点长期不在线
其实drbd的对等节点如果不在线的话,即主节点的数据更改如果无法及时传送到备节点达到一定时间,会造成数据不一致,即使故障节点在长时间离线后恢复,drbd可能也不能正常同步了。或者另外一种情况,主备都在线,但心跳网络断了而出现脑裂,两个节点都认为自己是主节点,也会造成两个节点的数据不一致,这样需要人工干预,告诉drbd以哪个节点为主节点,或者在drbd配置脑裂的行为。下面是长时间备节点不在线后出现的情况:
b)主节点意外宕机
思想:(以drbd1的数据位主,放弃drbd2不同步数据):
1)将Drbd1设置为主节点并挂载测试,r0为定义的资源名
[shell]# drbdadm primary r0
[shell]# mount /dev/drbd0 /mnt/drbd0
[shell]# ls -lh /mnt/drbd0 查看文件情况
2)将Drbd2设置为从节点并丢弃资源数据
[shell]# drbdadm secondary r0
[shell]# drbdadm -- --discard-my-data connect r0 #从主节点同步数据,并且discard自己的数据
3)在Drbd1主节点上手动连接资源
[shell]# drbdadm connect r0
4)最后查看各个节点状态,连接已恢复正常
[shell]# cat /proc/drbd
案例:
drbd1为主,drbd2为辅;我个人觉得这个DRBD脑裂的行为,也应该是前期人为或是故障切换造成的,
如HA。 上次跟一朋友去一客户那里,他那就是属于使用HA做故障切换,最后不知道他们咋搞,在一台机上把DRBD的服务给挂了,因为该服务器非常重要,他们对HA及DRBD架构不太熟,在一次HA切换测试过程中出现了问题,在此模拟一下这个问题吧。
1、断开primary
down机或是断开网线
2、查看secondary机器的状态
[root@drbd2 ~]# drbdadm role r0
Secondary/Unknown
[root@drbd2 ~]# cat /proc/drbd
version: 8.3.11 (api:88/proto:86-96)
GIT-hash: 0de839cee13a4160eed6037c4bddd066645e23c5 build by root@drbd2.localdomain, 2011-07-08 11:10:20
#注意下drbd2的cs状态
1: cs:WFConnection ro:Secondary/Unknown ds:UpToDate/DUnknown C r-----
ns:567256 nr:20435468 dw:21002724 dr:169 al:229 bm:1248 lo:0 pe:0 ua:0 ap:0 ep:1 wo:b oos:0
因为drbd1宕机了,假如drbd1无法启动,这时就需要手动将drbd2提升为,如下:
将secondary配置成primary角色
[root@drbd2 ~]# drbdadm primary r0
[root@drbd2 ~]# drbdadm role r0
Primary/Unknown
[root@drbd2 ~]# cat /proc/drbd
version: 8.3.11 (api:88/proto:86-96)
GIT-hash: 0de839cee13a4160eed6037c4bddd066645e23c5 build by root@drbd2.localdomain, 2011-07-08 11:10:20
1: cs:WFConnection ro:Primary/Unknown ds:UpToDate/DUnknown C r-----
ns:567256 nr:20435468 dw:21002724 dr:169 al:229 bm:1248 lo:0 pe:0 ua:0 ap:0 ep:1 wo:b oos:0
#挂载
[root@drbd2 ~]# mount /dev/drbd0 /mnt/
[root@drbd2 ~]# cd /mnt/
[root@drbd2 mnt]# ll
total 102524
-rw-r--r-- 1 root root 104857600 Jul 8 12:35 100M
drwx------ 2 root root 16384 Jul 8 12:33 lost+found
#如果原来的primary机器好了,会出现脑裂。
[root@drbd1 ~]# tail -f /var/log/messages
Jul 8 13:14:01 localhost kernel: block drbd1: helper command: /sbin/drbdadm initial-split-brain minor-1 exit code 0 (0x0)
Jul 8 13:14:01 localhost kernel: block drbd1: Split-Brain detected but unresolved, dropping connection!
Jul 8 13:14:01 localhost kernel: block drbd1: helper command: /sbin/drbdadm split-brain minor-1
Jul 8 13:14:01 localhost kernel: block drbd1: helper command: /sbin/drbdadm split-brain minor-1 exit code 0 (0x0)
Jul 8 13:14:01 localhost kernel: block drbd1: conn( NetworkFailure -> Disconnecting )
Jul 8 13:14:01 localhost kernel: block drbd1: error receiving ReportState, l: 4!
Jul 8 13:14:01 localhost kernel: block drbd1: Connection closed
Jul 8 13:14:01 localhost kernel: block drbd1: conn( Disconnecting -> StandAlone )
Jul 8 13:14:01 localhost kernel: block drbd1: receiver terminated
Jul 8 13:14:01 localhost kernel: block drbd1: Terminating receiver thread
[root@drbd1 ~]# drbdadm role r0
Primary/Unknown
[root@drbd2 mnt]# drbdadm role r0
Primary/Unknown
#drbd1现在是standalone,这个时候,主跟辅是不会相互联系的。
[root@drbd1 ~]# cat /proc/drbd
version: 8.3.11 (api:88/proto:86-96)
GIT-hash: 0de839cee13a4160eed6037c4bddd066645e23c5 build by root@drbd1.localdomain, 2011-07-08 11:10:38
1: cs:StandAlone ro:Primary/Unknown ds:UpToDate/DUnknown r-----
ns:20405516 nr:567256 dw:567376 dr:20405706 al:2 bm:1246 lo:0 pe:0 ua:0 ap:0 ep:1 wo:b oos:0
[root@drbd1 /]# service drbd status
drbd driver loaded OK; device status:
version: 8.3.11 (api:88/proto:86-96)
GIT-hash: 0de839cee13a4160eed6037c4bddd066645e23c5 build by root@drbd1.localdomain, 2011-07-08 11:10:38
m:res cs ro ds p mounted fstype
1:fs StandAlone Primary/Unknown UpToDate/DUnknown r----- ext3
这个时候,如果用户有尝试把drbd2的drbd服务重启的话,你就会发现根本无法起来!
[root@drbd2 /]# service drbd start
Starting DRBD resources: [ ]..........
***************************************************************
DRBD's startup script waits for the peer node(s) to appear.
- In case this node was already a degraded cluster before the
reboot the timeout is 120 seconds. [degr-wfc-timeout]
- If the peer was available before the reboot the timeout will
expire after 0 seconds. [wfc-timeout]
(These values are for resource 'fs'; 0 sec -> wait forever)
To abort waiting enter 'yes' [ -- ]:[ 13]:[ 15]:[ 16]:[ 18]:[ 19]:[ 20]:[ 22]:
在drbd2处理方法:
[root@drbd2 /]# drbdadm disconnect r0
[root@drbd2 /]# drbdadm secondary r0
[root@drbd2 /]# drbdadm connect --discard-my-data r0 #这句话表示从主节点同步数据,并且discard自己节点的数据
做完以上三步,你发现你仍然无法启动drbd2上的drbd服务;上次一客户我个人估计就是这个问题,把DRBD重启后,无法启动DRBD。
把他们DBA急的要死。呵呵
需要在drbd1上重连接资源:
[root@drbd1 ~]# drbdadm connect r0
再次启动drbd2上的drbd服务,成了。
[root@drbd2 /]# service drbd start
Starting DRBD resources: [ ].
再看看资源同步:
[root@drbd2 /]# cat /proc/drbd
version: 8.3.11 (api:88/proto:86-96)
GIT-hash: 0de839cee13a4160eed6037c4bddd066645e23c5 build by root@drbd2.localdomain, 2011-07-08 11:10:20
1: cs:SyncTarget ro:Secondary/Primary ds:Inconsistent/UpToDate C r-----
ns:0 nr:185532 dw:185532 dr:0 al:0 bm:15 lo:0 pe:0 ua:0 ap:0 ep:1 wo:b oos:299000
[======>.............] sync'ed: 39.5% (299000/484532)K
finish: 0:00:28 speed: 10,304 (10,304) want: 10,240 K/sec
大伙来拍砖吧!
补充:虽然是手工模拟但在故障切换时也会出一样的问题。
1、DRBD的资源只能在或主或辅的一台机器上挂载。
2、在做主辅的手工切换时的步骤:
a、先将原来挂载的东西进行卸载,这个时候你的应用会停,不建议手工切换主辅
b、将原来的主设置成辅 #drbdadm secondary r0
c、将原来的辅设置成主 #drbdadm primary r0
d、挂载资源
12 附件


13 参考资料
http://os.51cto.com/art/201412/461533_all.htm --这个文档重点看
附件列表
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/28916011/viewspace-2124621/ ,如需转载,请注明出处,否则将追究法律责任。

