一、 前言
最近有一个项目有用到fastdfs分布式文件系统,主要是用它来解决系统的视频和图片等文件的上传和下载效能问题,后来我们对fastdfs应用级的开源分布式文件系统做了一些研究。本次我会给大家详细介绍一下这款开源分布式文件系统相关技术原理,下次会着重介绍如何去搭建一套fastdfs分布式文件系统集群环境。
二、 简介
FastDFS 的开发者是淘宝的架构师余庆所开发,为我们提供了Nginx上使用的FastDFS模块(也可以叫FastDFS的Nginx模块) 。该项目共享到了github上面。可以自行下载下来玩。 项目地址:
FastDFS 是一个轻量级的开源分布式文件系统,主要解决了大容量的文件存储和高并发访问的问题,文件存取时实现了负载均衡。支持存储服务器在线扩容,支持相同的文件只保存一份,节约磁盘。
FastDFS 只能通过Client API访问,不支持POSIX访问方式。
FastDFS 适合中大型网站使用,用来存储资源文件(如:图片、文档、视频等)
FastDFS 为互联网量身定制,充分考虑了冗余备份、负载均衡、线性扩容等机制,并注重高可用、高性能等指标,使用FastDFS很容易搭建一套高性能的文件服务器集群提供文件上传、下载等服务。
三、 FastDFS 系统架构图
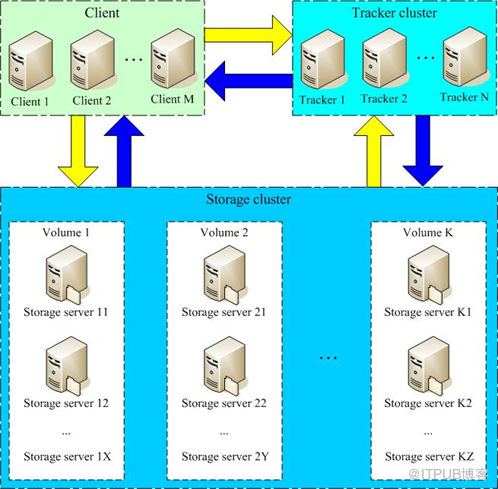
FastDFS 服务端有三个角色:跟踪服务器(tracker server)、存储服务器(storage server)和客户端(client)。
· tracker server :跟踪服务器,主要做调度工作,起负载均衡的作用。在内存中记录集群中所有存储组和存储服务器的状态信息,是客户端和数据服务器交互的枢纽。相比GFS中的master更为精简,不记录文件索引信息,占用的内存量很少。
· storage server :存储服务器(又称:存储节点或数据服务器),文件和文件属性(meta data)都保存到存储服务器上。Storage server直接利用OS的文件系统调用管理文件。
· client :客户端,作为业务请求的发起方,通过专有接口,使用TCP/IP协议与跟踪器服务器或存储节点进行数据交互。
四、 FastDFS 原理
跟踪器和存储节点都可以由一台多台服务器构成。跟踪器和存储节点中的服务器均可以随时增加或下线而不会影响线上服务。其中跟踪器中的所有服务器都是对等的,可以根据服务器的压力情况随时增加或减少。
为了支持大容量,存储节点(服务器)采用了分卷(或分组)的组织方式。存储系统由一个或多个卷组成,卷与卷之间的文件是相互独立的,所有卷的文件容量累加就是整个存储系统中的文件容量。一个卷可以由一台或多台存储服务器组成,一个卷下的存储服务器中的文件都是相同的,卷中的多台存储服务器起到了冗余备份和负载均衡的作用。
在卷中增加服务器时,同步已有的文件由系统自动完成,同步完成后,系统自动将新增服务器切换到线上提供服务。当存储空间不足或即将耗尽时,可以动态添加卷。只需要增加一台或多台服务器,并将它们配置为一个新的卷,这样就扩大了存储系统的容量。
FastDFS 中的文件标识分为两个部分:卷名和文件名,二者缺一不可。
FastDFS 只有两个角色:Tracker server和Storage server。Tracker server作为中心结点,其主要作用是负载均衡和调度。Tracker server在内存中记录分组和Storage server的状态等信息,不记录文件索引信息,占用的内存量很少。另外,客户端(应用)和Storage server访问Tracker server时,Tracker server扫描内存中的分组和Storage server信息,然后给出应答。由此可以看出Tracker server非常轻量化,不会成为系统瓶颈。 五、 文件上传和下载的交互过程
上传机制
上传流程: 客户端(client)询问Tracker server上传到的Storage server
1.client->Tracker server( 返回一台可用的Storage server,返回的数据为该Storage server的IP地址和端口)
2.client 直接与返回的Storage server建立连接->文件上传成功后->Storage server会返回新生成的文件ID->结束
下载机制:
下载流程: 客户端(client)询问Tracker server下载Storage server上面文件
1. client 询问Tracker server可以下载指定文件的Storage server,参数为文件ID(包含 卷 名和文件名);
2. Tracker server 返回一台可用的Storage server;
3. client 直接和该Storage server建立连接,完成文件下载。
需要说明的是,client为使用FastDFS服务的调用方,client也应该是一台服务器,它对tracker和storage的调用均为服务器间的调用。
五、 FastDFS 与集中存储方式对比
fastdfs 与集中式存储的对比通过这两个指标显示体现出它的优势,FastDFS分布式文件系统解决了集中式存储无法在线扩容的问题,由于集中式存储的热备带来高昂费用,而使用fastdfs大降低了成本。而fastdfs的高并发也要比集中式存储性能强很多。
六、 总结
1 、高可靠性,无单点故障;
2 、高吞吐量,只要 Group 足够多,数据流量是足够分散的;
3 、 文件上传和删除等操作,使用FastDFS client API,目前提供了C、PHP extension和Java的client API ;
4 、文件下载采用HTTP方式,使用nginx或者apache扩展模块,不推荐使用FastDFS内置的web server ;
5 、磁盘不需要RAID,直接挂载单盘,每个硬盘作为一个mount point,提升磁盘整体IO吞吐量 ;
6 、 跟踪服务器 的性能非常高,一个较大的集群(比如上百个group)中有3个节点就能满足生产需求。 ;
7 、比较遗憾的是它没有python的接口 ;
8 、上传的文件不会分块存储,它和OS系统中的文件是一一对应 ;
9 、支持在线扩容,支持主从文件 。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/28833846/viewspace-2723374/ ,如需转载,请注明出处,否则将追究法律责任。

