过去两年,AI基础设施的叙事几乎被GPU垄断。算力即Token,Token即性能,每秒Token数、每瓦Token数、每美元Token数构成了业界最顺手的标尺。
然而,当AI从回答问题走向完成任务,当智能体开始持久保持状态、检索上下文、调用工具、执行代码并循环推进,这套标尺正在失效。当CPU重新回AI数据中心C位,我们该用什么尺子量它?
近日,Arm联合富士通、Meta、OpenAI发布方法论白皮书,并由独立分析机构Signal65出具对比报告。Arm云AI解决方案架构总监Ravi Malhotra表示,我们不仅要从Token的角度评估性能,还要从智能体及其所执行任务的角度来评估性能。
五类用例:没有两个智能体是一样的
Ravi Malhotra梳理了五类热门智能体AI用例:软件工程、企业自动化、科学研究、个人助理、机器人技术。这五类用例并非随意挑选,其依据是行业研究,更重要的是,这五类用例对CPU的需求截然不同。
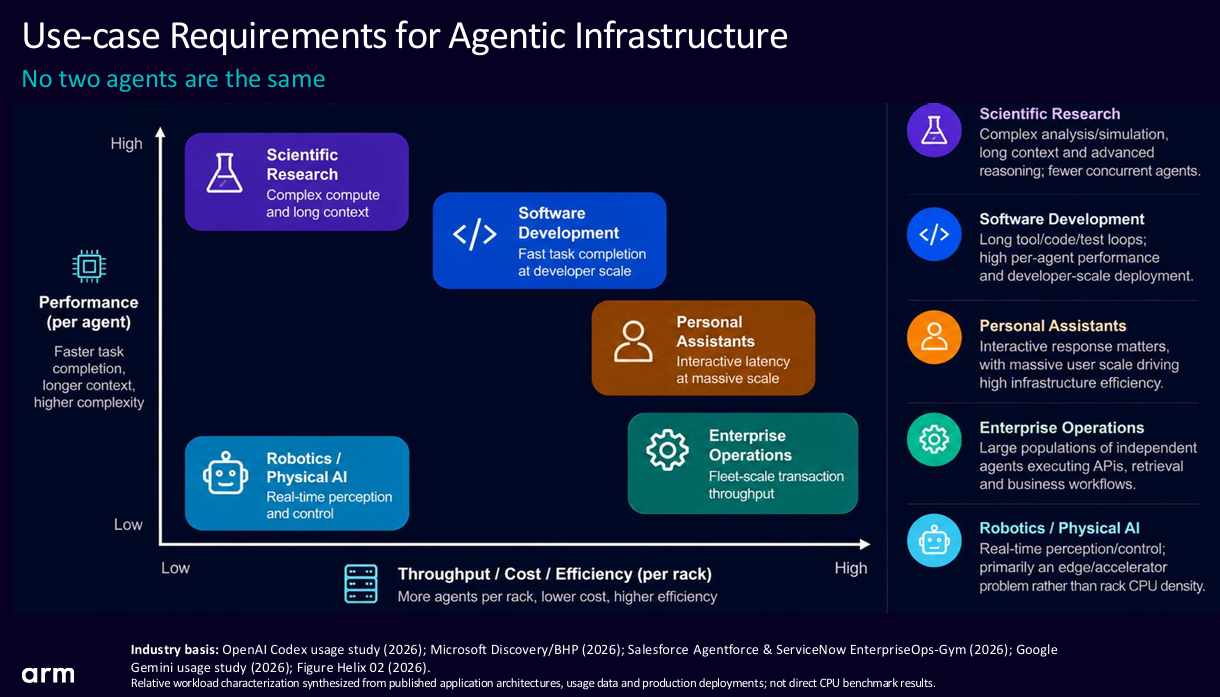
软件开发场景中,编译和测试代码耗时较长、消耗大量CPU周期,单个智能体的性能至关重要;个人助理或企业运营场景中,单次操作往往持续时间短,例如访问网页或数据库,对单智能体性能要求不高,但操作数量庞大,反而对吞吐量和运行效率提出更高要求。
因此,没有两个智能体是完全一样的。这句话直接否定了“一颗CPU打天下”的选型逻辑,Arm不建议为某一类用例赋予特定权重,客户应判断自己的用例属于哪一类原型,再选择相应的端到端智能体基准和组件。
笔者看来,这实际上是对当前智能体CPU基准“各自测量宇宙”现象的一种回应。当Arm、AMD、Intel各自使用不同的负载原型、部署拓扑和聚合口径时,行业是离公共标准更近还是更远?
Ravi Malhotra的答案是:Arm提出的是一套评测方法论,而非正式行业标准或单一基准测试,旨在为业界提供一个切实可行的起点。Arm不争当裁判,而是提供一套可复用的“考试大纲”。
两层方法论:组件基准与端到端基准缺一不可
Arm方法论的核心分为两部分。其一是从组件角度出发的基准测试,测试Web服务器、数据库或模型服务的开销,精确了解单个组件的表现;其二是端到端智能体基准测试,为评估端到端的智能体工作流提供具有代表性的参照。Ravi Malhotra强调,组件基准无法反映这些组件在智能体工作流中如何连接并协同运行,因此两者必须配合。
这套两层结构对应着CPU在不同环节的角色差异。工具调用类组件侧重IPC、I/O和并发;编排角度更强调CPU并发和利用率;推理与规划中CPU充当头节点,重点测试单线程性能能力,包括分支预测、缓存、内存延迟和内存带宽。
而在端到端层面,评估更关注可扩展性和并发性,性能评估不能只看单颗CPU能够承载多少智能体,也不能单纯追求最高吞吐量,还需要在吞吐量与SLA要求之间取得平衡。这就是Arm强调的持续性能。
Ravi Malhotra举例表示,对于Terminal-Bench和SWE-bench所代表的软件开发工作负载,每个核心运行一到两个智能体可能已经足够,进一步增加并发智能体数量则可能无法满足SLA要求;企业运营或个人助理类工作负载可以支持更多并发智能体。关键仍在于平衡吞吐量与SLA,这要求兼顾单核性能和整颗CPU的扩展能力。
机架级视角:为什么不能只看单芯片
Signal65报告的对比结果按类别展开:智能体工具调用场景,Arm AGI CPU每机架性平均能达到AMD EPYC(霄龙)9755的1.7倍;向量数据库、缓存等推理与规划类应用达到2.2倍;端到端智能体基准结果为2倍;七项工作负载平均1.99倍。
在每核以及CPU SoC层面,Arm AGI CPU平均约高出对比平台20%。此外,相较AMD EPYC(霄龙)9965,Arm AGI CPU最多可将沙箱创建时延降低45%。
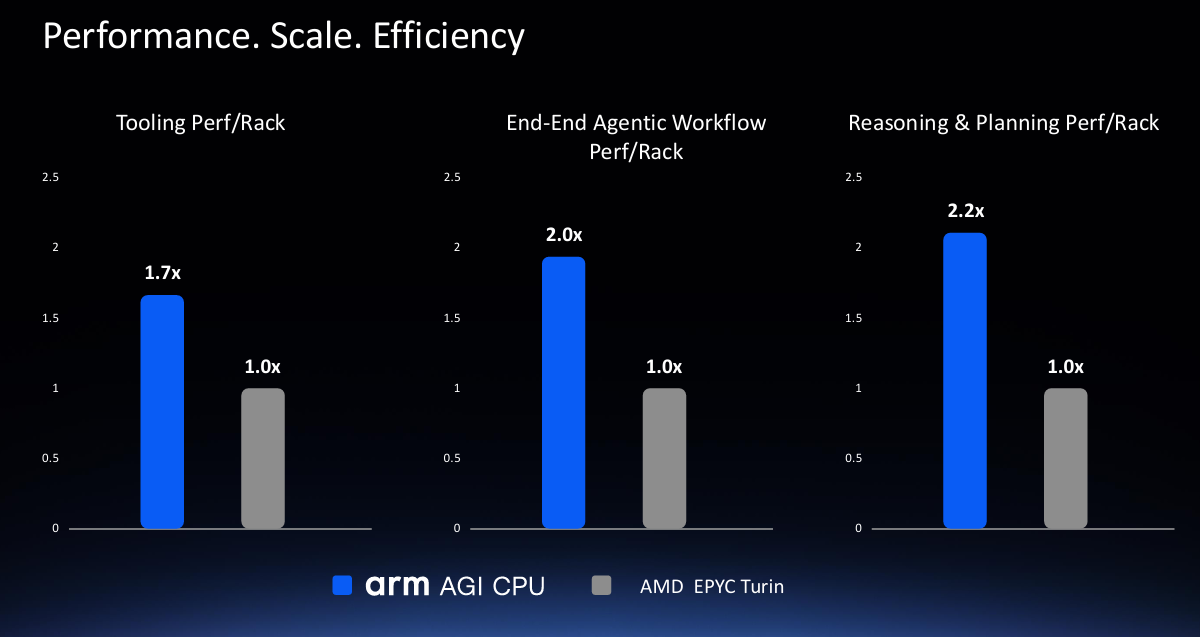
这些数字背后有一套明确的工程逻辑。Ravi Malhotra解释,Arm AGI CPU的关键优势不仅在于性能,还在于效率和可扩展性:每个核心功耗更低,相同机架功耗预算下可以部署更多核心;将每核及每颗CPU的性能,与每机架更多的核心数量结合起来,就带来了约2倍的机架级性能优势。换言之,1.99倍不是单核性能的胜利,而是“每核性能×每机架核心数”的乘积效应。
客户在数据中心里部署和使用的是整个机架,而不仅仅是单颗CPU;只对比一颗CPU与另一颗CPU,就无法衡量能效、内存利用效率、服务器成本和功耗,以及单个机架能够容纳多少台服务器或多少颗CPU。
AGI CPU的优势不在于打造规格最高的CPU,而在于兼顾核心层面的性能、服务器层面的可扩展性和机架层面的效率。这是一个值得行业重视的视角转换。
数据中心始终受到功耗、散热和物理空间的固定限制,基础设施运营商最终需要了解的是系统在这些限制内能够持续完成多少有效工作。
Arm CPU更注重性能、规模和效率之间的平衡,而x86架构或其他CPU通常倾向于强调其中某一项参数,单芯片跑分与机架级交付性能,本来就是两种语言。
效率从何而来:三十年底层积累与云工作负载调优
Arm CPU的效率优势从何而来?Ravi Malhotra的回答指向两个层面。低功耗一向是Arm CPU设计的核心,也是其三十多年来的优势所在。
2018年推出Arm Neoverse系列时,Arm便与超大规模云服务提供商紧密合作,了解云端通常运行哪些工作负载,SQL数据库、缓存、机器学习、推理、视频解码、视频编码等,并据此专注改进核心架构和网格互联架构。
从Neoverse N1到Neoverse V3,微架构持续改进,而Neoverse V3正是Arm AGI CPU的核心,设计原则是在提升性能的同时不以增加功耗为代价。
这套叙事的关键在于针对性调优。Arm没有试图做一颗全能芯片,而是围绕云工作负载和数据中心大规模运行的工作负载做微架构优化。
沙箱开销是一个容易被低估的细节。出于数据和隐私考虑,用户希望每个智能体都在隔离环境中执行,但创建沙箱并让它准备好运行任务需要时间,即便以毫秒计,其影响也可能相当可观。
Arm测试了冷创建、热创建以及多个容器在同一物理核上并行运行的超额订阅场景,发现Arm AGI CPU上的开销成本远低于AMD EPYC处理器。在企业运营这类高并发、每核运行多个智能体的场景中,沙箱开销越低,系统在相同时间内能处理的客户支持工单就越多,进而降低单个任务成本。这是“持续性能”概念在成本层面的直接兑现。
笔者观察:一套“考试大纲”能否成为行业通用语言?
CPU性能评估的坐标系正在从“Token生成”迁移到“任务完成”,从“单芯片峰值”迁移到“机架级持续性能”。智能体AI没有淘汰CPU,而是给CPU出了一张新考卷。
Arm率先交卷,并试图把自己的答题思路推广为评分标准。至于这张考卷最终由谁来阅卷,答案不在今天,而在未来几年超大规模数据中心真实的功耗账单和SLA报表里。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/28285180/viewspace-3186955/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 企业 IT 基础设施的“技术路线图”怎么定?
- 数据中心的“运维交接”为什么容易出问题?
- 企业级存储跨站点复制:带宽规划背后的成本与 RPO/RTO 平衡
- 企业级芯片的“虚拟化”支持:VT-d、SR-IOV 与 IOMMU
- 数据中心的“消防气体”选择与人员安全:七氟丙烷、IG541与全氟己酮的技术路线之争
- 企业级存储的“数据去重”边界:哪些场景不适用?
- AI基础设施的“推理服务编排”:决定大模型应用成本与体验的隐形战场
- 企业级服务器的“内存故障”与“RAS 特性”:看不见的错误,才是关键业务的真正威胁
- 数据中心的“噪声治理”与“职业健康”:被忽视的机房隐形风险
- 企业级存储的“数据销毁”与“介质退役”:一场被低估的合规硬仗
