Trino分析引擎 | 滴普科技FastData系列解读
在之前的FastData连载文章中,介绍“统一SQL引擎”时提到了Trino,本文 对Trino+ Iceberg技术做相关介绍。
Trino是针对OLAP设计的用于高效的分布式查询大量数据的分析引擎。主要具备下列优点:屏蔽底层数据源,提供统一查询接口;基于内存计算,可以跨不同数据源完成联邦查询;数据治理,通过Trino进行异构数据的提取、整合与分析,打破数据孤岛、提高数据治理能力。
一、Trino 架构
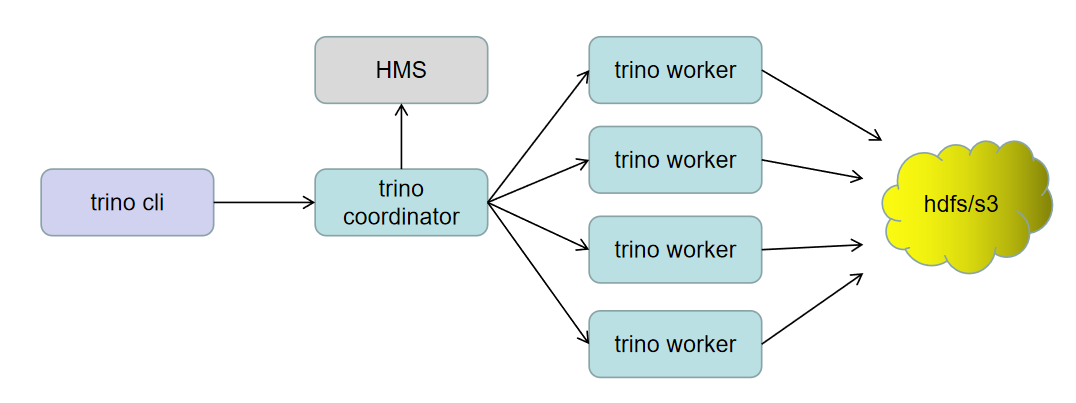
Trino的架构如图一所示。由一个coordinator和多个worker节点组成的Trino集群。Trino用户通过一个客户端连接到coordinator。coordinator与访问数据源的worker进行协作。一旦它接收到一条SQL语句,协调器就负责跨Trino工作节点解析、分析、计划和调度查询执行。该语句被转换为运行在一组worker上的一系列连接的任务。当worker处理数据时,coordinator将检索结果并在输出缓冲区上向客户机公开。
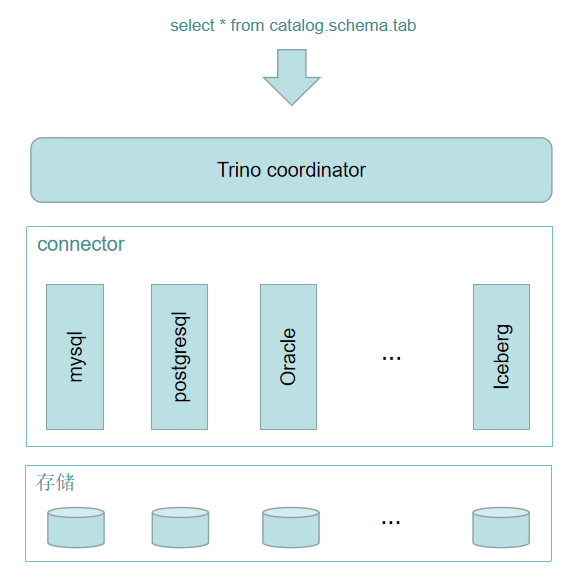
在Trino中,存储和计算分离的核心是基于connector的体系结构。connector为Trino提供了访问任意数据源的接口。如图二所示,每个connector都提供了对底层数据源的基于表的抽象。只要可以使用Trino可用的数据类型以表、列和行来表示数据,就可以创建connector,查询引擎就可以使用数据进行查询处理。目前支持的connector包括:Hive, Iceberg, MySQL, PostgreSQL, Oracle, SQL Server, ClickHouse, MongoDB等。
二、Trino iceberg connector
Iceberg 是一种用于跟踪超大规模表的,构建于存储格式之上的数据组织方式。通常将其作为数据湖底层存储。它具备下列能力:
- 模式演化:支持添加,删除,更新或重命名,并且没有副作用
- 支持隐藏分区和分区演化,方便业务进行数据分区策略更新。
- 快照控制:可实现使用完全相同的表快照的可重复查询,或者使用户轻松检查更改
- 版本回滚:使用户可以通过将表重置为良好状态来快速纠正问题
- 快速扫描数据:无需使用分布式SQL引擎即可读取表或查找文件
- 数据修剪优化:使用表元数据使用分区和列级统计信息修剪数据文件
- 兼容性好:可以存储在任意的云存储系统和HDFS中
- 支持事务:上游数据写入即可见,不影响当前数据处理任务,这大大简化了 ETL。
- 高并发:高并发写入器使用乐观并发,即使写入冲突,也会重试以确保兼容更新成功。
此外,Iceberg支持通过流式方式读取增量数据。支持多种引擎,并且提供了java native API,不用特定引擎也可以访问Iceberg表。
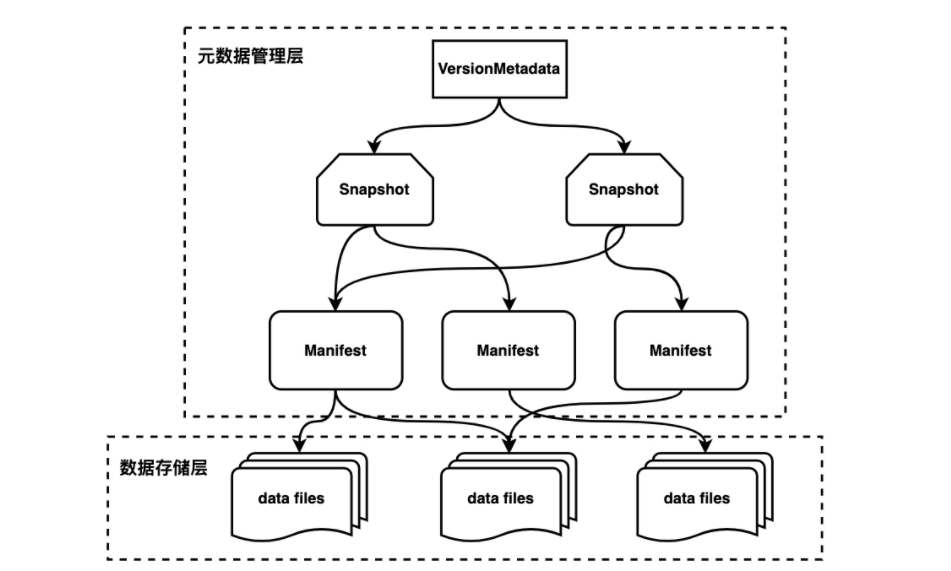
Trino 引入Iceberg connector的设计改进了Hive已知的可伸缩性限制。Hive将表元数据存储在一个metastore中,该metastore由关系数据库(如MySQL)支持。它跟踪分区在metastore的位置,但无法定位到单独的数据文件。使用Hive connector的Trino查询必须首先调用metastore来获取分区位置,然后调用底层文件系统来列出每个分区内的所有数据文件,然后从每个数据文件中读取元数据。在文件量大的情况下,这是一个非常耗时的操作。
Iceberg提供了表级别的抽象接口,自己在文件中维护表的元数据信息(而非通过Hive Metastore维护),基于此,Iceberg对于表的元数据管理以及表数据本身如何组织存储进行了封装(如图三所示),查询可以定位到文件级别,大幅提高了查询效率。
此外,Trino iceberg connector在查询优化方面支持分区下推,Projection 下推,动态过滤等提高查询效率。
三、总结
为了获取更高的查询性能,Trino可以将查询或部分查询的处理下推到连接的数据源中。这意味着特定的谓词、聚合函数或其他操作被传递到底层数据库或存储系统进行处理;另一方面可以通过添加索引的方式,加快查询。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/26692020/viewspace-3131510/ ,如需转载,请注明出处,否则将追究法律责任。

