SIGMOD21 ArkDB: A Key-Value Engine for Scalable Cl
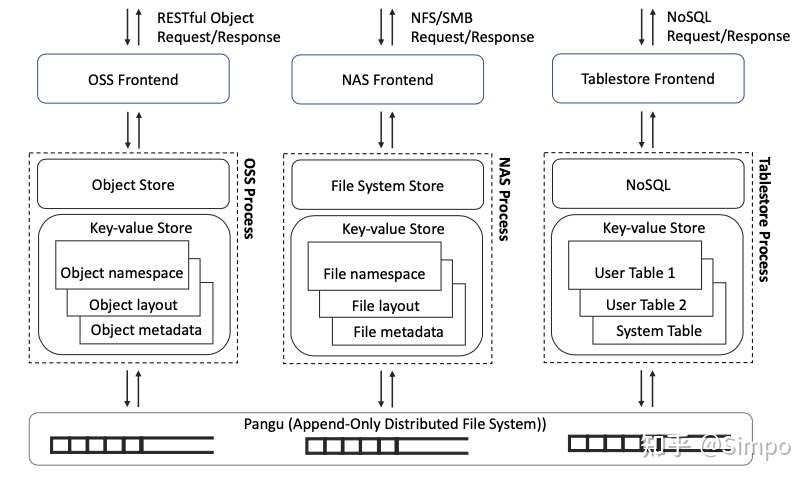
在Alibaba-Cloud,对象存储服务、文件存储服务和表存储等扩展云存储服务都建立在分布式键值存储的基础上。这些服务的底层键值引擎的设计面临的主要挑战是如何利用分解存储、支持写和范围查询繁重的负载,以及平衡可伸缩性、可用性和资源使用。本文介绍了ArkDB,一个键值引擎,旨在通过结合LSM树和bw树的优点,(对bw tree不了解的可以先参考下面这篇论文)
并利用硬件技术的进步来解决这些挑战。ArkDB建立在盘古(一个append-only的分布式文件系统)之上。ArkDB的创新包括减少页面映射表,清晰的系统和用户状态分离以快速恢复,减少写放大,高效的垃圾收集和轻量级的分区拆分和合并。
架构
用户事务的数据更改记录在 UserTransactionLog 中,并在提交时应用于Active的 MemoryBuffer (❶)。 MemoryBuffer 支持point查找和有序范围扫描。 一旦Active MemoryBuffer 中的数据量达到阈值,例如 64 MB,这个 MemoryBuffer 就会被sealed,并打开一个新的 MemoryBuffer 以接受新的修改。 Sealed MemoryBuffer 被刷新到存储中 (❷)。 此刷新操作称为获取用户checkpoint。 存储的主干结构是一棵 B+ 树。 对于用户checkpoint,同一叶子page的数据更改形成了Host page的Delta Page。 Delta Page被写入 DeltaPageStream。 通过从Host Page到添加到 PageMappingTable 的这个 delta page的页面映射,一个 delta page被间接地挂接到 B+ 树中。
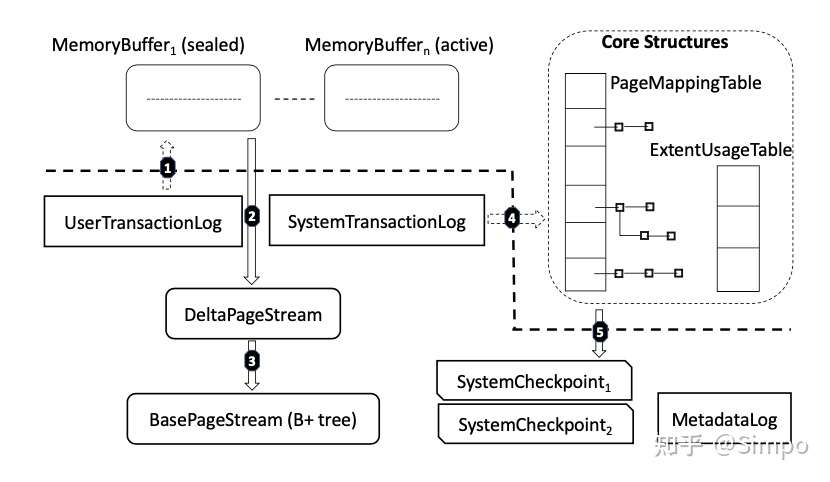
当Leaf Page的Delta Page数达到阈值时,该Leaf Page及其更改被压缩到单个连续Page中。稍后,该页面的存储位置将更新到父页面,导致父页面被重写。同样地,从旧的父页面映射到重写的父页面的页面被添加到PageMappingTable中。这个映射意味着父节点的实际内容现在位于重写的父节点页面中。更新了父页面后,可以删除压缩页的页面映射项。通过这种方式,ArkDB有效地收缩了PageMappingTable。当一个Host Page被压缩时,它可能被重写为多个页面,在这种情况下,它表示一个 Page Split。紧凑的叶页和重写的父页都被称为钩在B+树中的基页,并被写入BasePageStream中。
页面映射更改作为系统事务执行,并记录在SystemTransactionLog中。只有在系统事务日志记录被持久化之后,对PageMappingTable的更改才会被应用(❹)。从概念上讲,DeltaPageStream、BasePageStream和PageMappingTable一起形成了一个存储上的Bw-tree,这是一个B+树的变体,在只追加的存储上有Delta Page。通过合并来自MemoryBuffers和存储上的Bw-tree的结果来回答查询。
随着用户检查点、页面压缩和页面拆分或合并,DeltaPageStream和BasePageStream中的extent也会被消耗掉。当一个页面被重写时,该页面先前写入的部分将失效。每个extent的确切有效用法在ExtentUsageTable中被跟踪,在DeltaPageStream和BasePageStream的垃圾收集期间会参考这个表。当ExtentUsageTable占用的内存达到一个阈值时,历史使用数据会被压缩,并溢出到存储(实际上是BasePageStream),以控制表内存占用低于一个阈值。
当系统事务日志大小达到阈值时,PageMappingTable和ExtentUsageTable都会被刷新到系统检查点。在获取系统检查点之后 (❺) ,它的元数据(包括时间戳和位置)被记录到MetadataLog中。恢复从MetadataLog指示的最近的系统检查点开始。分区拆分或合并操作也记录在MetadataLog中,以指导恢复。
核心设计
Page Mapping Maintenance
原始的Bw-tree使用8字节的逻辑页面id,这些id存储在父页面中。总是搜索页面映射表,以找出子页面在内存或存储中的位置。据我们所知,没有一种现有的方法可以有效地缩小这样一个页面映射表,以保持它的内存占用小。此外,对于每个页面ID,页面最老的位置和一些其他统计信息需要留在内存中,否则,垃圾收集可能会导致显著的性能损失。为了降低PageMappingTable(一个并发哈希表)的大小,ArkDB使用物理页ID (PID),由(ExtentID, Offset, PageSize)表示,无需搜索页面映射表找到数据的位置。
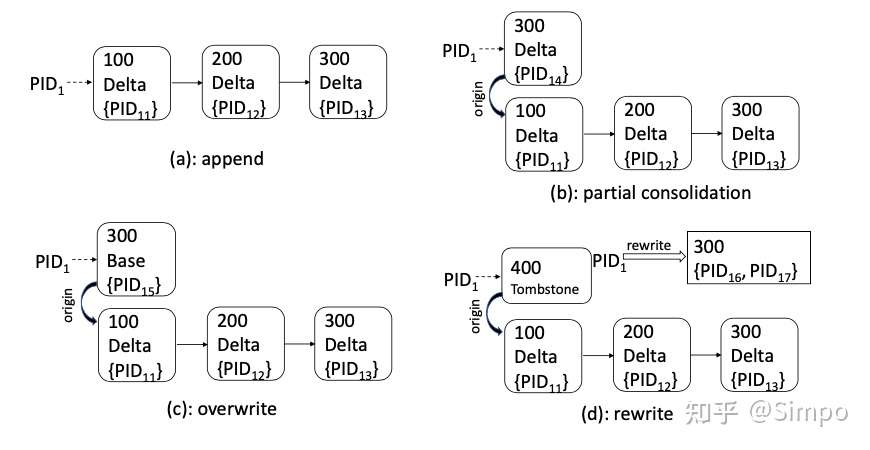
当页面的增量链长度达到阈值(例如,3)时,该页面就会被压缩,例如,在时间戳为400的系统事务中。如果增量页的总大小与基本页大小之间的比例未达到阈值(例如25%),则会压缩除Base Page本页之外的Delta Page。这被称为 partial consolidation ,它可以避免在该比率很小的时候出现过度的写放大。
如果Delta Page的总大小与Base Page大小之间的比率达到阈值,则将所有页面压缩到一个新的Base Page中,以覆盖(overwrite)旧的Base Page。
如果所有的Delta Page和Base Page都被压缩生成多个新的Base Page,并且数目达到一个阈值(例如2),旧的基本页被改写(rewrite)成几个新的Base Page。
GC
ArkDB将增量页放入DeltaPageStream,将基本页放入BasePageStream。与基本页面不同,增量页面的寿命相对较短,而且往往较小。这种热数据和冷数据的分离减少了GC引起的写放大。 当一个sealed extent的垃圾率达到阈值时,该盘区就成为GC候选。 DeltaPageStream 中的extent比 BasePageStream 中的extent具有更高的 GC 阈值。
与用户检查点和页面压缩类似,GC在系统事务中完成。GC系统事务用提交时间戳的Delta Page检查底层B+树的snapshot,决定snapshot的extent上哪些页仍然有效,将这些页重定位到DeltaPageStream或BasePageStream的尾部,最后写入日志记录提交事务,并将更改应用到PageMappingTable。
为了向 GC 提供范围使用的snapshot查询,ArkDB 通过维护内存数据结构 ExtentUsage 来跟踪每个extent的使用历史
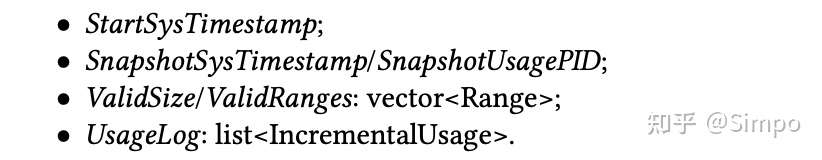
Delta Page往往很小。用于跟踪Delta Page的内存使用量可能非常大。此外,由于页面rewrite,Delta Page可以重新分发,因此一个增量页面可以出现在多个增量链中,如图5-(b)所示。这使范围使用变化历史的记录变得复杂。因此,对于DeltaPageStream中的extent,ArkDB只选择跟踪有效的大小。Base Page往往很大,而且从不出现在多个链中。因此,对于BasePageStream中的extent,ArkDB会跟踪有效偏移量和大小的变化历史。
GC Flow
ArkDB维护一个全局的GCSnapshotTimestamp,它会随着GC回合的推进而不断前进。每一轮都在一个GC系统事务中完成,该事务使用当前的GCSnapshotTimestamp作为其快照读取时间戳,并查询每个extent的总有效数据大小,以决定候选的GC extent。可以通过搜索内存中的Extentusage来快速回答这个查询。
对于BasePageStream中的每个候选对象,将搜索内存中的extentUsage,并将结果与位于BasePageStream中的SnapshotUsagePID的ValidRanges合并。对于DeltaPageStream中的所有候选对象,PageMappingTable只扫描一次,以构造GC SnapshotTimestamp的有效范围。在此过程中,还会找到包含有效Delta Page的页面映射链。
将有效extent内的数据加载到内存后,就会识别出有效的页面。对于每个有效页面,包含该页的页面映射链将被重新定位,并对该页(可能是部分)进行碎片整理。对PageMappingTable和ExtentUsage的所有更改都在GC系统事务的日志记录中捕获,并在事务提交时应用。
Two-level Snapshot
为了支持快照隔离,ArkDB实现了多版本并发控制,而不需要在每个键值存储版本号的空间开销。ArkDB有两个时间戳生成器,分别用于用户事务和系统事务。对于一个系统事务,它的提交时间戳SysTxTimestamp是在事务从系统事务时间戳生成器中启动时获得的,它的快照读取时间戳是基于SysTxTimestamp分配的。对于用户事务,它的提交时间戳UserTxTimestamp是在从用户事务时间戳生成器提交事务时获得的,它的快照读取时间戳是基于SysTxTimestamp和UserTxTimestamp分配的。对于一个SysTxTimestamp ,假设所有时间戳不大于 的系统事务已经提交,并且在所有的MemoryBuffers中,MemoryBuffer 的时间戳最大不大于 ,除了 刷新到存储的更改之外,所有新的数据更改都可以在MemoryBuffer 和后续的MemoryBuffers中找到。
ArkDB维护MaxCommittedSysTxTimestamp和MinUncommittedUserTxTimestamp,当一个系统事务(GC除外)启动时,它的快照读时间戳被设置为MaxCommittedSysTxTimestamp。当用户事务开始时,它的快照读时间戳设置为(MaxCommittedSysTxTimes- timestamp, MinUncommittedUserTxTimestamp - 1)。
页面映射项被标记为系统事务时间戳,Delta Page Chain被增强为二维(多个链)。
MemoryBuffers中的键值被标记为UserTxTimestamps,以支持MemoryBuffers中的快照查询。为了支持跨多个分区的读写事务,实现了两阶段提交。为了进一步支持跨多个分区的快照查询,每个跨分区事务需要一个全局时间戳,这个时间戳可以以分布式的方式分配。但是,分区本地事务不需要全局时间戳。在任何情况下,存储(Page)上的键值都不需要嵌入版本号。
Two-Level Restart Recovery
在重新启动时,读取MetaDataLog以定位加载PageMappingTable和extentUsageTable的最近的系统检查点。然后从SysTxReplayStartPoint开始的SystemTransactionLog被重放,以应用对PageMappingTable和ExtentUsageTable的更改。B+树根页PID包含在系统检查点中,并记录在系统事务日志记录中,因此在系统日志重放时恢复。
从最近的用户checkpoint日志记录中获取UserTxReplayStartInfo (MinUncommittedUserTxTimestamp, UserTxReplayStartPoint),从UserTxReplayStartPoint开始UserTransactionLog的replay,跳过时间戳小于MinUncommittedUserTxTimestamp的用户事务。
传统的基于B+树的存储引擎记录用户和系统事务,并记录post-images以进行页面拆分或合并,除非强制执行一个仔细的页面写入顺序,因此扫描更多的日志以进行重启恢复,而ArkDB不记录这种post-image。原来的Bw-tree设计混合了系统事务日志和数据,因此它的恢复扫描最新存储检查点之后的数据。ArkDB不需要扫描数据流进行恢复。
Lightweight Partition Split and Merge
ArkDB支持范围分区,每个分区都是工作分配和负载均衡的单元。利用文件系统硬链接功能,避免分区分裂/合并时的数据复制。
分区拆分和合并协议与[1]中描述的类似。将父分区拆分为两个子分区或将两个分区合并为一个分区要经过预拆分或合并阶段,以便为子分区准备文件流。然后,通过通过分裂或合并父B+树重新启动恢复来启动每个子分区。重新启动子分区恢复后,完成分区分裂或合并。
预分裂/合并:每个分区在分布式文件系统上都有一个目录,该目录存储它的所有文件流。对于分区拆分或合并,存在一个子目录来保存到父分区的文件流硬链接。一旦在父分区上启动了子分区的准备工作,就不能启动新的系统事务。在完成包括用户检查点在内的现有系统事务之后,将强制执行一个系统检查点。然后,来自父分区的system检查点和UserTransactionLogs被硬链接,父分区的DeltaPageStream和BasePageStream中的extent分别连接到子分区的DeltaPageStream和BasePageStream中。在这个过程中,ArkDB仍然接受用户事务,因此新的extent可以附加到UserTransactionLogs。接下来,将日志记录写入新创建的子分区的MetaDataLog中,以指示其重新启动恢复运行分区拆分或合并。最后,关闭父分区。
分裂/合并Recovery:在重新启动子分区恢复之前,父分区UserTransactionLogs中新写入的extent被连接到子分区到父分区的硬链接中,Recovery首先从父分区加载SystemCheck- points来初始化PageMappingTable(和ExtentUsageTable)。在分区分裂的情况下,在恢复期间不会维护extentusagtable,而是从头重新构建。
- 在分区分裂的情况下,对于父B+树的每一级的边界页,将提取属于子分区的键范围的记录,并将其写入新页面,该页面链接到子B+树。
- 在进行分区合并的情况下,两个父B+树的同一级别的边界页面被合并,成为子B+树的同一级别的页面。
- 对于分区拆分和合并,将为每个子B+树生成一个新的根页,并写入一个系统事务日志记录以指示新的根页PID。在分区合并的情况下,边界页的合并将更新extentusagtable。这样的更新在同一系统事务日志记录中捕获。
然后回放每个父分区的UserTransactionLog尾部,将更改应用到子分区的MemoryBuffers中。在分区分裂的情况下,只应用属于子分区的键范围的更改。在文件流准备期间,如果我们选择不允许用户写,那么应该在系统检查点被占用之前刷新活动的MemoryBuffer,并且不需要UserTransactionLog重放。在恢复结束时,到父分区的文件流硬链接被删除,子分区开始接受新的用户事务。
Post Recovery Processing:从split开始后,子分区对恢复的最大SysTxTimestamp的B+树索引页进行后台扫描,以:(1)定位并删除不属于子分区键范围的页面映射项,(2)根据扫描结果,结合(1)中更新的PageMappingTable,为父分区的区段重建extentusagtable。
在分裂/合并的子分区被分裂或再次合并之前,ArkDB确保在恢复期间生成的所有MemoryBuffers已经被刷新,然后一个新的系统检查点已经被占用(在分裂的情况下,包括更新的PageMappingTable和重建的ExtentUsageTable)。这样,要分割或合并的分区就不依赖于它自己的父分区。
参考文献
[1] BradCalder,JuWang,AaronOgus,NiranjanNilakantan,ArildSkjolsvold,Sam McKelvie, Yikang Xu, Shashwat Srivastav, Jiesheng Wu, Huseyin Simitci, Jaidev Haridas, Chakravarthy Uddaraju, Hemal Khatri, Andrew Edwards, Vaman Be- dekar, Shane Mainali, Rafay Abbasi, Arpit Agarwal, Mian Fahim ul Haq, Muham- mad Ikram ul Haq, Deepali Bhardwaj, Sowmya Dayanand, Anitha Adusumilli, Marvin McNett, Sriram Sankaran, Kavitha Manivannan, and Leonidas Rigas. 2011. Windows Azure Storage: a highly available cloud storage service with strong consistency. In Proceedings of the 23rd ACM Symposium on Operating Systems Principles 2011, SOSP 2011, Cascais, Portugal, October 23-26, 2011, Ted Wobber and PeterDruschel(Eds.).ACM,143–157. https://doi.org/10.1145/2043556.2043571
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/26692020/viewspace-3120764/ ,如需转载,请注明出处,否则将追究法律责任。

