xapian搜索系统存储结构解读
Xapian的database是所有用于检索的信息表的集合,以下的表是必需的:
- posting list table 保存了被每一个term索引的document,实际上保存的应该是document在database中的Id,此Id是唯一的。这个就是倒排表。
- record table 保存了每一个document所关联的data,data不能通过query检索,只能通过document来获取。这个相当于快照。
- term list table 保存了索引每个document的所有的term。这个相当于正排表。
- position list table 保存了每一个Term出现在每一个document中的位置。就是term位置表。
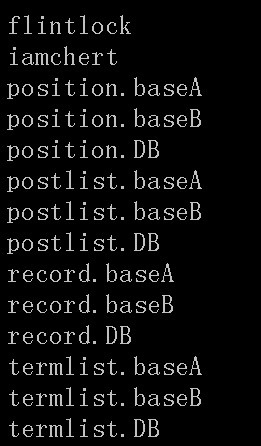
term可以用作有效地查找它的posting list,在posting list里,每一个document带有一个很短的标识符,就是document id。简单来说,一个posting list可以被认为是一个由document ids组成的集合。而term list则是一个字符串组成的集合。在某些IR系统的内部是使用数字来表示term的,因此在这些系统中,term list则是数字组成的集合,而Xapian则不是这样,它使用原汁原味的term,而使用前缀来压缩存储空间。
一个例子:
    Xapian::Document doc;
    doc.add_term("K你好");
    doc.add_term("K那里");
    //posting是带position的term
    doc.add_posting("K吃饭", 14);
    doc.add_posting("K玩耍", 8);
    /*
    这里最好先用一个map<string, int>放置value的名称和索引的配对
    这里使用起来像Lucene的SortField一样了。
    */
    doc.add_value(1, "1");
    doc.set_data("你好啊,在那里玩耍呢?还没吃饭吗?");
    //创建一个可写的db
    Xapian::WritableDatabase db("c:\\db");
    //将document加入到db中,返回document的id,此id在db中是唯一的
    Xapian::docid id = db.add_document(doc);
    //刷新到硬盘中
db.flush();//获取
Xapian::Document doc = db.get_document(id);
string v = doc.get_value(1);
printf(v);//输出
string data = doc.get_data();
printf(data);//输出"你好啊,在那里玩耍呢?还没吃饭吗?"
for (Xapian::TermIterator iter = doc.termlist_begin(); iter != doc.termlist_end(); ++iter)
{
printf(*iter);//依次输出term和posting
}
读取倒排列表(posting table的例子)
相关的类主要有两个,一个是PositionIterator,一个是PostingSource
其中
PositionIterator用来遍历一个term的所有docid列表
PostingSource则用来提供postings的扩展数据资源。来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/26692020/viewspace-3118927/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
