分区表
简介
分区表是在SQL SERVER2005之后的版本引入的特性。这个特性允许把逻辑上的一个表在物理上分为很多部分。而对于SQL SERVER2005之前版本,所谓的分区表仅仅是分布式视图,也就是多个表做union操作.
分区表在逻辑上是一个表,而物理上是多个表.这意味着从用户的角度来看,分区表和普通表是一样的。这个概念可以简单如下图所示:

而对于SQL SERVER2005之前的版本,是没有分区这个概念的,所谓的分区仅仅是分布式视图:

本篇文章所讲述的分区表指的是SQL SERVER2005之后引入的分区表特性.
为什么要对表进行分区
在回答标题的问题之前,需要说明的是,表分区这个特性只有在企业版或者开发版中才有,还有理解表分区的概念还需要理解SQL SERVER中文件和文件组的概念.
对表进行分区在多种场景下都需要被用到.通常来说,使用表分区最主要是用于:
-
存档,比如将销售记录中1年前的数据分到一个专门存档的服务器中
-
便于管理,比如把一个大表分成若干个小表,则备份和恢复的时候不再需要备份整个表,可以单独备份分区
-
提高可用性,当一个分区跪了以后,只有一个分区不可用,其它分区不受影响
-
提高性能,这个往往是大多数人分区的目的,把一个表分布到不同的硬盘或其他存储介质中,会大大提升查询的速度.
分区表的步骤
分区表的定义大体上分为三个步骤:
1. 定义分区函数
2. 定义分区构架
3. 定义分区表
分区函数,分区构架和分区表的关系如下:
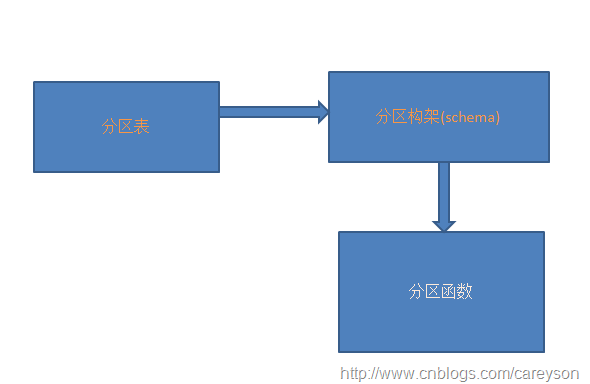
分区表依赖分区构架,而分区构架又依赖分区函数.值得注意的是,分区函数并不属于具体的分区构架和分区表,他们之间的关系仅仅是使用关系.
下面我们通过一个例子来看如何定义一个分区表:
假设我们需要定义的分区表结构如下:
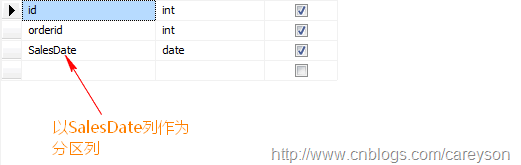
第一列为自增列,orderid为订单id列,SalesDate为订单日期列,也就是我们需要分区的依据.
下面我们按照上面所说的三个步骤来实现分区表.
定义分区函数
分区函数是用于判定数据行该属于哪个分区,通过分区函数中设置边界值来使得根据行中特定列的值来确定其分区,上面例子中,我们可以通过SalesDate的值来判定其不同的分区.假设我们想定义两个边界值(boundaryValue)进行分区,则会生成三个分区,这里我设置边界值分别为2004-01-01和2007-01-01,则前面例子中的表会根据这两个边界值分成三个区:

在MSDN中,定义分区函数的原型如下:
CREATE PARTITION FUNCTION partition_function_name ( input_parameter_type )
FOR VALUES ( [ boundary_value [ ,...n ] ] )
[ ; ]
通过定义分区函数的原型,我们看出其中并没有具体涉及具体的表.因为分区函数并不和具体的表相绑定.上面原型中还可以看到Range left和right.这个参数是决定临界值本身应该归于“left”还是“right”:
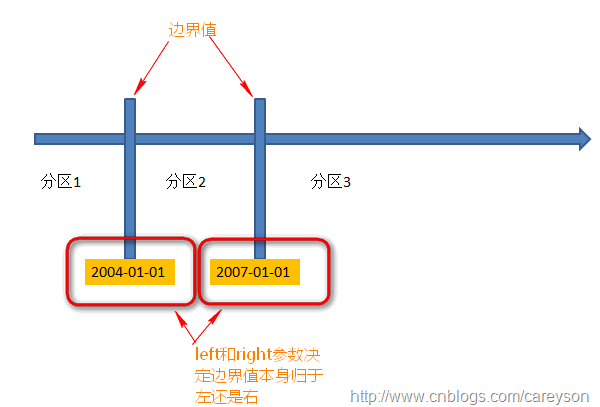
下面我们根据上面的参数定义分区函数:

通过系统视图,可以看见这个分区函数已经创建成功
定义分区构架
定义完分区函数仅仅是知道了如何将列的值区分到了不同的分区。而每个分区的存储方式,则需要分区构架来定义.使用分区构架需要你对文件和文件组有点了解.
我们先来看MSDN的分区构架的原型:
CREATE PARTITION SCHEME partition_scheme_name
AS PARTITION partition_function_name
[ ALL ] TO ( { file_group_name | [ PRIMARY ] } [ ,...n ] )
[ ; ]
从原型来看,分区构架仅仅是依赖分区函数.分区构架中负责分配每个区属于哪个文件组,而分区函数是决定如何在逻辑上分区:
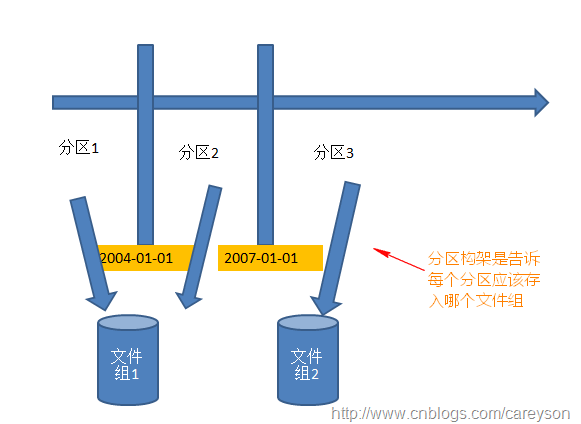
基于之前创建的分区函数,创建分区构架:
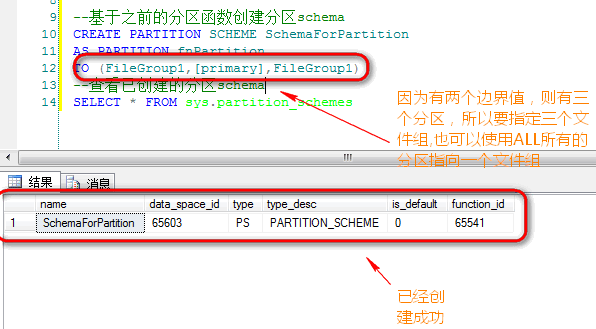
定义分区表
接下来就该创建分区表了.表在创建的时候就已经决定是否是分区表了。虽然在很多情况下都是你在发现已经表已经足够大的时候才想到要把表分区,但是分区表只能够在创建的时候指定为分区表。
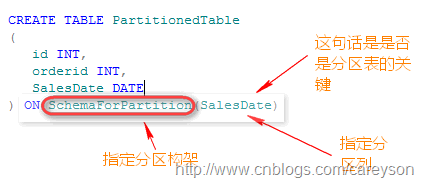
为刚建立的分区表PartitionedTable加入5万条测试数据,其中SalesDate随机生成,从2001年到2010年随机分布.加入数据后,我们通过如下语句来看结果:
-
insert into PartitionedTable values(1,'2003-01-01')
-
insert into PartitionedTable values(2,'2004-01-01')
-
insert into PartitionedTable values(3,'2004-01-12')
-
insert into PartitionedTable values(4,'2007-01-01')
- insert into PartitionedTable values(5,'2007-02-12')
出现了如下错误:
没有为文件组 "FileGroup1" 分配文件。只有添加文件后,才能在此文件组上填充表、索引和 text 列、ntext 列和 image 列
于是给文件组分配文件,在自己虚拟机上实现:
-
use master
-
alter database newDB1
-
add file
-
(
-
name = Add_File1,
-
filename = 'E:\Microsoft SQL Server\MSSQL10_50.DavidSQL2008R2\MSSQL\DATA\newDB1_FileGroup1.ndf'
-
)
-
to filegroup FileGroup1
-
go
-
-
-
alter database newDB1
-
add file
-
(
-
name = Add_File2,
-
filename = 'E:\Microsoft SQL Server\MSSQL10_50.DavidSQL2008R2\MSSQL\DATA\newDB1_FileGroup2.ndf'
-
)
-
to filegroup FileGroup2
-
go
-
-
-
alter database newDB1
-
add file
-
(
-
name = Add_File3,
-
filename = 'E:\Microsoft SQL Server\MSSQL10_50.DavidSQL2008R2\MSSQL\DATA\newDB1_FileGroup3.ndf'
-
)
-
to filegroup FileGroup3
- go
然后插入成功了!!!
查询某个分区
这里我们要用到$partition函数。这个函数在联机丛书中是这样解释的:
用法:
为任何指定的分区函数返回分区号,一组分区列值将映射到该分区号中。
语法:
[ database_name. ] $PARTITION.partition_function_name(expression)
参数:
database_name
包含分区函数的数据库的名称。
partition_function_name
对其应用一组分区列值的任何现有分区函数的名称。
expression
其数据类型必须匹配或可隐式转换为其对应分区列数据类型的表达式。expression 也可以是当前参与 partition_function_name 的分区列的名称。
返回类型:
int
备注:
$PARTITION 返回从 1 到分区函数的分区数之间的 int 值。
$PARTITION 将针对任何有效值返回分区号,无论此值当前是否存在于使用分区函数的分区表或索引中。
我们来查询分区表Order的第一个分区,代码如下:

分区表的分割
分区表的分割。相当于新建一个分区,将原有的分区需要分割的内容插入新的分区,然后删除老的分区的内容,概念如下图:
假设我新加入一个分割点:2009-01-01,则概念如下:
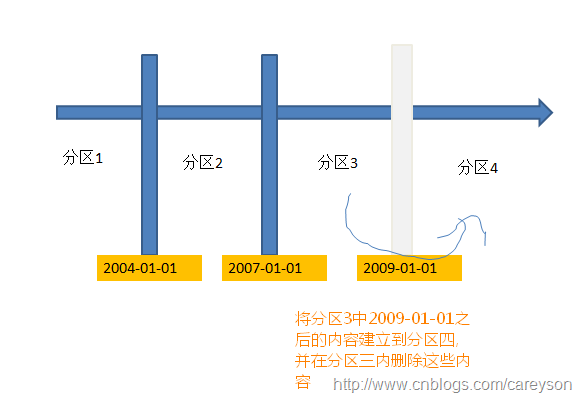
通过上图我们可以看出,如果分割时,被分割的分区3内有内容需要分割到分区4,则这些数据需要被复制到分区4,并删除分区3上对应数据。
这种操作非常非常消耗IO,并且在分割的过程中锁定分区三内的内容,造成分区三的内容不可用。不仅仅如此,这个操作生成的日志内容会是被转移数据的4倍!
所以我们如果不想因为这种操作给客户带来麻烦而被老板爆菊的话…最好还是把分割点建立在未来(也就是预先建立分割点),比如2012-01-01。则分区3内的内容不受任何影响。在以后2012的数据加入时,自动插入到分区4.
分割现有的分区需要两个步骤:
1.首先告诉SQL SERVER新建立的分区放到哪个文件组
2.建立新的分割点
可以通过如下语句来完成:
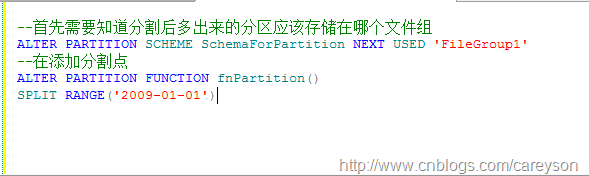
如果我们的分割构架在定义的时候已经指定了NEXT USED,则直接添加分割点即可。
通过文中前面查看分区的长语句..再来看:

新的分区已经加入!
分区的合并
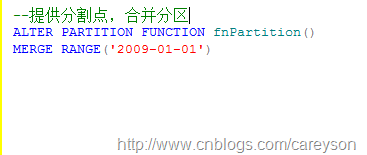
分区的合并可以看作分区分割的逆操作。分区的合并需要提供分割点,这个分割点必须在现有的分割表中已经存在,否则进行合并就会报错
假设我们需要根据2009-01-01来合并分区,概念如下:
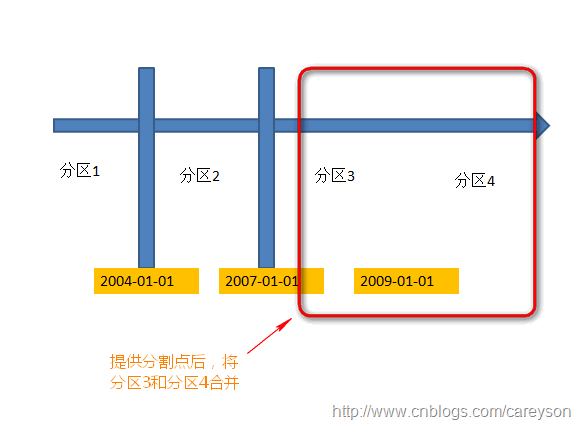
只需要使用merge参数:
再来看分区信息:

这里值得注意的是,假设分区3和分区4不再一个文件组,则合并后应该存在哪个文件组呢?换句话说,是由分区3合并到分区4还是由分区4合并到分区3?这个需要看我们的分区函数定义的是left还是right.如果定义的是left.则由左边的分区3合并到右边的分区4.反之,则由分区4合并到分区3:

在 MS SQLServer Management Studio查看分区函数和分区方案/构架
首先选择要看的分区表的所在数据库 newDB1 --> 存储-->分区方案/分区函数,如下图:

总结
本文从讲解了SQL SERVER中分区表的使用方式。分区表是一个非常强大的功能。使用分区表相对传统的分区视图来说,对于减少DBA的管理工作来说,会更胜一筹!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/26435490/viewspace-1452924/ ,如需转载,请注明出处,否则将追究法律责任。

