hadoop需要配置的文件很多,下面是根据我的主机需要配置的几个文件:
因为代码识别问题我吧左尖括号都去掉了
core-site.xml
property>
name>fs.default.name /name>
value>hdfs://Aoplee:9000 /value>
/property>
property>
name>hadoop.tmp.dir /name>
value>/hadoop-1.2.1/tmp /value>
/property>
hdfs-site.xml
property>
name>dfs.replication/name>
value>2/value>
/property>
mapred-site.xml
property>
name>mapred.job.tracker/name>
value>Aoplee:9001/value>
/property>
masters 中本来是localhost改为:Aoplee
slaves中本来是localhost改为:admin
根据Ip地址在两台主机中添加host文件解析
192.168.111.128 Aoplee
192.168.111.132 admin
配置完成之后,打开hadoop命令,一定要注意命令执行的路径
bin/hadoop namenode –format
bin/start-all.sh
1、遇到问题1:
解决方法:讲id_rsa.pub中的内容,添加到authorized_keys中
打开hadoop之后需要在验证是否安装hadoop成功:如下图:
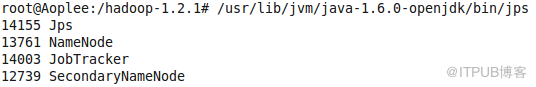
在主节点上显示如上图,在次节点上显示如下图:
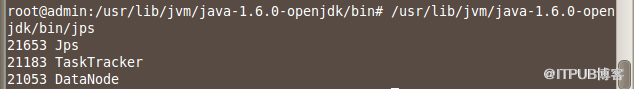
主节点上显示的进程有4个,没有打开datanode,需要人工打开,否则会出现上传文件不能成功。
# hadoop-daemon.sh start namenode
# hadoop-daemon.sh start datanode
2、上传文件,进行统计
首先建设生产连个test文件,如下:
Echo “hello world”>test1.txt
Echo “hello hadoop”>test 2
.txt
在上传过程中出现上传失败的错误如下:
root@Aoplee:/hadoop-1.2.1# bin/hadoop fs -put
../input/test2.txt ./in/test2.txt
14/01/19 22:55:34 WARN hdfs.DFSClient: DataStreamer
Exception: org.apache.hadoop.ipc.RemoteException:
java.io.IOException: File /user/root/in/test2.txt could only be
replicated to 0 nodes, instead of 1
at
org.apache.hadoop.hdfs.server.namenode.FSNamesystem.getAdditionalBlock(FSNamesystem.java:1920)
at
org.apache.hadoop.hdfs.server.namenode.NameNode.addBlock(NameNode.java:783)
at sun.reflect.GeneratedMethodAccessor6.invoke(Unknown
Source)
at
sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
原因在于没有打开datanode,参照上节。
使用
命令查看,得到的结果如下:
root@Aoplee:/usr/lib/jvm/java-1.6.0-openjdk#
jps
13761 NameNode
14003 JobTracker
17551 Jps
17461 DataNode
12739 SecondaryNameNode
3、遇到问题2
可能是因为我使用的hadoop的版本不对,在上传的过程中总是发生文件逻辑路径出错,这会给后面的实验造成错误。
解决办法:root@Aoplee:/hadoop-1.2.1# bin/hadoop fs -put
../input/test2.txt ./in/test2.txt
即,直接使用拷贝文件的命令,而不是使用拷贝文件夹下的命令。
拷贝成功查看文件如下:
查看上传的文件的内容:如下:
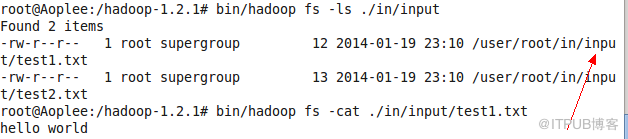
上图中箭头指的是路径存在的问题。
一切就绪,使用demo中已经写好的mapreduce函数进行测试,命令如下:
bin/hadoop jar hadoop-examples-1.2.1.jar wordcount in
out
计算两个文件中的单词个数的统计,获得的结果保存在out目录下的三个文件下,
至此,hadoop环境搭建成功。


