第三章三续、求给定区间内的第K小(大)元素
作者:July、上善若水、编程艺术室。
出处: 管理员说不能出现其它网站的链接,所以就不贴原始出处了。
前奏
原狂想曲系列,已更名为:程序员编程艺术系列。上一章,我们介绍了第十章、如何给10^7个数据量的磁盘文件排序,下面介绍下本章的主题。我们知道,通常来讲,寻找给定区间内的第k小(大)的元素的问题是ACM中一类常用的数据结构的一个典型例题,即划分树/逆向归并树,通常用线段树的结构存储。
当然这里暂且不表,尚不说划分树思想的神奇,就是线段树的结构,一般没有ACM基础的人也都觉得难以理解。所以,这里提供一个时间效率尚可,空间代价还要略小的巧妙解法—伴随数组。
如果看过此前程序员编程艺术:第六章、求解500万以内的亲和数中,有关亲和数的那个题目的伴随数组的解法,也就是利用数组下标作为伴随数组,相信就会对这个方法有一定程度的理解。
第一节、寻找给定区间内的第k小(大)的元素
给定数组,给定区间,求第K小的数如何处理?常规方法请查阅:程序员编程艺术:第三章、寻找最小的k个数。
1、排序,快速排序。我们知道,快速排序平均所费时间为n*logn,从小到大排序这n个数,然后再遍历序列中后k个元素输出,即可,总的时间复杂度为O(n*logn+k)=O(n*logn)。
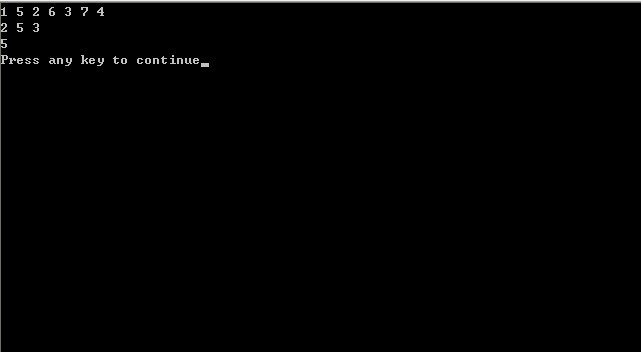
2、排序,选择排序。用选择或交换排序,即遍历n个数,先把最先遍历到得k个数存入大小为k的数组之中,对这k个数,利用选择或交换排序,找到k个数中的最小数kmax(kmax设为k个元素的数组中最小元素),用时O(k)(你应该知道,插入或选择排序查找操作需要O(k)的时间),后再继续遍历后n-k个数,x与kmax比较:如果x 3、维护k个元素的最大堆,原理与上述第2个方案一致,即用容量为k的最小堆存储最先遍历到的k个数,并假设它们即是最小的k个数,建堆费时O(k),有k1 4、按编程之美上解法二的所述,类似快速排序的划分方法,N个数存储在数组S中,再从数组中随机选取一个数X,把数组划分为Sa和Sb俩部分,Sa<=X<=Sb,如果要查找的k个元素小于Sa的元素个数,则返回Sa中较小的k个元素,否则返回Sa中所有的元素+Sb中较小的k-|Sa|个元素。不断递归下去,把问题分解成更小的问题,平均时间复杂度为O(N)(编程之美所述的n*logk的复杂度有误,应为O(N),特此订正。其严格证明,请参考第三章:程序员面试题狂想曲:第三章、寻找最小的k个数、updated 10次)......。 我们以下面的测试数据举例(红体部分表示下标为2~5之间的数5,2,6,3,蓝色部分表示给定区间中的数各自对应的数组下标,注,这里,我们让数组下标从1开始): a[i].data 1 5 2 6 3 7 4 现在,题目要求:在原序列中下标2~5(即下标为2、3、4、5)之间找到第3小的数。问题亦相当于要你找原序列里给定区间即第2个数到第5个数之中(5 2 6 3)第3小的数(当然,答案很明显,第3小的数就是5)。 那么对原数组进行排序,然后得到的序列应该是(原下标保持不变): a [i].data 1 2 3 4 5 6 7 如上,既然数据现在已经从小到大排好了,那么,我们只需要进行一次检索,从最小的数到最大的数,我们找第k(k=3)小的数,当我们发现下标a[i].num等于原下标索引为2~5中的任一数值,亦即a[i].data==5 || 2 || 6 || 3的时候,k--,那么当k==0的时候,我们也就找到了第k(3)小的数了。如下(红色部分表示原给定区间中的数,浅色部分依然是原各数对应的下标): a [i].data 1 2 3 4 5 6 7 故下标索引为2~5之间第k(3)小的数是5。 程序的构造与解释:由于排序后,我们能保证原序列已经从小到大的排好序了,所以,当遍历或扫描到原序列给定区间中的数时,则k--,最终能在k==0时,找到第k小的数,且这个数是在原来给定区间中的某一个数。 view plaincopy to clipboardprint? struct node{ int main() 程序测试:输入的第1行数字代表给定的数组,2 5代表给定的区间为a[2]~a[5],3表示要在给定的区间a[2]~a[5]中寻找第3小的数。程序运行结果如下: 水原来写的代码(上面我的改造,是为了达到后来扫描时O(N)的视觉效果): struct node{ int main() 编程独白: 给你40分钟的时间,你可以思考十分钟,然后用三十分钟的时间来写代码,最后浪费在无谓的调试上;你也可以思考半个小时,彻底弄清问题的本质与程序的脉络,然后用十分钟的时间来编写代码,体会代码如行云流水而出的感觉。 本章总结: 伴随数组这种方式确实比较新颖 ,伴随数组的前提是在排序后的 ,但总的复杂度还是 0(N*logN+N)=O(N*logN),找第K大的数的此类面试题都是有这几点限制:1、数很多,让你在内存中放不下,2、复杂度严格要求,即不能用排序。 对于这个伴随数组,我们在解决 “给定区间的区间找寻第k小(大)的元素” 这个问题,还是选择堆为好,在之前的基础上:入堆的时候 只需检测这个元素的下标是否是给定区间内的,不是则不入这样的复杂度会低,不需要排序。(非常感谢雨翔的意见)。 本章完。 版权所有,本人对本blog内所有任何内容享有版权及著作权。网络转载,请以链接形式注明出处。
下面我们给出伴随数组解法,首先,定义一个结构体,一个是数组元素,另一个是数组原来的标号,记录每个数在数组的原顺序。
a[i].num 1 2 3 4 5 6 7
a [i].num 1 3 5 7 2 4 6
a [i].num 1 3 5 7 2 4 6
k 3 2 1 1 0
而这个伴随数组,或者说原序列各数的索引则帮我们或者说是帮电脑记下了原来的数,已让我们后来遍历时能识别排序后序列中的数是否是给定区间中的某一个数。如果是原给定区间中的数,则k--,否则k不变。
第二节、采用伴随数组方案的实现
上述采用伴随数组的方法巧妙且简单,也很好理解和实现,关键 就是 在于题目要求是在给定区间的区间找寻第k小(大)的元素,所以,基本上在排序n*logn完了之后,总能 在O(n)的时间内找到想找的数。源代码如下:
//copyright@ 水 && July
//总的时间复杂度为O(N*logN+N)=O(N*logN)。
//July、updated,2011.05.28.凌晨。
#include
#include
using namespace std;
struct node{
int num,data;
bool operator < (const node &p) const
{
return data < p.data;
}
};
node p[100001];
int main()
{
int n=7;
int i,j,a,b,c;//c:flag;
for(i=1;i<=n;i++)
{
scanf("%d",&p[i].data);
p[i].num = i;
}
sort(p+1,p+1+n); //调用库函数sort完成排序,复杂度n*logn
scanf("%d %d %d",&a,&b,&c);
for(i=1;i<=n;i++) //扫描一遍,复杂度n
{
if(p[i].num>=a && p[i].num<=b)
c--;
if(c == 0)
break;
}
printf("%d\n",p[i].data);
return 0;
}
//copyright@ 水 && July
//总的时间复杂度为O(N*logN+N)=O(N*logN)。
//July、updated,2011.05.28.凌晨。
#include
#include
using namespace std;
int num,data;
bool operator < (const node &p) const
{
return data < p.data;
}
};
node p[100001];
{
int n=7;
int i,j,a,b,c;//c:flag;
for(i=1;i<=n;i++)
{
scanf("%d",&p[i].data);
p[i].num = i;
}
sort(p+1,p+1+n); //调用库函数sort完成排序,复杂度n*logn
scanf("%d %d %d",&a,&b,&c);
for(i=1;i<=n;i++) //扫描一遍,复杂度n
{
if(p[i].num>=a && p[i].num<=b)
c--;
if(c == 0)
break;
}
printf("%d\n",p[i].data);
return 0;
}
view plaincopy to clipboardprint?
//copyright@ 水
#include
#include
using namespace std;
struct node{
int num,data;
bool operator < (const node &p) const
{
return data < p.data;
}
};
node p[100001];
int main()
{
int n,m,i,j,a,b,c;//c:flag;
while(scanf("%d %d",&n,&m)!=EOF)
{
for(i=1;i<=n;i++)
{
scanf("%d",&p[i].data);
p[i].num = i;
}
sort(p+1,p+1+n);
for(j=1;j<=m;j++)
{
scanf("%d %d %d",&a,&b,&c);
for(i=1;i<=n;i++)
{
if(p[i].num>=a && p[i].num<=b)
c--;
if(c == 0)
break;
}
printf("%d\n",p[i].data);
}
}
return 0;
}
//copyright@ 水
#include
#include
using namespace std;
int num,data;
bool operator < (const node &p) const
{
return data < p.data;
}
};
node p[100001];
{
int n,m,i,j,a,b,c;//c:flag;
while(scanf("%d %d",&n,&m)!=EOF)
{
for(i=1;i<=n;i++)
{
scanf("%d",&p[i].data);
p[i].num = i;
}
sort(p+1,p+1+n);
for(j=1;j<=m;j++)
{
scanf("%d %d %d",&a,&b,&c);
for(i=1;i<=n;i++)
{
if(p[i].num>=a && p[i].num<=b)
c--;
if(c == 0)
break;
}
printf("%d\n",p[i].data);
}
}
return 0;
}
--------------------------------------------------------------------------------
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/25835657/viewspace-696532/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- [原]Nginx源码剖析之内存池,与内存管理
- [原]六之再续:KMP算法之总结篇(12.09修订,必懂KMP)
- [原]程序员编程艺术第二十三~四章:杨氏矩阵查找,倒排索引关键词Hash编码
- [原]程序员编程艺术第二十五章:Jon Bentley:90%无法正确实现二分查找
- [原]程序员编程艺术第二十六章:基于给定的文档生成倒排索引(含源码下载)
- [原]推荐引擎算法学习导论
- [原]结构之法算法之道blog最新博文集锦第6期CHM文件0积分下载
- [原]读书会·北京今日启动(第1期DeepQA,Siri,算法于02.12清华东楼举办)
- [原]读书会第1期DeepQA框架&Siri架构会场笔记(含PPT下载)
- 横空出世,席卷互联网--评微软等公司数据结构和算法面试100题
