背景
7月份的时候导师布置了个作业,他给了一条用程序生成的曲线,然后让我们用代码实现一个梯度下降算法来拟合曲线。具体要求:
data.csv文件中包含两列用逗号分隔的数据。第一列是x,第二列是y。完成如下工作:
(1)在data.csv中随机选择80%的数据作为训练集,剩余20%作为测试集。
(2)构造模型,采用梯度下降算法训练模型。
(3)用测试集对训练的模型进行评估,将测试集中的x作为输入,用模型计算y,计算预测值与实际值的RMSE。
(4)绘制data.csv中的点,绘制x ∈ [0,1] 之间模型的对应曲线。
数据格式如下:
0.000000000000000000,0.0000454019910096840.010010010010010010,0.0000674879083479180.020020020020020020,0.0000995166652482450.030030030030030030,0.0001455742214057580.040040040040040040,0.0002112477521525380.050050050050050046,0.0003041019360496450.060060060060060060,0.0004342776116289260.070070070070070073,0.0006152366314268930.080080080080080079,0.0008646872279901880.090090090090090086,0.0012057601227382130.100100100100100092,0.001668621265042236
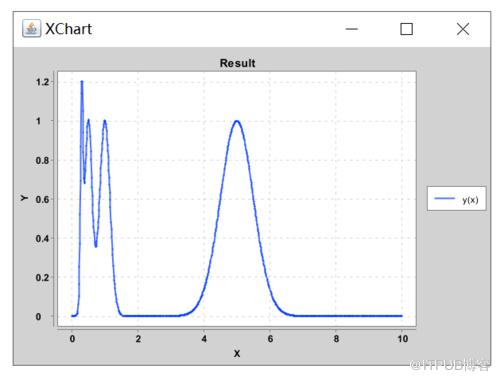
上面的csv文件一共有1000行数据,在xy平面上绘制出来的曲线如下:
思路
老师的意思是先猜这条曲线是什么函数的曲线(先确定函数的基本形式),一开始函数的具体参数是不知道的,需要猜几个初始值,那么猜出来的曲线一定和实际曲线有较大差异,再用最优化的方法找到使差异最小化的函数参数,从而实现曲线的拟合。这里要求实现梯度下降算法来求解最小值。
从曲线的图像来看原始数据应该是几个均值方差不同的高斯函数叠加而成的,图中有4个峰,因此可以假设曲线的模型为:f(x)=alpha_1e^{-frac{(x-mu_1)^2}{2sigma^2_1}}+alpha_2e^{-frac{(x-mu_2)^2}{2sigma^2_2}}+alpha_3e^{-frac{(x-mu_3)^2}{2sigma^2_3}}+alpha_4e^{-frac{(x-mu_4)^2}{2sigma^2_4}}。
令误差函数为E=sumlimits_{i=1}^{n} (f(x_i) - y_i)^2。则理想的模型参数:
(alpha_1,mu_1,sigma_1,alpha_2,...,sigma_4)=minlimits_{alpha_1,...,sigma_4}E
梯度下降算法每次求出函数(E)在某个点(当前参数)的梯度,因为梯度就是函数值增长最快的那个方向,所以让参数沿着梯度的负方向乘以一定的步长进行更新,就一定能抵达一个局部极小点。所以只要给定了这里的误差函数E(alpha_1,mu_1,sigma_1,alpha_2,mu_2,sigma_2,alpha_3,mu_3,sigma_3,alpha_4,mu_4,sigma_4),就可以通过梯度下降算法来找到使误差函数达到局部极小的12个参数。
为了便于计算,可以把sigma^2当成一个整体,此时需要求出E在某个点的梯度的一般表示:(frac{partial E}{partial alpha_1},frac{partial E}{partial mu_1},frac{partial E}{partial sigma_1^2},frac{partial E}{partial alpha_2},frac{partial E}{partial mu_2},frac{partial E}{partial sigma_2^2},frac{partial E}{partial alpha_3},frac{partial E}{partial mu_3},frac{partial E}{partial sigma_3^2},frac{partial E}{partial alpha_4},frac{partial E}{partial mu_4},frac{partial E}{partial sigma_4^2},)。其中frac{partial E}{partial alpha_1}=2sumlimits_{i=1}^{n}((f(x_i)-y_i)e^{-frac{(x_i-mu_1)^2}{2sigma_1^2}}) frac{partial E}{partial mu_1}=2sumlimits_{i=1}^{n}(frac{alpha_1(x_i-mu_1)}{sigma_1^2}(f(x_i)-y_i)e^{-frac{(x_i-mu_1)^2}{2sigma_1^2}}) frac{partial E}{partial sigma_1^2}=2sumlimits_{i=1}^{n}(frac{alpha_1(x_i-mu_1)^2}{2sigma_1^4}(f(x_i)-y_i)e^{-frac{(x_i-mu_1)^2}{2sigma_1^2}}),其余参数的偏导数以此类推。
设定一个迭代次数,每次求出误差函数的梯度后,设定步长eta,让参数沿梯度的负方向更新,如:alpha_1=alpha_1-etafrac{partial E}{partial alpha_1},mu_1=mu_1-etafrac{partial E}{partial mu_1},然后重复这个步骤,直到达到一定迭代次数或者总误差小于一定阈值停止迭代。
程序
程序使用Java实现。(C++写起来麻烦而且没有合适的图表显示库,Python太慢,Java写起来最顺手)
一开始我面临的问题就是选择一个图表显示库,简单地调研了一下选了XChart,但是去了该项目的Github主页发现居然没有打包好的 jar 包,于是需要 clone 下来然后用 mvn package 命令把 jar 包打出来。
然后我定义了一个模型类 Model,这个模型类的成员变量是 double数组,用来放待调的参数,比如上文中的f(x)对应的参数数组长度就为12。Model类有一些待实现的方法如函数的求值(val)、梯度的求值(grad)等,其派生类GaussianModel就是上文中的模型。另外,因为梯度下降会抵达最近的极小点而不是全局最小点,最终的收敛点极大依赖于参数的初始值,我每次随机选取了一部分数据点来求梯度以跳出局部极小。
Java代码如下:
package com.company;import org.knowm.xchart.QuickChart;import org.knowm.xchart.SwingWrapper;import org.knowm.xchart.XYChart;import java.io.File;import java.io.FileNotFoundException;import java.util.*;import java.util.function.Function;import java.util.stream.Collectors;import static java.lang.Math.E;import static java.lang.Math.pow;import static java.lang.Math.sqrt;import static java.lang.System.exit;public class Solver { private List rawData = new ArrayList(); private List trainData = new ArrayList(); private List testData = new ArrayList(); private Model model = null; private Function loss = null; public Solver(String csvPath) throws FileNotFoundException {
Scanner scanner = new Scanner(new File(csvPath)); while (scanner.hasNextLine()) {
String[] xy = scanner.nextLine().split(",");
rawData.add(new Point(Double.valueOf(xy[0]), Double.valueOf(xy[1])));
}
} private Function mse = (m) -> { double lossSum = 0.0; for (Point p : trainData) { double diff = m.val(p.x) - p.y;
lossSum += (diff * diff);
} return lossSum / 2.0;
}; private void divide(float ratio4Train) {
trainData.clear();
testData.clear(); if (ratio4Train exclusiveIndices4Test = new HashSet(); while (exclusiveIndices4Test.size() point.x).collect(Collectors.toList()),
trainData.stream().map(point -> point.y).collect(Collectors.toList())); double[] xPoints = new double[150]; double[] yPoints = new double[150]; for (int i = 0; i (chart).displayChart();
} public void solve() {
divide(0.8f);
train();
validate();
plot();
} public static void main(String[] args) throws FileNotFoundException { // write your code here
if (args.length trainData); abstract void randomize(); abstract double rate(int i);
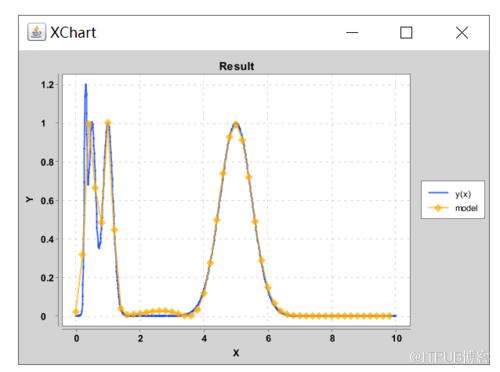
} private static class PolyModel extends Model{ public PolyModel(int n) { if (n trainData) { double []gradVec = new double[theta.length]; for (int i = 0; i data = new ArrayList(); for (int k = 0; k trainData) { double[] gradVec = new double[theta.length]; for (int i = 0; i stochasticData = new ArrayList(); for (int k = 0; k 最后的结果还是比较看人品的,并不是每次都能拟合地比较好,贴一个结果的图:
结果
数据和代码我放到了我的Github:https://github.com/Jimmie00x0000/gradient_desent_demo。
作者:JimmieZhou
链接:https://www.jianshu.com/p/7943a565d0b5
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/2572/viewspace-2811974/ ,如需转载,请注明出处,否则将追究法律责任。

