本章首先简单地回顾一下数据库和关系型数据库的基本概念,然后介绍什么是SQL以及它的主要特性和设计思想。
本章涉及的主要知识点包括:
· 数据库的发展历史和数据库管理系统。
· 关系型数据库的基本概念和组成。
· SQL标准的历史、SQL语法特性以及面向集合的编程思想。
1.1 数据库
数据库(Database)是由许多相关数据构成的集合。数据无处不在,数据库也是如此。例如,手机上的联系人列表就是一个简单的数据库,我们的银行账号就存储在银行数据库中,我们在网络上购物时,浏览的是各种电商产品数据库,同时我们的浏览和购买行为也被存储到了电商后台的用户行为数据库。可以说,几乎所有的信息系统都有一个对应的数据库。
1.1.1 数据库发展历史
数据管理技术的发展经历了人工管理和文件管理阶段之后,大约在20世纪60年代进入了数据库管理阶段。早期的数据库系统按照存储模型可以分为层次数据模型(Hierarchical Data Model)和网状数据模型(Network Data Model)。
层次数据模型使用树状结构表示数据对象以及它们之间的联系,类似于现代操作系统中的文件目录结构。层次模型是数据库系统中最早出现的数据模型,典型的代表是IBM公司的IMS(Information Management System)数据库。
网状数据模型采用网状结构表示数据对象及它们之间的联系,一个结点可以有一个或多个下级结点,也可以有一个或多个上级结点,两个结点之间甚至可以有多种联系。网状数据库反映了现实世界中实体之间更为复杂的联系,典型的代表是DBTG系统。
层次数据库和网状数据库的数据独立性和抽象程度有限,导致用户编写应用时必须了解数据存储的细节,实现过程比较复杂。为了解决这些问题,1970年6月IBM公司的研究员Edgar Frank Codd博士在Communications of ACM上发表了著名的论文《A Relational Model of Data for Large Shared Data Banks》,随后创建了关系数据模型。
关系数据模型(Relational Data Model)具有严格的数学理论基础,采用关系(二维表)表示数据对象以及它们之间的联系,概念非常简单,易于理解和使用。同时,关系数据模型提供了较高的抽象级别,用户只需要通过声明式的SQL(结构化查询语言)对数据进行访问和处理,而不需要了解具体的数据存储和访问方式。
关系型数据库经过几十年的发展和应用,已经成了数据库领域的主流产品,应用范围非常广泛。目前主流的关系型数据库包括MySQL、Oracle、Microsoft SQL Server、PostgreSQL以及SQLite等。
随着互联网的发展和大数据的兴起,市场上出现了各种各样的非关系型(NoSQL)数据库。NoSQL代表Not only SQL,表明它们是对传统关系型数据库的补充和升级,而不是为了替代关系型数据库。NoSQL数据库主要用于解决关系型数据库在某些特定场景下的局限性,例如复杂的数据结构、海量数据存储和水平扩展性问题;但是它们同时也会为此牺牲某些关系型数据库的特性,例如对事务强一致性的支持和标准SQL接口。
常见的NoSQL数据库包括以下几类:文档数据库(例如MongoDB)采用灵活的模式结构,适用于存储半结构化的文档数据;键值数据库(例如Redis)使用简单的键值方法来存储数据,可以提供高性能的数据结构缓存;宽列存储数据库(例如Cassandra)提供了动态列存储功能,适合于需要存储大量数据的情况;图数据库(例如Neo4J)基于数学中的图论算法,适合大量复杂关系网络的分析;全文搜索引擎(例如Elasticsearch)可以提供强大的全文搜索功能。
2011年,美国451 Group的分析师Matthew Aslett在其论文中首次提出了NewSQL概念。NewSQL是一类新型的关系型数据库,它们不但拥有传统关系型数据库的事务强一致性和标准SQL接口,同时也具有NoSQL数据库对海量数据的可扩展性和高性能。
Google公司随后陆续发布了Spanner/F1系统的论文,首次实现了关系模型和NoSQL的可扩展性在超大集群规模上的融合。基于这一启发,Cockroach Labs开发了CockroachDB分布式数据库,PingCAP公司开发了TiDB数据库,阿里巴巴开发了OceanBase数据库。另外,还有一些采用优化引擎的NewSQL数据库系统,例如MySQL Cluster。
与此同时,传统的关系型数据库厂商也在积极拥抱变化。如今,主流的关系型数据库基本上都提供了文档存储(XML、JSON)和图形数据等非关系数据模型,而且可以通过标准SQL接口和函数对这些半结构化数据和非结构化数据进行访问和处理,我们将会在本书第18章中对此进行更多讨论。
1.1.2 数据库管理系统
严格来说,数据库管理系统(Database Management System)和数据库是两个不同的概念,数据库管理系统是用于定义、操作、管理和维护数据库的软件系统。
数据库管理系统和数据库共同构成了数据库系统,如图1.1所示。

图1.1 数据库系统组成
目前主流的关系型数据库管理系统包括:
Oracle数据库,第一个商业关系型数据库,也是数据库领域的领导者。Oracle数据库支持关系数据、列式存储、文档存储、空间、图形和非结构化数据。
MySQL,最流行的开源关系型数据库,广泛应用于互联网企业。MySQL支持关系数据、文档存储以及键值存储,目前已经被Oracle公司收购。另外,MySQL还有一些衍生版本,例如MariaDB、Percorna Server。
Microsoft SQL Server,微软开发的关系型数据库产品,支持关系数据、文档存储和图形数据。Microsoft SQL Server 2017开始同时支持Windows和Linux系统。
PostgreSQL,最先进的开源对象-关系型数据库管理系统。PostgreSQL支持关系数据、文档存储和图形数据。
SQLite,最流行的嵌入式关系型数据库,也是世界上安装最多的数据库。SQLite没有单独管理数据库的服务器进程,它是一个嵌入到应用程序中的数据库引擎。
通常在不会引起歧义的情况下,我们不区分数据库或者数据库管理系统这两个概念。
1.2 关系型数据库
关系型数据库(Relational Database)是指基于关系模型的数据库。关系模型由Edgar Frank Codd博士于1970年提出,以集合论中的关系概念为基础,无论是现实世界中的实体对象还是它们之间的联系都使用关系表示。
我们在关系型数据库中看到的关系就是二维表(Table),由行(Row)和列(Column)组成。因此,也可以说关系表是由数据行构成的集合,一个数据库则包含了多个关系表。
根据定义,关系模型由关系数据结构、关系操作集合以及关系完整性约束三部分组成。
1.2.1 数据结构
在关系模型中,用于存储数据的逻辑结构称为关系(Relation)。对于用户而言,关系就是二维表(Table)。具体来说,关系型数据库中的表分为基础表、临时表、派生表(查询结果)和虚拟表(视图)。
图1.2是一个包含员工信息的基础表,可以看出它和Excel表格非常类似。
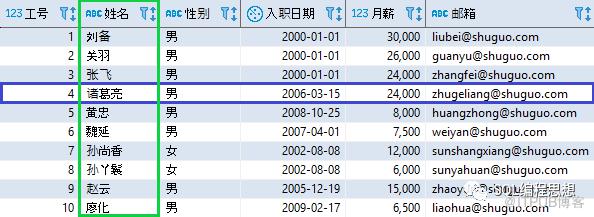
图1.2 员工信息表
在不同的场景下,读者可能会听到关于同一个概念的不同说法。在此,我们列出了关系型数据库中的一些常见概念:
表,也就是关系,用于表示现实世界中的实体(Entity)对象或者实体之间的联系(Relationship)。举例来说,一个公司的员工、部门和职位都是实体,分别对应员工表、部门表和职位表;订单明细表则记录了订单和销售的商品之间的联系。
行,也称为记录(Record)或者元组(Tuple),代表了关系中的单个实体。图1.2中工号为4的数据行存储了“诸葛亮”的相关信息。
列,也称为字段(Field)或者属性(Attribute),表示实体的某个特征。图1.2中第二列存储了所有员工的姓名。表中每个列都有一个对应的数据类型,常见的数据类型包括字符串、数字、日期等。
1.2.2 关系操作
常见的数据操作包括增加(Create)、查询(Retrieve)、更新(Update)以及删除(Delete),或者统称为数据的增删改查(CRUD)。
使用最多也最复杂的操作就是查询,具体来说包括选择(Selection)、投影(Projection)、并集(Union)、交集(Intersection)、差集(Exception)以及笛卡儿积(Cartesian product)等。本书将会介绍如何使用SQL语句完成以上各种数据操作。
1.2.3 完整性约束
为了满足业务对数据完整性的要求,关系模型定义了三种完整性约束:实体完整性、参照完整性以及用户定义的完整性。
实体完整性是指表的主键字段不能为空。现实中的每个实体都具有唯一性,例如每个人都有唯一的身份证号。在关系型数据库中,这种唯一标识每行数据的字段被称为主键(Primary Key)。主键字段不能为空,每个表可以有且只能有一个主键。
参照完整性是指外键的参照完整性,外键(Foreign Key)代表了两个表之间的关联关系。例如员工属于部门,因此员工表中存在一个部门编号字段,它引用了部门表中的部门编号字段。对于外键,被引用的数据必须存在,员工不可能属于一个不存在的部门;同时,我们在删除某个部门之前也需要对部门中的员工进行相应的处理。
用户定义的完整性是指用户基于业务需要自定义的一些约束条件。其中,非空约束(NOT NULL)确保了相应的字段不会出现空值,例如员工一定要有姓名。唯一约束(UNIQUE)用于确保字段中的值不会重复,例如每个员工的电子邮箱必须唯一。检查约束(CHECK)可以定义更多的业务规则,例如月薪必须大于0,电子邮箱地址必须大写等。默认值(DEFAULT)可以为字段提供默认的数据。
本书涉及的5种主流关系型数据库都实现了以上完整性约束。其中,MySQL 8.0版本开始支持检查约束,InnoDB和NDB存储引擎支持外键约束。
1.3 SQL简介
SQL(Structured Query Language,结构化查询语言)是访问和操作关系型数据库的标准语言,所有的关系型数据库都可以使用SQL语句进行数据访问和控制。主要的SQL语句通常被分为以下几个类别:
· DQL(Data Query Language,数据查询语言)。DQL也就是SELECT语句,用于查询数据和信息。
· DML(Data Manipulation Language,数据操作语言)。DML用于对表中的数据进行插入(INSERT)、更新(UPDATE)、删除(DELETE)以及合并(MERGE)操作。
· DDL(Data Definition Language,数据定义语言)。DDL用于定义数据库中的对象(例如表或索引),包括创建(CREATE)、修改(ALTER)和删除(DROP)对象等操作。
· TCL(Transaction Control Language,事务控制语言)。TCL用于管理数据库中的事务,包括开始一个事务(START TRANSACTION)、提交事务(COMMIT)、撤销事务(ROLLBACK)和事务保存点(SAVE POINT)等。
· DCL(Data Control Language,数据控制语言)。DCL用于控制数据的访问权限,包括授予权限(GRANT)和撤销权限(REVOKE)。
1.3.1 SQL历史
1974年IBM的Ray Boyce和Don Chamberlin基于关系模型发明了SQL语言。SQL于1986年成为ANSI标准,并且在1987年成为ISO标准。ANSI在1992年对SQL标准进行了修订,称为SQL92或者SQL2,同时在1999年再次进行了修订,称为SQL99或者SQL3。
随后,SQL标准由ANSI和ISO/IEC共同维护,经历了多次版本修订之后,最新版本为SQL:2019或者ISO/IEC9075:2019。最新版本增加了多维数组(MDA)的支持,同时取代了之前的所有版本。图1.3描述了SQL标准的发展历程和主要的新增功能。
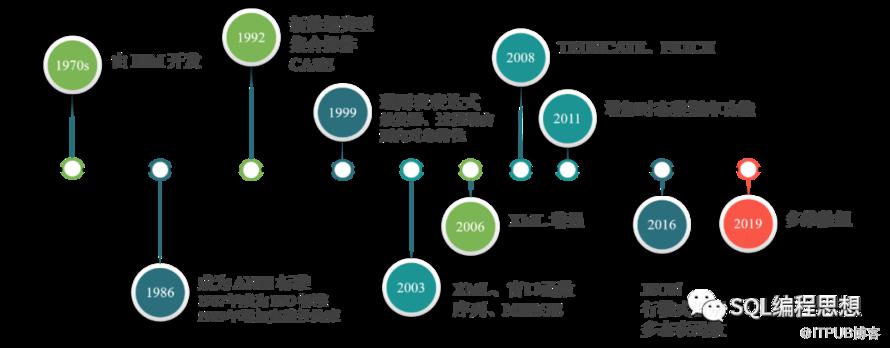
图1.3 SQL标准发展历史
现在,让我们来直观感受一下SQL语句的特点。
1.3.2 语法特性
提示:接下来我们会看到几个查询示例,在还没有正式开始学习SQL语句之前,可以暂时不必理会其中的细节。
SQL语句非常接近自然语言(英语),我们只需要掌握几个简单英文单词的作用,例如SELECT、INSERT、UPDATE、DELETE等,就可以完成绝大部分的数据库操作。例如,以下是一个简单的查询语句:
SELECT emp_id, emp_name, salaryFROM employeeWHERE salary >= 10000ORDER BY emp_id;
即便对于没有学过SQL的初学者,我们只要知道几个英文单词的意思就不难理解该语句的作用。该语句查找员工表(employee)中月薪(salary)大于等于10000的员工,返回了员工的工号(emp_id)、姓名(emp_name)以及月薪(salary),并且按照工号进行排序显示。
可以看出,SQL语句非常简单直观,因为它在设计之初就考虑了非技术人员的使用需求。SQL是一种声明式的语言,我们只需要说明想要的结果(What),而不需要指定怎么做(How),具体的操作交由数据库管理系统完成。
1.3.3 面向集合
对于SQL语句而言,它所操作的对象是一个集合(关系表),操作的结果也是一个集合(关系表)。也就是说,SQL是一种面向集合的编程语言。例如,以下是一个查询语句:
SELECT emp_id, emp_name, salaryFROM employee;
其中employee是一个数据表,它是该语句操作的对象。同时,查询的结果也是一个表(包含3个字段)。所以,我们可以继续操作查询的结果:
SELECT emp_id, emp_name, salaryFROM (SELECT emp_id, emp_name, salaryFROM employee) dt;
我们将括号中SELECT语句的查询结果(取名为dt)作为输入对象传递给外面的SELECT语句,最终整个语句的结果仍然是一个关系表。这种嵌套在其他语句中的查询被称为子查询,本书第7章将会介绍子查询的概念。
显然,我们可以继续嵌套该查询。同时,我们也可以执行其他数据操作,例如过滤数据(WHERE)、分组汇总(GROUP BY)、排序显示(ORDER BY)等,或者也可以通过连接查询(JOIN)从多个表中返回关联数据,甚至可以利用集合运算符(例如UNION)将多个查询结果进行合并。无论执行什么操作,SQL语句操作的对象都是集合,操作的结果也是集合。
不仅查询语句,SQL中的插入、更新和删除操作也都以集合(关系表)为操作对象。例如:
CREATE TABLE t(id INTEGER);INSERT INTO t(id) VALUES (1);INSERT INTO t(id) VALUES (2);INSERT INTO t(id) VALUES (3);
我们首先使用CREATETABLE语句创建了一个表t,然后使用INSERT语句插入了3条记录。通常我们每次只插入一条数据,这也就很容易导致我们以为插入语句是以数据行或者记录为单位的操作。但实际上一行数据也是一个集合,只不过它只有一个元素而已。
INSERT语句的另一种用法可以帮助我们更好地理解这个概念,例如:
INSERT INTO t(id)SELECT id FROM t;
SELECT语句返回的是一个集合,因此INSERT语句插入的也是一个集合。数据库执行插入操作之前会在内存中创建一个临时集合(内存临时表),然后将该集合插入目标表t中。因此,以上语句的作用是将表t中的数据再复制一份。
同理,UPDATE和DELETE语句也是以集合(关系表)为单位的操作,只不过我们习惯了更新一行数据或者删除几条记录的说法。
1.3.4 标准与实现
SQL是一种标准,不同厂商基于SQL标准实现了自己的数据库管理系统。这些数据库管理系统在一定程度上都兼容SQL标准,具有一定的可移植性。例如,所有的关系型数据库管理系统都使用SELECT语句表示数据的查询。
另一方面,所有数据库管理系统都实现了一些专有的语法和扩展功能,没有任何一种产品完全遵循标准。因此,一个数据库管理系统中支持的SQL代码在其他数据库管理系统中运行时可能需要进行修改。例如,Oracle和Microsoft SQL Server都实现了合并数据的MERGE语句,但是它们的语法略有不同。MySQL使用专有的INSERT… ON DUPLICATE KEY UPDATE语句执行数据合并操作。PostgreSQL和SQLite则实现了专有的INSERT… ON CONFLICT DO UPDATE语句。
除了SQL语句之外,大部分关系型数据库管理系统还提供了过程语言扩展(Procedural Language),支持类似于编程语言(Java、C++等)中的变量定义、控制流结构(if-else、while、for等)、游标(Cursor)以及异常处理等功能,可以在数据库服务器端实现编程。这些扩展功能通常使用专有的语法,也具有专门的名称,例如Oracle中的PL/SQL、Microsoft SQL Server中的T-SQL、PostgreSQL中的PL/pgSQL等。
正因为如此,本书除了介绍标准的SQL语法之外,还会比较5种主流关系型数据库管理系统中的具体实现和差异。标准SQL可以方便我们在不同数据库系统之间进行代码移植,特定数据库系统中的专有语法和特性可能会简化一些功能的实现。
1.4 小结
数据库是由许多相关数据构成的集合。关系型数据库是基于关系模型的数据库,关系模型由关系数据结构(二维表)、关系操作集合(SQL)以及关系完整性约束三部分组成。
SQL是关系型数据库中访问和操作数据的标准语言,它使用接近于自然语言(英语)的语法,通过声明的方式执行数据定义、数据操作、访问控制等。对于SQL而言,一切皆关系(表)。
原文作者:SQL编程思想;如有侵权,请联系管理员删除。

