本章将会介绍SELECT语句的基本检索、数据过滤、排序显示以及限定查询结果数量等功能,同时还会讨论SQL语句中的代码注释方法。
本章涉及的主要知识点包括:
查询数据的SELECT子句。
过滤数据的WHERE子句。
实现排序的ORDERBY子句。
限制数量的FETCH和OFFSET子句。
SQL中的注释。
2.1 基本检索功能
检索数据是数据库中最基本的操作,使用的语句就是SELECT。
2.1.1 查询指定字段
员工表(employee)中存储了关于员工的信息。假设我们现在打算群发邮件,需要找出所有员工的姓名、性别和电子邮箱地址。这个功能可以通过一个简单的查询语句来实现:
SELECT emp_name, sex, emailFROM employee;
其中SELECT是SQL中的关键字,表示查询数据;FROM也是关键字,表示要从哪个表中进行查询;emp_name、sex和email表示需要返回的字段,多个字段使用逗号分隔;分号表示SQL语句的结束。查询返回的结果如下。
emp_name|sex|email--------|---|------------------------刘备 |男 |liubei@shuguo.com关羽 |男 |guanyu@shuguo.com张飞 |男 |zhangfei@shuguo.com诸葛亮 |男 |zhugeliang@shuguo.com黄忠 |男 |huangzhong@shuguo.com魏延 |男 |weiyan@shuguo.com...
这种查询指定字段的操作在关系运算中被称为投影(Projection)。投影操作是针对表进行的垂直选择,保留选定的字段生成新的关系表。投影的过程如图2.1所示。

图2.1 投影操作示意图
注意:SQL语句由不同的子句组成部分,SELECT、FROM和WHERE等关键字都是子句。编写SQL语句时,关键字不分区大小写,一般使用大写形式。表名、列名等标识符一般也不区分大小写,使用小写形式;但是MySQL在Linux环境下的数据库名、表名、变量名等区分大小写。
2.1.2 查询全部字段
投影包含一个特殊的操作,就是查询表的全部字段。SQL为此提供了一个简单写法,就是使用星号(*)表示全部字段。例如,以下语句查询职位信息表中的全部字段:
SELECT *FROM job;
数据库服务器在解析该语句时会基于表的字段定义将其扩展为如下形式:
SELECT job_id, job_title,min_salary, max_salaryFROM job;
查询返回的结果如下。
job_id|job_title |min_salary|max_salary------|-----------|----------|----------1|总经理 | 24000.00| 50000.002|副总经理 | 20000.00| 30000.003| 人力资源总监| 20000.00| 30000.004| 人力资源专员| 5000.00| 10000.005|财务经理 | 10000.00| 20000.006|会计 | 5000.00| 8000.00...
使用星号无法指定字段出现的顺序,由数据库按照表定义时的顺序返回结果。
注意:虽然星号可以便于快速编写查询语句,但是在实际项目中不推荐使用这种写法。因为应用程序可能并不需要全部字段,星号会返回无用的字段;另外,当表结构发生变化时,星号返回的信息也会发生改变。
2.1.3 快速查询信息
通常来说查询操作的对象是表,但是为了执行简单的计算和快速信息检索,许多数据库管理系统都实现了一种不需要表的查询语句,例如:
-- MySQL、Microsoft SQL Server、PostgreSQL以及SQLiteSELECT 1+1;
以上查询语句中只有SELECT子句,没有FROM子句。这种语法并不属于SQL标准,而是数据库管理系统的扩展功能。查询返回了一个算术表达式的值。
1+1---2
除了Oracle之外的其他4种数据库都支持这种语法。对于Oracle而言,我们可以使用以下等价的查询语句:
-- Oracle和MySQLSELECT 1+1FROM dual;
其中dual是Oracle数据库中的一个特殊的表,它只有一个字段并且只包含一行数据,可以方便快速检索信息。另外,MySQL也支持这种查询语句。
2.2 实现数据过滤
在实际应用中,我们通常并不需要返回表中的全部数据,大多数情况下只需要检索满足特定条件的记录。例如,查找某个部门中的员工或者当前用户未完成的订单。
在SQL语句中,我们可以使用关键字WHERE指定数据的过滤条件。例如,以下语句查找姓名为“刘备”的员工信息:
SELECT emp_name, sex, hire_date,salaryFROM employeeWHERE emp_name = '刘备';
其中,WHERE子句位于FROM子句之后,用于指定一个或者多个过滤条件。只有满足条件的数据才会返回,其他数据将被忽略。该语句返回的结果如下。
emp_name|sex|hire_date|salary--------|---|----------|--------刘备 |男 |2000-01-01|30000.00
对于Oracle而言,DATE数据类型中不仅包含了日期信息,也包含时间信息。因此以上查询返回的入职日期为“2000-01-01 00:00:00”,而不是“2000-01-01”。
这种通过查询条件过滤数据的操作在关系运算中被称为选择(Selection)。选择操作是针对表进行的水平过滤,保留满足条件的记录生成新的关系表。选择操作的过程如图2.2所示。
WHERE子句中的查询条件也被称为谓词(Predicate)。谓词运算的结果可能为真(True)、假(False)或者未知(Unknown)。当谓词运算的结果为真时表示数据满足查询条件,返回相应的数据;否则表示数不据满足查询条件,不返回相应的数据。
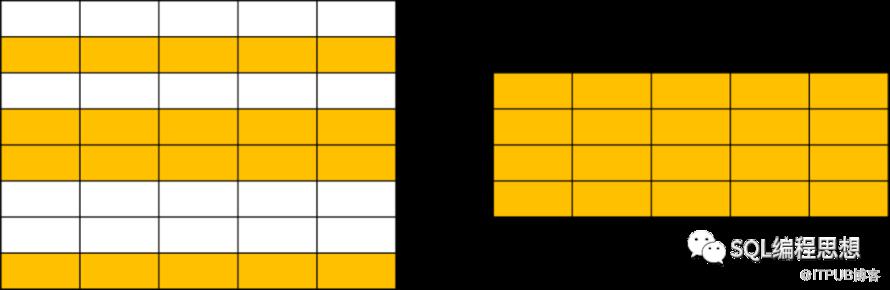
图2.2 选择操作示意图
2.2.1 简单过滤条件
最常见的查询条件就是比较运算符,比较运算符可以比较两个数据的大小,包括字符、数字以及日期类型数据的比较。表2.1列出了SQL中的各种比较运算符。
表2.1 SQL比较运算符
运算符 |
描述 |
示例 |
= |
等于 |
emp_id = 1 |
!=或者<> |
不等于 |
sex != '男' |
> |
大于 |
salary > 10000 |
>= |
大于等于 |
hire_date >= DATE '2018-01-01' |
< |
小于 |
bonus < 5000 |
<= |
小于等于 |
dept_id <= 2 |
BETWEEN |
位于指定范围之内 |
salary BETWEEN 10000 AND 15000 |
IN |
属于指定列表之中 |
emp_name IN ('刘备', '关羽', '张飞') |
提示:Oracle数据库中的^=也表示不等于运算符。Microsoft SQL Server中的!<和!>分别表示大于等于和小于等于运算符。
我们来看一个日期数据的比较运算,以下语句查找2018年1月1日之后入职的员工:
-- Oracle、MySQL以及PostgreSQLSELECT emp_name, hire_dateFROM employeeWHERE hire_date >= DATE'2018-01-01';
查询条件中的DATE'2018-01-01'定义了一个日期常量值。如果使用Microsoft SQLServer或者SQLite,指定日期常量时可以直接使用字符串字面值:
-- Microsoft SQL Server、SQLite、MySQL以及PostgreSQLSELECT emp_name, hire_dateFROM employeeWHERE hire_date >='2018-01-01';
查询返回的结果如下。
emp_name|hire_date--------|----------蒋琬 |2018-01-28黄权 |2018-03-14糜竺 |2018-03-27邓芝 |2018-11-11简雍 |2019-05-11孙乾 |2018-10-09
1. BETWEEN运算符
BETWEEN运算符用于查找指定范围之内的数据。例如,以下语句查找月薪位于10000和15000之间的员工:
SELECT emp_name, salaryFROM employeeWHERE salary BETWEEN 10000 AND15000;
查询返回的结果如下。
emp_name|salary--------|--------孙尚香 |12000.00赵云 |15000.00法正 |10000.00
从查询结果可以看出,BETWEEN运算符包含了两端的值(10000和15000)。
2. IN运算符
IN运算符用于查找指定列表中的数据。例如,以下语句查找姓名为“刘备”、“关羽”或者“张飞”的员工:
SELECT emp_id, emp_nameFROM employeeWHERE emp_name IN ('刘备', '关羽', '张飞');
查询返回的结果如下。
emp_id|emp_name------|--------2| 关羽1|刘备3| 张飞
员工的姓名只要等于列表中的任何一个值都会返回对应的结果。
提示:IN运算符还有一个常见的用途就是匹配子查询返回的结果,我们将会在第7章介绍子查询时给出相关示例。
2.2.2 空值判断条件
在数据库中,空值(NULL)是一个特殊值,表示缺失或者未知的数据。与其他编程语言(例如Java、C++)不同,在SQL语句中判断一个值是否为空不能使用等于或者不等于运算符。例如,以下语句使用等于运算符查找没有上级领导(manager字段为空)的员工:
-- 空值判断的错误示例SELECT emp_name, managerFROM employeeWHERE manager = NULL;
该查询没有返回任何结果,不过我们知道员工表中确实存在这样的数据(“刘备”)。问题的原因在于将一个数据与未知数据进行比较运算的结果未知,查询条件中的未知结果不会返回数据。
实际上,即使将两个未知数据进行比较,运算结果也是未知。以下运算的结果均为未知:
NULL = 0NULL != 0NULL = ''NULL != ''NULL = NULLNULL != NULL
0和空字符串都是已知数据,和未知数据的比较结果都是未知。同样,我们既不能认为两个未知数据相等,也不能认为它们不相等。
为了实现空值的判断,SQL引入了两个特殊的运算符:ISNULL和IS NOT NULL,它们分别表示某个字段或者表达式的结果未知(空值)或者已知(非空)。因此,查找没有上级领导的员工应该使用以下判断条件:
SELECT emp_name, managerFROM employeeWHERE manager IS NULL;
如果员工的manager字段为空,就会返回相应的数据。查询返回的结果如下。
emp_name|manager--------|-------刘备 |
数据显示,“刘备”是公司的最高领导,因为他没有上级。
另外,ISNOT NULL运算符可以查找数据不为空的字段和表达式。例如,以下语句查找拥有奖金的员工:
SELECT emp_name, bonusFROM employeeWHERE bonus IS NOT NULL;
查询返回的结果如下。
emp_name|bonus--------|--------刘备 |10000.00关羽 |10000.00张飞 |10000.00诸葛亮 | 8000.00孙尚香 | 5000.00赵云 | 6000.00法正 |5000.00庞统 | 2000.00蒋琬 | 1500.00
2.2.3 文本模糊查找
当我们不能完全确定需要查找的信息时,可以使用SQL模糊查找的功能进行文本检索,对应的运算符是LIKE。
假如我们想要知道姓“关”的员工有哪些,可以使用以下查询:
SELECT emp_nameFROM employeeWHERE emp_name LIKE '关%';
其中,LIKE关键字指定了一个字符串匹配模式,查找姓名以“关”字开头的员工。查询返回的结果如下。
emp_name--------关兴关平关羽
LIKE运算符支持以下两个通配符,可以用于指定匹配的模式:
百分号(%),表示匹配零个或者多个任意字符。
下划线(_),表示匹配一个任意字符。
以下是一些常用的模式和匹配的字符串:
LIKE 'en%',匹配以“en”开始的字符串,例如“english”、“end”。
LIKE '%en%',匹配包含“en”的字符串,例如“length”、“when”。
LIKE '%en',匹配以“en”结束的字符串,例如“ten”、“when”。
LIKE 'Be_',匹配以“Be”开头,再加上一个任意字符的字符串。例如“Bed”、“Bet”。
LIKE '_e%',匹配一个任意字符加上“e”开始的字符串,例如“he”、“year”。
由于百分号和下划线是LIKE运算符中的通配符,如果我们查找的模式中包含了“%”或者“_”,需要用到转义字符(escapecharacter)。
转义字符可以将通配符当作普通字符使用。我们首先创建一个测试表:
CREATE TABLE t_like(c1 VARCHAR(200));INSERT INTO t_like(c1) VALUES ('项目进度:25%已完成');INSERT INTO t_like(c1) VALUES ('记录日期:2021年5月25日');
表t_like只有一个字段c1,数据类型为字符串,表中包含两条记录。假如现在我们需要查找包含“25%”的数据,其中百分号是要查找的内容而不是任意多个字符,可以使用转义字符进行查找:
SELECT c1FROM t_likeWHERE c1 LIKE '%25#%%' ESCAPE'#';
ESACPE关键字为LIKE运算符指定了一个#符号作为转义字符,因此查找模式中的第二个%代表了百分号,其他的%则是通配符。该查询返回的结果如下。
c1-----------项目进度:25%已完成
提示:对于MySQL和PostgreSQL而言,如果省略ESCAPE子句,默认的转义字符为反斜杠(\)。
使用LIKE运算符进行文本查找时,还需要注意英文字母的大小写问题。例如,以下语句使用大写字母查找员工的电子邮箱:
SELECT emailFROM employeeWHERE email LIKE 'M%';
该查询在不同的数据库中返回的结果不同。
-- MySQL、Microsoft SQL Server以及SQLite----------------madai@shuguo.commizhu@shuguo.com-- Oracle以及PostgreSQL-----
对于LIKE运算符,MySQL、MicrosoftSQL Server以及SQLite中的字符串默认不区分大小写,Oracle和PostgreSQL中的字符串默认区分大小写。
提示:PostgreSQL提供了不区分大小写的ILIKE运算符,使用方法和LIKE相同。Microsoft SQL Server支持使用方括号匹配([])或者不匹配([^])指定范围或集合内的任何单个字符,例如[a-z]表示匹配字符a到字符z。
NOT LIKE运算符可以执行与LIKE运算符相反的操作,也就是返回不匹配某个模式的文本。例如,以下语句查找t_like表中不包含“25%”的记录:
SELECT c1FROM t_likeWHERE c1 NOT LIKE '%25#%%' ESCAPE'#';
查询返回的结果如下。
c1---------------记录日期:2021年5月25日
2.2.4 组合过滤条件
如果只能使用单个过滤条件,SQL语句就无法满足复杂的查询需求,例如查找月薪超过10000的女性员工。为此,SQL借助于逻辑代数中的运算提供了三个逻辑运算符,可以基于多个运算符构建复杂的过滤条件。
1. 逻辑与(AND)运算符
对于逻辑与运算符,只有当运算符两边的条件都为真时才返回数据,否则查询不返回数据。例如,以下语句使用AND运算符查找月薪超过10000的女性员工:
SELECT emp_name, sex, salaryFROM employeeWHERE sex = '女'AND salary > 10000;
查询返回的结果如下。
emp_name|sex|salary--------|---|--------孙尚香 |女 |12000.00
女性员工中只有“孙尚香”的月薪超过了10000。
2. 逻辑或(OR)运算符
对于逻辑或运算符,只要运算符两边的条件有一个为真就返回数据,否则查询不返回数据。例如,我们可以使用OR运算符实现第2.2.1节中的IN运算符示例:
SELECT emp_id, emp_nameFROM employeeWHERE emp_name = '刘备' OR emp_name = '关羽' OR emp_name = '张飞';
该查询同样返回了姓名为“刘备”、“关羽”或者“张飞”的员工。
对于逻辑运算符AND和OR,SQL使用短路运算(Short-CircuitEvaluation)。也就是说,只要左边的表达式能够决定最终的结果就不计算右边的表达式。例如,以下语句不会产生除零错误:
SELECT *FROM employeeWHERE 1 = 0 AND 1/0 = 1;SELECT *FROM employeeWHERE 1 = 1 OR 1/0 = 1;
第一个查询使用了AND运算符,由于1=0结果为假,查询肯定不会返回任何结果,也就不会计算右边的1/0。第二个查询使用了OR运算符,由于1=1结果为真,查询返回全部员工,同样不会计算右边的1/0。
提示:SQL语句的短路运算方法可以减少某些情况下的表达式计算,提高运算的效率。
3. 逻辑非(NOT)运算符
逻辑非运算符与其他运算符一起使用时表示将随后的运算结果取反知:
NOT >,查找不大于(小于等于)指定值的数据。也可以使用NOT=、NOT<等运算符。
NOT BETWEEN,查找位于指定范围之外的数据。
NOT IN,查找不在指定列表之中的数据。
NOT LIKE,查找不匹配某个模式的文本。
NOT expr IS NULL,查找expr不为空的数据,等价于exprIS NOT NULL。
例如,以下语句查找奖金小于2000或者大于10000的员工:
SELECT emp_name, bonusFROM employeeWHERE NOT bonus BETWEEN2000 AND 10000;
查询返回的结果如下。
emp_name|bonus--------|-------蒋琬 |1500.00
虽然有很多员工没有奖金(bonus字段为空),但是查询并没有返回这些员工的信息,因为未知结果取反之后仍然未知。
我们还需要注意多个运算符之间的优先级问题。一般来说,比较运算符的优先级比逻辑运算符更高,逻辑运算符中NOT比AND优先级高,AND比OR优先级高。通常优先级高的运算符先执行,相同级别的运算符从左至右执行。
我们想要知道人力资源部(dept_id=2)或者财务部(dept_id=3)中有哪些员工拥有奖金,如果使用以下查询语句:
SELECT emp_name, dept_id, bonusFROM employeeWHERE dept_id = 2 ORdept_id = 3AND bonus IS NOT NULL;
返回的结果如下:
emp_name|dept_id|bonus--------|-------|-------诸葛亮 | 2|8000.00黄忠 | 2|魏延 | 2|孙尚香 | 3|5000.00
“黄忠”和“魏延”并没有奖金,不是我们期望的结果。那么问题出在哪里了呢?因为AND运算符比OR运算符的优先级高,以上查询实际返回了人力资源部(dept_id=2)的员工,以及财务部(dept_id=3)中拥有奖金的员工。
如果想要获得我们期望的结果,可以使用圆括号调整运算符的优先级,例如:
SELECT emp_name, dept_id, bonusFROM employeeWHERE (dept_id = 2 ORdept_id = 3) AND bonus IS NOT NULL;
查询返回的结果如下。
emp_name|dept_id|bonus--------|-------|-------诸葛亮 | 2|8000.00孙尚香 | 3|5000.00
注意:由于各种数据库中的实现不同,导致运算符的优先级别可能存在差异,我们可以通过圆括号明确指定优先级。
2.2.5 排除重复数据
查询语句有可能会返回重复的数据,我们可以使用DISTINCT关键字排除查询结果中的重复记录。例如,以下语句查找员工表中的所有不同性别:
SELECT DISTINCT sexFROM employee;
其中,DISTINCT关键字位于SELECT之后,而不是像其他过滤条件一样位于WHERE子句中。查询返回的结果如下。
sex---男女
提示:在Oracle数据库中,可以使用UNIQUE关键字替代DISTINCT。在MySQL中,可以使用DISTINCTROW关键字替代DISTINCT。
另外,DISTINCT也可以用于多个字段的去重。例如,以下语句查找不同部门编号和性别的所有组合:
SELECT DISTINCT dept_id,sexFROM employee;
查询返回的结果如下。
dept_id|sex-------|---1|男2|男3|女4|男4|女5|男
提示:除了DISTINCT之外,我们也可以使用ALL关键字返回不排除重复数据的结果。不过通常没有必要,因为ALL是默认的行为。
2.3 从无序到有序
读者在运行前文中的示例时得到的结果可能与书中的结果不完全一致,主要是显示顺序可能不同。这是因为SQL查询不保证返回结果时的顺序。如果我们想要按照某种规则对结果进行排序显示,例如按照工资从高到低进行排序,需要使用ORDERBY子句。
2.3.1 基于单个字段排序
基于单个字段值的排序操作被称为单列排序。单列排序的语法如下:
SELECT col1, col2, ...FROM t[WHERE ...]ORDER BY col1 [ASC | DESC];
其中,ORDERBY子句用于指定排序,ASC表示按照升序排序(Ascending),DESC表示按照降序排序(Descending),默认按照升序排序。排序操作的过程如图2.3所示。
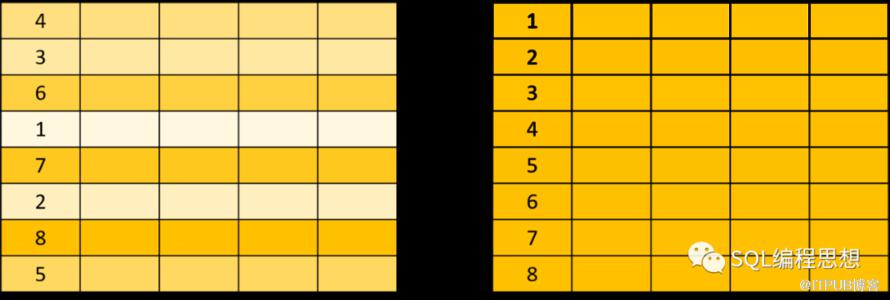
图2.3 排序操作示意图
以下语句查找公司的女性员工,并且按照月薪从高到低排序显示:
SELECT emp_name, salaryFROM employeeWHERE sex = '女'ORDER BY salary DESC;
查询返回的结果如下。
emp_name|salary--------|--------孙尚香 |12000.00赵氏 | 6600.00孙丫鬟 | 6000.00
提示:对于升序排序,数字按照从小到大的顺序排列,字符按照编码的顺序排列,日期和时间按照从早到晚的顺序排列;对于降序排序则正好相反。
2.3.2 基于多个字段排序
如果排序字段中存在相同的数据,那么它们的排序顺序是随机的。为了进一步明确这些数据的排序顺序,可以使用多列排序。
多列排序是指基于多个字段值的排序,多个字段使用逗号进行分隔。多列排序的语法如下:
SELECT col1, col2, ...FROM t[WHERE ...]ORDER BY col1 [ASC | DESC], col2[ASC | DESC], ...;
首先,查询基于第一个字段进行排序,对于第一个字段排序相同的数据,再基于第二个字段进行排序,并且依此类推。
以下语句查找销售部(dept_id=5)的员工信息,并且按照月薪从高到低排序,如果月薪相同则按照入职先后进行排序:
SELECT emp_name, salary, hire_dateFROM employeeWHERE dept_id = 5ORDER BY salary DESC, hire_date;
查询返回的结果如下。
emp_name|salary |hire_date--------|--------|----------法正 |10000.00|2017-04-09简雍 | 4800.00|2019-05-11...蒋琬 | 4000.00|2018-01-28邓芝 | 4000.00|2018-11-11
其中,“蒋琬”和“邓芝”的月薪相同,但是“蒋琬”排在了“邓芝”之前,因为他的入职日期更早。
2.3.3 基于表达式排序
除了基于字段的值进行排序之外,我们也可以基于表达式的值进行排序。例如,以下语句查找行政管理部(dept_id=1)的员工,并且按照全年总收入进行排序:
SELECT emp_name, salary * 12 +bonusFROM employeeWHERE dept_id = 1ORDER BY salary * 12 + bonus;
员工的全年总收入等于年薪(salary*12)加奖金(bonus),查询返回的结果如下。
emp_name|salary * 12 + bonus--------|-------------------张飞 | 298000.00关羽 | 322000.00刘备 | 370000.00
另外,我们也可以使用字段或者表达式在SELECT列表中出现的位置指定数据的排序。例如,上面的查询语句可以改写如下:
SELECT emp_name, salary * 12 +bonusFROM employeeWHERE dept_id = 1ORDER BY 2;
表达式salary* 12 + bonus是查询返回的第2列,因此ORDERBY 2也表示按照全年总收入进行排序。
2.3.4 空值的排序位置
空值(NULL)在数据库中表示未知或者缺失的数据,如果排序的字段中存在空值时应该如何处理呢?以下语句查找人力资源部(dept_id=2)中的员工,并且按照奖金从低到高进行排序显示:
SELECTemp_name, bonusFROMemployeeWHEREdept_id = 2ORDER by bonus;
不同数据库系统对于空值的排序位置采用了不同的处理方式。MySQL、MicrosoftSQL Server以及SQLite中的空值排在了最前,查询返回的结果如下。
--- MySQL、Microsoft SQL Server以及SQLiteemp_name|bonus--------|-------黄忠 |魏延 |诸葛亮 |8000.00
Oracle和PostgreSQL中的空值排在了最后,查询返回的结果如下。
--- Oracle以及PostgreSQLemp_name|bonus--------|-------诸葛亮 |8000.00黄忠 |魏延 |
另外,Oracle、PostgreSQL以及SQLite支持使用NULLSFIRST关键字将空值排在最前,或者使用NULLS LAST关键字将空值排在最后。以下查询语句返回的结果与上面的MySQL和MicrosoftSQL Server一致:
-- Oracle、PostgreSQL以及SQLiteSELECT emp_name, bonusFROM employeeWHERE dept_id = 2ORDER by bonus NULLS FIRST;
总而言之,对于空值的排序:
MySQL、MicrosoftSQL Server以及SQLite认为排序时空值最小,升序排序时空值排在最前,降序排序时空值排在最后。
Oracle和PostgreSQL认为排序时空值最大,升序排序时空值排在最后,降序排序时空值排在最前。
Oracle、PostgreSQL以及SQLite支持使用NULLSFIRST和NULLS LAST指定空值的排序位置。
提示:指定空值的排序位置还有一个更通用的解决方法,就是利用函数将空值转换为一个固定的值。我们将会在第5章中对此进行介绍。
2.3.5 中文的排序方式
在创建数据库或者表时,我们通常会指定一个字符集和排序规则。
字符集(Charset)决定了数据库能够存储哪些字符,比如ASCII字符集只能存储简单的英文、数字和一些控制字符,GB2312字符集可以存储中文,Unicode字符集能够支持世界上的各种文字。
排序规则(Collation)定义了字符集中字符的排序顺序,包括是否区分大小写,是否区分重音等。对于中文而言,排序方式与英文有所不同,中文通常需要按照拼音、偏旁部首或者笔画进行排序。
如果想要支持中文排序,最简单的方式就是使用支持中文排序的字符集和排序规则。如果使用的字符集和排序规则不满足我们的排序需求,可以通过其他方法实现。
Oracle默认使用AL32UTF8字符编码,中文按照偏旁部首进行排序。我们可以通过一个转换函数实现其他方式的中文排序,以下查询按照员工姓名的拼音进行排序:
-- Oracle实现中文拼音排序SELECT emp_nameFROM employeeWHERE dept_id = 4ORDER BYNLSSORT(emp_name,'NLS_SORT = SCHINESE_PINYIN_M');
其中NLSSORT()是Oracle提供的一个系统函数,用于返回按照指定排序规则编码的字符序列,SCHINESE_PINYIN_M表示中文的拼音排序规则。查询返回的结果如下:
EMP_NAME--------关平关兴廖化马岱张苞赵氏赵统赵云周仓
除了按照拼音排序之外,Oracle还支持按照偏旁部首(SCHINESE_RADICAL_M)以及笔画(SCHINESE_STROKE_M)进行中文排序。
MySQL 8.0默认使用utf8mb4字符编码,中文按照偏旁部首进行排序。我们可以通过一个转换函数实现其他方式的中文排序,以下查询按照员工姓名的拼音进行排序:
-- MySQL实现中文拼音排序SELECT emp_nameFROM employeeWHERE dept_id = 4ORDER BY CONVERT(emp_name USINGGBK);
其中,CONVERT()是一个MySQL系统函数,用于转换数据的字符集编码,中文GBK字符集默认使用拼音进行排序。查询返回的结果和上面的Oracle示例相同。
Microsoft SQL Server中的字符集和排序规则是同一个概念,安装数据库时默认根据操作系统所在的区域进行设置,中国地区默认使用Chinese_PRC_CI_AS排序规则,对于中文按照偏旁部首进行排序。我们可以通过COLLATE关键字实现其他方式的中文排序,以下查询按照员工姓名的拼音进行排序:
-- Microsoft SQL Server 实现中文拼音排序SELECT emp_nameFROM employeeWHERE dept_id = 4ORDER BY emp_name COLLATE Chinese_PRC_CI_AI_KS_WS;
其中,COLLATE表示按照某种排序规则进行排序,Chinese_PRC_CI_AI_KS_WS表示中文拼音排序规则。查询返回的结果和上面的Oracle示例一样。
Microsoft SQL Server也支持中文按照笔画进行排序(Chinese_PRC_Stroke_CI_AS)。
PostgreSQL默认使用UTF-8[lh13] [xd14] 编码字符集,中文按照偏旁部首进行排序。我们可以通过COLLATE关键字实现其他方式的中文排序,以下查询按照员工姓名的拼音进行排序:
-- PostgreSQL 实现中文拼音排序SELECT emp_nameFROM employeeWHERE dept_id = 4ORDER BY emp_name COLLATE"zh_CN";
其中,COLLATE表示按照某种排序规则进行排序,zh_CN表示中文拼音排序规则。查询返回的结果和上面的Oracle示例一样。
SQLite默认使用UTF-8字符编码,中文按照偏旁部首进行排序,不支持其他的排序方式。
2.4 限定结果数量
默认情况下,查询语句会返回所有满足过滤条件的数据。但是有些时候我们只需要查看其中的部分结果,常见的这类应用场景包括Top-N排行榜和分页查询。
2.4.1 Top-N排行榜
我们经常会看到各种Top-N排行榜,例如销量排行榜、十大热门游戏等。Top-N排行榜的原理就是先对数据进行排序,然后返回前N条记录。SQL标准定义了FETCH和OFFSET子句,可以用于限制返回结果的数量。例如,以下语句查找月薪排名前5的员工:
-- Oracle、Microsoft SQL Server以及PostgreSQLSELECT emp_name, salaryFROM employeeORDER BY salary DESCOFFSET 0 ROWSFETCH FIRST 5 ROWS ONLY;
其中,ORDERBY子句表示按照月薪从高到低进行排序,OFFSET子句表示跳过0行记录,FETCH子句表示获取前5条记录,也就是月薪Top-5的员工。查询返回的结果如下。
emp_name|salary--------|--------刘备 |30000.00关羽 |26000.00张飞 |24000.00诸葛亮 |24000.00赵云 |15000.00
目前只有Oracle、MicrosoftSQL Server以及PostgreSQL支持这种标准语法。其中Oracle和PostgreSQL中的OFFSET子句可以省略,默认表示跳过0行记录。
除了标准SQL之外,还有一种常见的LIMIT子句也可以实现相同的功能,例如:
-- MySQL、PostgreSQL以及SQLiteSELECT emp_name, salaryFROM employeeORDER BY salary DESCLIMIT 5 OFFSET 0;
其中,ORDERBY子句表示按照月薪从高到低进行排序,OFFSET子句表示跳过0行记录,LIMIT子句表示获取前5条记录,也就是月薪Top-5的员工。MySQL、PostgreSQL以及SQLite实现了这种LIMIT语法。另外,OFFSET子句可以省略,默认表示跳过0行记录。
如果使用MicrosoftSQL Server,我们也可以利用TOP关键字实现相同的功能。例如:
-- Microsoft SQL ServerSELECT TOP(5) emp_name,salaryFROM employeeORDER BY salary DESC;
其中,ORDERBY子句表示按照月薪从高到低进行排序,TOP(5)表示返回前5条记录。
2.4.2 数据分页显示
有时候查询的结果可能包含成千上万条记录,因此在前端显示时需要采用分页的方式,也就是每次只显示一定数量(例如10条记录)的结果,同时提供“下一页”、“上一页”等翻页按钮。这种分页查询的原理就是先跳过指定的行数,返回随后的N条记录。实际上,Top-N排行榜是分页查询的一个特殊情况。
分页查询也有两种实现方式,第一种方式就是使用SQL标准中的FETCH和OFFSET子句。假如前端页面每次显示10名员工记录,现在用户点击了“第2页”,也就是返回第11条到第20条记录。我们可以使用以下查询语句:
-- Oracle、Microsoft SQL Server以及PostgreSQLSELECT emp_name, salaryFROM employeeORDER BY salary DESCOFFSET 10 ROWSFETCH FIRST 10 ROWS ONLY;
其中,ORDERBY子句表示按照月薪从高到低进行排序,OFFSET子句表示跳过10条记录,FETCH子句表示获取随后的10条记录。查询返回的结果如下。
emp_name|salary--------|-------关兴 |7000.00关平 |6800.00赵氏 |6600.00...简雍 |4800.00孙乾 |4700.00
除了以上基本的用法之外,FETCH子句还支持一些扩展选项,完整的语法如下:
[OFFSET m {ROW | ROWS}]FETCH {FIRST | NEXT} [num_rows | nPERCENT] {ROW | ROWS} {ONLY | WITH TIES};
其中,方括号([])表示可选项,大括号({ })表示必选项,竖线(|)表示二选一。每个选项的作用如下:
OFFSET表示偏移量,即从第m+1行开始返回数据。默认偏移量为0,表示从第1行开始返回。ROW和ROWS关键字等价。
FETCH表示返回多少数据,FIRST和NEXT关键字等价。
num_rows表示按照行数为单位限制返回的数据,nPERCENT表示按照百分比限制返回的数据,ROW和ROWS关键字等价。
ONLY和WITH TIES的区别在于最后如果有多个排名相同的记录,WITHTIES会返回更多的数据,ONLY则不会返回更多的数据。
目前只有Oracle12c以上版本完全支持n PERCENT和WITHTIES选项。例如:
-- OracleSELECT emp_name, salaryFROM employeeORDER BY salary DESCFETCH FIRST 10 PERCENT ROWS ONLY;
查询返回的结果如下。
EMP_NAME|SALARY--------|------刘备 | 30000关羽 | 26000张飞 | 24000
由于员工表中共有25名员工,百分之十约为3人。
以下查询使用了WITHTIES选项:
-- OracleSELECT emp_name, salaryFROM employeeORDER BY salary DESCFETCH FIRST 10 PERCENT ROWS WITHTIES;
查询返回的结果如下。
EMP_NAME|SALARY--------|------刘备 | 30000关羽 | 26000张飞 | 24000诸葛亮 | 24000
由于“诸葛亮”和“张飞”的月薪相同,使用WITHTIES子句时返回了4条记录。
另外,PostgreSQL13开始支持WITH TIES选项。
第二种实现分页查询的方法就是利用LIMIT和OFFSET子句。例如:
-- MySQL、PostgreSQL以及SQLiteSELECT emp_name, salaryFROMemployeeORDER BY salary DESCLIMIT 10 OFFSET 10;
其中,ORDERBY子句表示按照月薪从高到低进行排序,OFFSET子句表示跳过10条记录,LIMIT子句获取随后的10条记录。
MySQL和SQLite中以下两种语法的作用相同,注意偏移量n和返回行数m出现的顺序:
LIMIT m OFFSET nLIMIT n, m
2.5 SQL注释
SQL语句可以像其他编程语言一样使用注释。注释可以提高代码的可读性和可维护性,但不会被服务器执行。SQL中的注释分为单行注释和多行注释。
2.5.1 单行注释
单行注释以两个连字符(--)开始,直到这一行结束。例如:
SELECT DISTINCT sex -- DISTINCT关键字用于排除重复数据FROM employee;
我们已经在前文中多次利用单行注释表示不同数据库中的实现差异。
注意:MySQL中连字符(--)后面需要有一个空格的。另外,MySQL中的井号(#)也可以表示单行注释的开始。
2.5.2 多行注释
SQL语句使用C语言风格的多行注释(/*… */),例如:
/* 备注:SQL查询条件示例作者:TonyDong日期:2021-01-01*/SELECT emp_name, sex, hire_date,salaryFROM employeeWHERE emp_name = '刘备';
多行注释中可以嵌套单行注释,但是不能嵌套其他的多行注释。
另外,在调试程序时,我们也可以通过注释临时禁用部分语句的执行。
2.5.3 特殊注释
除了以上两种注释方式之外,某些数据库还提供了一些特殊的注释,用于特定的场景。
Oracle中的特殊注释--+和/*+hint */用于表示查询优化器提示,可以帮助数据库优化查询语句。MySQL中的/*+hint */用于表示查询优化器提示,可以帮助数据库优化查询语句。另外,MySQL还提供了一种可以被执行的注释。例如:
CREATE TABLE t1(a INT KEY) /*!50110 KEY_BLOCK_SIZE=1024*/;
如果是MySQL5.1.10以上版本,创建表t1时会使用KEY_BLOCK_SIZE参数,更低版本的MySQL或者其他数据库则会忽略该参数,从而实现跨版本和数据库产品的可移植性。
2.6 小结
SQL使用SELECT语句查询表中的数据,查询条件(WHERE)可以用于数据的过滤,排序操作(ORDERBY)可以按照指定的顺序显示结果,FETCH/LIMIT和OFFSET子句可以限制返回结果的数量和偏移量。另外,注释可以让我们编写的SQL语句更易理解和维护。
原文作者:SQL编程思想;如有侵权,请联系管理员删除。

