上一篇我们介绍了如何通过窗口函数实现移动平均值和累计求和分析,今天继续给大家分享两个案例:分类排名与累积分布
关于聚合函数的语法可以参考这篇文章。
ROW_NUMBER()函数可以为分区中的每行数据分配一个序列号,序列号从1开始。
RANK()函数返回当前行在分区中的名次。如果存在名次相同的数据,后续的排名将会产生跳跃。
DENSE_RANK()函数返回当前行在分区中的名次。即使存在名次相同的数据,后续的排名也是连续值。
PERCENT_RANK()函数以百分比的形式返回当前行在分区中的名次。如果存在名次相同的数据,后续的排名将会产生跳跃。
CUME_DIST()函数计算当前行在分区内的累积分布。
NTILE()函数将分区内的数据分为N等份,并返回当前行所在的分片位置。
排名窗口函数不支持动态的窗口大小选项,而是以整个分区作为分析的窗口。
分类排名
以下查询使用4个不同的排名函数计算每个员工在其部门内的月薪排名:
SELECT d.dept_name AS "部门名称", e.emp_name AS "姓名", e.salary AS "月薪",ROW_NUMBER() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS "row_number",RANK() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS "rank",DENSE_RANK() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS "dense_rank",PERCENT_RANK() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS "percent_rank"FROM employee eJOIN department d ON (e.dept_id = d.dept_id);
其中,4个窗口函数的OVER子句完全相同,PARTITIONBY表示按照部门进行分区,ORDER BY表示按照月薪从高到低进行排序。该查询返回的结果如下。
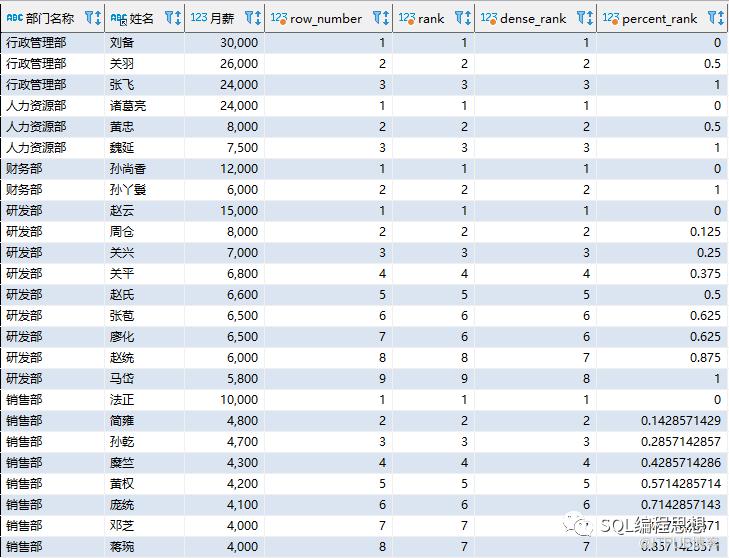
我们以“研发部”为例,ROW_NUMBER()函数为每个员工分配了一个连续的数字编号,其中“廖化”和“张苞”的月薪相同,但是编号不同。
提示:我们也可以使用COUNT()窗口函数产生和ROW_NUMBER()函数相同的结果,读者可以自行尝试。
另外,以上示例中4个窗口函数的OVER子句完全相同。此时,我们可以采用一种更简单的写法:
-- MySQL、PostgreSQL以及SQLiteSELECT d.dept_name AS "部门名称", e.emp_name AS "姓名", e.salary AS "月薪",ROW_NUMBER() OVER w AS "row_number",RANK() OVER w AS "rank",DENSE_RANK() OVER w AS "dense_rank",PERCENT_RANK() OVER w AS "percent_rank"FROM employee eJOIN department d ON (e.dept_id = d.dept_id)WINDOW w AS (PARTITION BY e.dept_id ORDER BY e.salary DESC);
我们在查询语句的最后使用WINDOW子句定义了一个窗口变量w,然后在所有窗口函数的OVER子句中使用了该变量。该查询返回的结果和上面的示例相同。
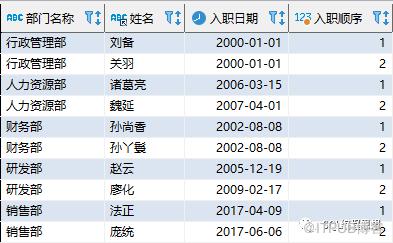
WITH ranked_emp AS (SELECT d.dept_name,e.emp_name,e.hire_date,ROW_NUMBER() OVER (PARTITION BY e.dept_id ORDER BY e.hire_date) AS rnFROM employee eJOIN department d ON (e.dept_id = d.dept_id))SELECT dept_name "部门名称", emp_name "姓名",hire_date "入职日期", rn "入职顺序"FROM ranked_empWHERE rn <= 2;
其中,ranked_emp是一个通用表表达式,包含了员工在其部门内的入职顺序。然后我们在主查询语句中返回了每个部门前2名入职的员工:
累积分布
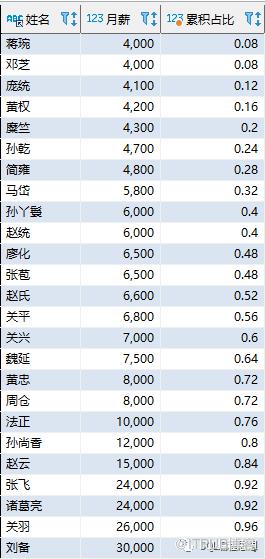
CUME_DIST()函数可以返回当前行在分区内的累积分布,也就是排名在当前行之前(包含当前行)所有数据所占的比率,取值范围为大于0并且小于等于1。例如,以下查询返回了所有员工按照月薪排名的累积分布情况:
SELECT emp_name AS "姓名", salary AS "月薪",CUME_DIST() OVER(ORDER BY salary) AS "累积占比"FROM employee;
其中,OVER子句没有指定分区选项,因此CUME_DIST()函数会将全体员工作为一个整体进行分析。ORDER BY选项表示按照月薪从低到高进行排序。该查询返回的结果如下:
SELECT emp_name AS "姓名", hire_date AS "入职日期",NTILE(5) OVER(ORDER BY hire_date) AS "分组位置"FROM employee;
其中,OVER子句没有指定分区选项,因此NTILE()函数会将全体员工作为一个整体进行分析。ORDER BY选项表示按照入职先后进行排序。该查询返回的结果如下:
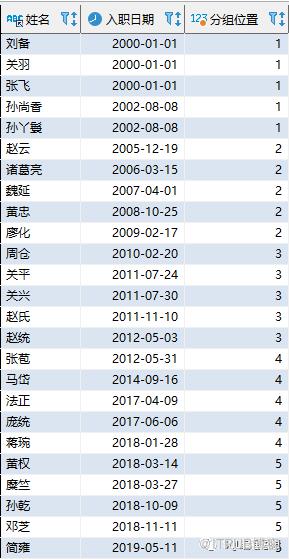
分组位置为1的是最早入职的20%员工,分组位置为5的是最晚入职的20%员工。
原文作者:SQL编程思想;如有侵权,请联系管理员删除。

