本文是MySQL性能优化的第一部分:库表结构优化。
1.1 数据库设计

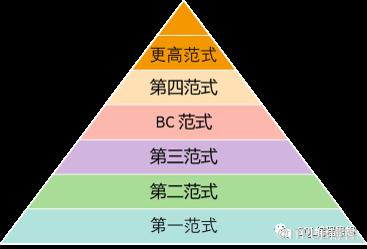
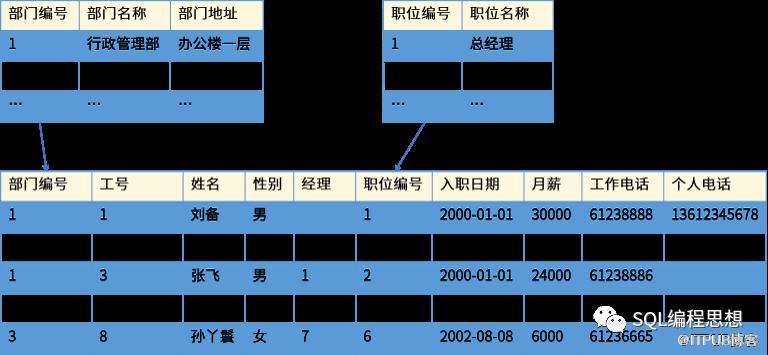
增加冗余字段;
增加计算列;
将小表合成大表等。
1.2 选择数据类型

1.3 数字类型
1.3.1 整数类型
| 数字类型 | 存储(字节) | 有符号类型最小值 | 有符号类型最大值 | 无符号类型最小值 | 无符号类型最大值 |
|---|---|---|---|---|---|
| TINYINT | 1 | -128 | 127 | 0 | 255 |
| SMALLINT | 2 | -32768 | 32767 | 0 | 65535 |
| MEDIUMINT | 3 | -8388608 | 8388607 | 0 | 16777215 |
| INT | 4 | -2147483648 | 2147483647 | 0 | 4294967295 |
| BIGINT | 8 | 263 | 263-1 | 0 | 264-1 |
1.3.2 实数类型
CREATE TABLE t(d1 DOUBLE, d2 DOUBLE);
INSERT INTO t(d1, d2) VALUES (101.40, 80.0);

SELECT *
FROM t
WHERE d1-d2=21.4; -- 101.40-80.0
d1|d2|
--+--+
1.4 字符串类型
1.4.1 CHAR与VARCHAR
CREATE TABLE t (c1 CHAR, c5 CHAR(5));
INSERT INTO t VALUES ('a','a');

mysql> select concat(c1, '!'), concat(c5, '!') from t;
+-----------------+-----------------+
| concat(c1, '!') | concat(c5, '!') |
+-----------------+-----------------+
| a!              | a!              |
+-----------------+-----------------+

mysql> SET sql_mode = 'PAD_CHAR_TO_FULL_LENGTH';
Query OK, 0 rows affected, 1 warning (0.00 sec)

mysql> select concat(c1, '!'), concat(c5, '!') from t;
+-----------------+-----------------+
| concat(c1, '!') | concat(c5, '!') |
+-----------------+-----------------+
| a!              | a    !          |
+-----------------+-----------------+

mysql> SET sql_mode = default;
mysql> select c5 from t where c5='a';
+------+
| c2   |
+------+
| a    |
+------+

mysql> select c5 from t where c5 like 'a    ';
Empty set (0.00 sec)
DROP TABLE IF EXISTS t;
CREATE TABLE t (c VARCHAR(16384));
SQL Error [1074] [42000]: Column length too big for column 'c' (max = 16383); use BLOB or TEXT instead
1.4.2 BINARY与VARBINARY
DROP TABLE IF EXISTS t;
CREATE TABLE t (c BINARY(3));
INSERT INTO t VALUES ('a');

mysql> SELECT * FROM t where c='a';
Empty set (0.00 sec)

mysql> SELECT * FROM t where c='a\0\0';
+------------+
| c          |
+------------+
| 0x610000   |
+------------+
1.4.3 TEXT与BLOB
TINYTEXT,最大长度为255个字节,类似于VARCHAR(255)。每个TINYTEXT值需要1字节额外的存储表示长度;
TEXT(SAMLLTEXT),最大长度为64KB,类似于VARCHAR(65535)。每个TEXT值需要2字节额外的存储表示长度;
MEDIUMTEXT,最大长度为16MB。每个MEDIUMTEXT值需要3字节额外的存储表示长度;
LONGTEXT,最大长度为4GB。每个LONGTEXT值需要4字节额外的存储表示长度。
TINYBLOB,最大长度为255个字节,类似于VARBINARY(255)。每个TINYBLOB值需要1字节额外的存储表示长度;
BLOB(SMALLBLOB),最大长度为64KB,类似于VARBINARY(65535)。每个BLOB值需要2字节额外的存储表示长度;
MEDIUMBLOB,最大长度为16MB。每个MEDIUMBLOB值需要3字节额外的存储表示长度;
LONGBLOB,最大长度为4GB。每个LONGBLOB值需要4字节额外的存储表示长度。
1.4.4 ENUM类型
在字段的取值有限时提供紧凑的数据存储,枚举在内部使用整数表示,需要1字节或2字节存储;
查询结果的可读性,内部整数在查询结果中显示为相应的字符串。
CREATE TABLE shirts (
name VARCHAR(40),
size ENUM('x-small', 'small', 'medium', 'large', 'x-large')
);
INSERT INTO shirts (name, size) VALUES ('dress shirt','large'), ('t-shirt','medium'), ('polo shirt','small');

SELECT name, size FROM shirts WHERE size = 'medium';
+---------+--------+
| name    | size   |
+---------+--------+
| t-shirt | medium |
+---------+--------+
SELECT name, size, size+0 FROM shirts
ORDER BY size;
+----------+--------+--------+
name       | size   | size+0 |
+----------+--------+--------+
polo shirt | small  | 2      |
t-shirt    | medium | 3      |
dress shirt| large  | 4      |
+----------+--------+--------+
1.4.5 SET类型
DROP TABLE IF EXISTS t;
CREATE TABLE t (c SET('read','write'));
INSERT INTO t VALUES (''),('read'),('write'),('read,write');

mysql> SELECT c+0 FROM t;
+------+
| c+0  |
+------+
|    0 |
|    1 |
|    2 |
|    3 |
+------+
1.5 日期时间类型
1.5.1 日期类型
DROP TABLE IF EXISTS t;
CREATE TABLE t(birth_date date);
INSERT INTO t VALUES ('2023-04-01');

mysql> SELECT * FROM t;
+------------+
| birth_date |
+------------+
| 2023-04-01 |
+------------+
00-69之间的年份转换为2000-2069;
70-99之间的年份转换为1970-1999。
INSERT INTO t VALUES ('01-10-31'), ('81-10-31');

mysql> SELECT * FROM t;
+------------+
| birth_date |
+------------+
| 2023-04-01 |
| 2001-10-31 |
| 1981-10-31 |
+------------+
3 rows in set (0.00 sec)
1.5.2 时间类型
1.5.3 时间戳类型
DROP TABLE IF EXISTS t;
CREATE TABLE t (dt DATETIME, ts TIMESTAMP);

SET time_zone = '+00:00';
INSERT INTO t VALUES (now(), now());

mysql> SELECT * FROM t;
+---------------------+---------------------+
| dt                  | ts                  |
+---------------------+---------------------+
| 2023-04-15 14:09:57 | 2023-04-15 14:09:57 |
+---------------------+---------------------+
1 row in set (0.00 sec)
mysql> SET time_zone = '+08:00';
Query OK, 0 rows affected (0.00 sec)

mysql> SELECT * FROM t;
+---------------------+---------------------+
| dt                  | ts                  |
+---------------------+---------------------+
| 2023-04-15 14:09:57 | 2023-04-15 22:09:57 |
+---------------------+---------------------+
1 row in set (0.00 sec)
DROP TABLE IF EXISTS t;
CREATE TABLE t (
  id int,
  dt DATETIME DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
  ts TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP
);
INSERT INTO t(id) VALUES (1);

mysql> SELECT * FROM t;
+------+---------------------+---------------------+
| id   | dt                  | ts                  |
+------+---------------------+---------------------+
|    1 | 2020-09-10 14:33:25 | 2020-09-10 22:33:25 |
+------+---------------------+---------------------+
1 row in set (0.00 sec)
1.6 JSON类型
CREATE TABLE employee_json(
  emp_id    INTEGER NOT NULL PRIMARY KEY,
  emp_info  JSON NOT NULL
);

INSERT INTO employee_json
VALUES (1, '{"emp_name": "刘备", "sex": "男", "dept_id": 1, "manager": null, "hire_date": "2000-01-01", "job_id": 1, "income": [{"salary":30000}, {"bonus": 10000}], "email": "liubei@shuguo.com"}');

SELECT emp_id,
       emp_info->>'$.emp_name' emp_name,
       emp_info->>'$.income[0].salary' salary
FROM employee_json
WHERE emp_info->>'$.emp_name' = '刘备';
emp_id|emp_name|salary|
------+--------+------+
1|刘备     |30000 |
构造JSON对象的JSON_OBJECT、JSON_ARRAY;
查询指定元素的->(JSON_EXTRACT)、->>(JSON_UNQUOTE + JSON_EXTRACT);
将JSON数据转换为SQL数据的JSON_TABLE;
更新JSON数据的JSON_SET、JSON_INSERT、JSON_REPLACE、JSON_REMOVE
格式验证的JSON_VALID函数。
ALTER TABLE employee_json
ADD COLUMN dept_id INT GENERATED ALWAYS AS (emp_info->"$.dept_id");

CREATE INDEX idx_employee_dept_id ON employee_json(dept_id);

-- 查看执行计划
EXPLAIN
SELECT *
FROM employee_json
WHERE dept_id = 1;
Name         |Value               |
-------------+--------------------+
id           |1                   |
select_type  |SIMPLE              |
table        |employee_json       |
partitions   |                    |
type         |ref                 |
possible_keys|idx_employee_dept_id|
key          |idx_employee_dept_id|
key_len      |5                   |
ref          |const               |
rows         |1                   |
filtered     |100.0               |
Extra        |                    |
1.7 选择主键类型
1.8 常见问题
混合使用了不同的存储引擎,例如一些表使用InnoDB,一些表使用MyISAM。建议统一使用InnoDB存储引擎。
使用VARCHAR存储IP地址。IP地址应该使用32位无符号整数,节省空间。可以利用INET_ATON和INET_NTOA函数进行转换。
使用VARCHAR存储日期和时间。这种方式需要占用更多存储,而且无法支持算术运算,例如返回两个日期之间的时间间隔。
为了避免扩展问题使用TEXT或者超长的VARCHAR。
原文作者:SQL编程思想;如有侵权,请联系管理员删除。

