实验条件:

<!-- 正文结束 -->
CentOS 5.9,hadoop-1.2.1.tar.gz
查询已装jdk:
#rpm -qa | grep jdk
#rpm -qa | grep gcj
根据上面查出结果,删除已装jdk:
#rpm -e --nodeps jdk-xxx gcj-xxx
安装jdk:
#rpm -ivh jdk-7u45-linux-x64.rpm
设置环境变量:
#vim /etc/profile
export JAVA_HOME=/usr/java/jdk1.7.0_45
export JAVA_BIN=/usr/java/jdk1.7.0_45/bin
export
CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
export PATH=$PATH:$JAVA_HOME/bin:$ANT_HOME/bin
export JAVA_HOME JAVA_BIN PATH CLASSPATH
使之生效:
#source /etc/profile
创建hadoop用户:
#groupadd hadoop
#useradd -g hadoop hadoop
本机的主机名是linux1.testlinux.com,需要添加好主机名在/etc/hosts:

----从此开始使用hadoop用户----
(本次安装的是伪分布式模式)
ssh无密码登录:
$ssh-keygen -t rsa -f ~/.ssh/id_rsa
产生公钥文件~/.ssh/id_rsa.pub
将公钥文件复制到需要连接成集群的机器上去,命名为authorized_keys:
$scp id_rsa.pub ~/.ssh/authorized_keys
解压hadoop文件:
$tar -zxvf hadoop-1.2.1.tar.gz
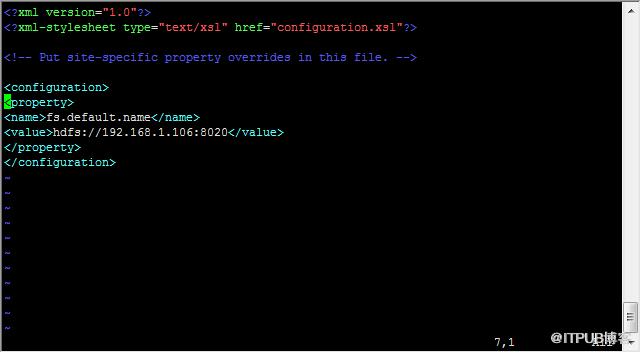
去/home/hadoop/hadoop-1.2.1/conf,修改配置文件core-site.xml:
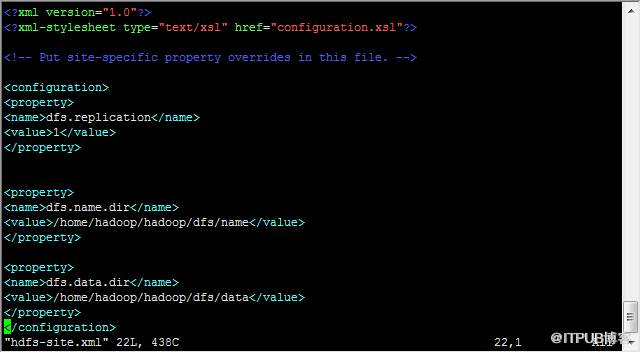
去/home/hadoop/hadoop-1.2.1/conf,修改配置文件hdfs-site.xml:
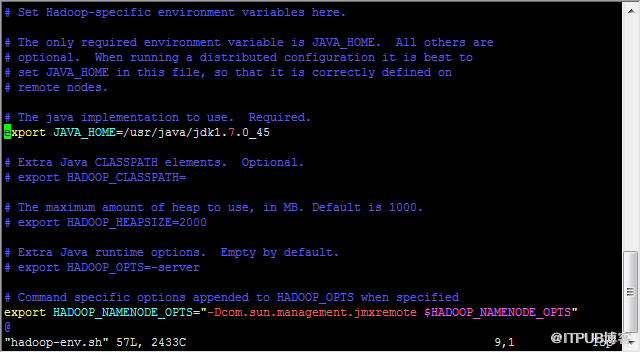
去/home/hadoop/hadoop-1.2.1/conf,配置文件hadoop-env.sh,修改JAVA_HOME:
Namenode格式化,必须做:
$cd /home/hadoop/hadoop-1.2.1/bin
$./hadoop namenode -format
启动hdfs:
$./start-dfs.sh
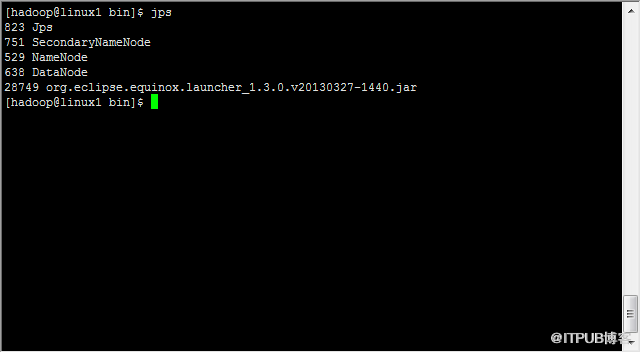
查看启动情况(jps可以查看运行中的java进程):
$jps
可以看到Namenode和Datanode都启动了。
关闭hdfs:
$./stop-all.sh
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/23735237/viewspace-1119552/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
没有了~
下一篇:
没有了~

请登录后发表评论
登录
全部评论
