https://arxiv.org/abs/1602.07360
MobileNet
2016.04
CVPR-2017
Google
https://arxiv.org/abs/1704.04861
ShuffleNet
2016.06
N/A
Face++
https://arxiv.org/abs/1707.01083
Xception
2016.10
CVPR-2017
Google
https://arxiv.org/abs/1610.02357
其中ShuffleNet论文中引用了SqueezeNet、Xception、MobileNet;Xception 论文中引用了MobileNet
http://blog.csdn.net/u011995719/article/details/78908755)
命名
从名字SqueezeNet就知道,本文的新意是squeeze,squeeze在SqueezeNet中表示一个squeeze层,该层采用1*1卷积核对上一层feature map进行卷积,主要目的是减少feature map的维数(维数即通道数,就是一个立方体的feature map,切成一片一片的,一共有几片)。
创新点
1. 采用不同于传统的卷积方式,提出fire module;fire module包含两部分:squeeze层+expand层
创新点与inception系列的思想非常接近!首先squeeze层,就是1*1卷积,其卷积核数要少于上一层feature map数,这个操作从inception系列开始就有了,并美其名曰压缩,个人觉得“压缩”更为妥当。
Expand层分别用1*1 和3*3 卷积,然后concat,这个操作再inception系列里面也有。
—————————————-分割线———————————
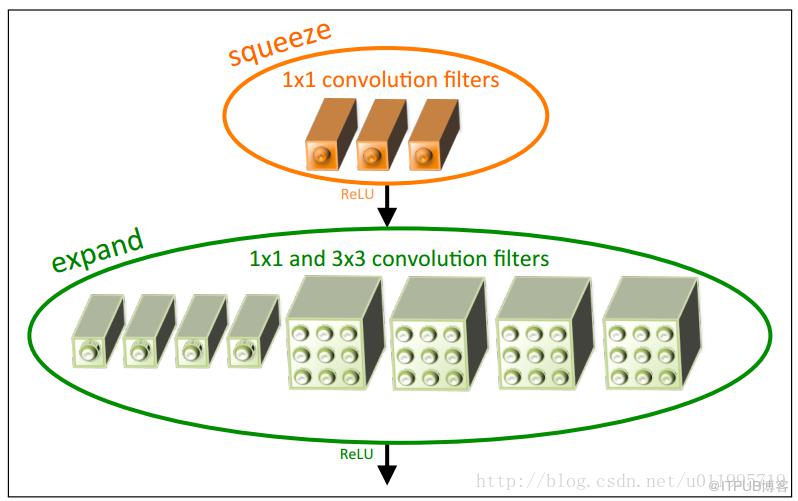
SqueezeNet的核心在于Fire module,Fire module 由两层构成,分别是squeeze层+expand层,如下图1所示,squeeze层是一个1*1卷积核的卷积层,expand层是1*1 和3*3卷积核的卷积层,expand层中,把1*1 和3*3 得到的feature map 进行concat。
具体操作情况如下图所示:
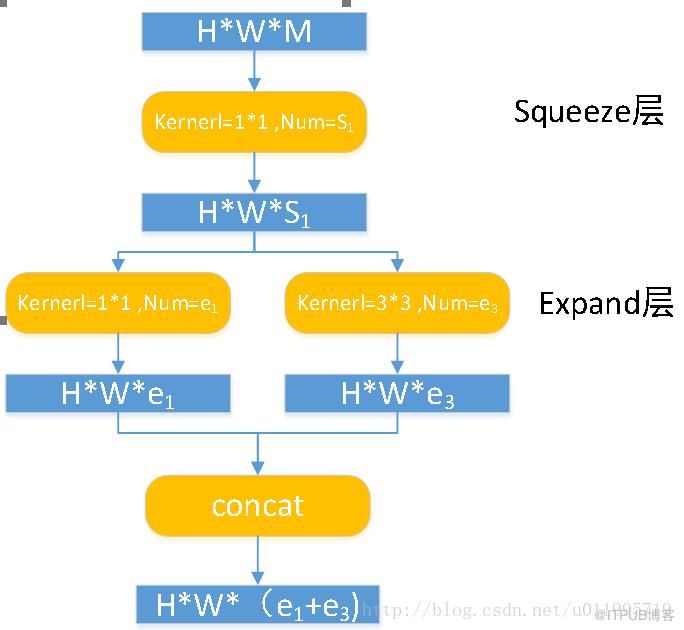
Fire module输入的feature map为H*W*M的,输出的feature map为H*M*(e1+e3),可以看到feature map的分辨率是不变的,变的仅是维数,也就是通道数,这一点和VGG的思想一致。
首先,H*W*M的feature map经过Squeeze层,得到S1个feature map,这里的S1均是小于M的,以达到“压缩”的目的,详细思想可参考Google的Inception系列。
其次,H*W*S1的特征图输入到Expand层,分别经过1*1卷积层和3*3卷积层进行卷积,再将结果进行concat,得到Fire module的输出,为 H*M*(e1+e3)的feature map。
fire模块有三个可调参数:S1,e1,e3,分别代表卷积核的个数,同时也表示对应输出feature map的维数,在本文提出的SqueezeNet结构中,e1=e3=4s1 。
讲完SqueezeNet的核心——Fire module,看看SqueezeNet的网络结构,如下图所示:
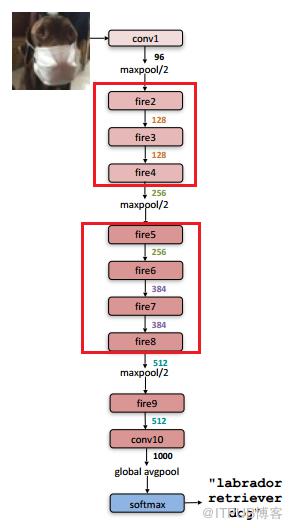
网络结构设计思想,同样与VGG的类似,堆叠的使用卷积操作,只不过这里堆叠的使用本文提出的Fire module(图中用红框部分)
看看Squezeenet的参数数量以及性能: 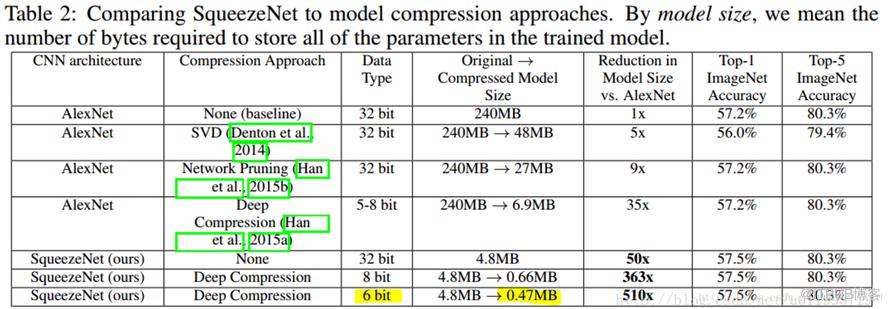
在这里可以看到,论文题目中提到的小于0.5M,是采用了Deep Compression进行模型压缩之后的结果!!
看了上图再回头看一看论文题目:
SqueezeNet :AlexNet-level accuracy with 50x fewer parameters and 标!题!党! SqueezeNet
SqueezeNet小结:
1 Fire module 与GoogLeNet思想类似,采用1*1卷积对feature map的维数进行“压缩”,从而达到减少权值参数的目的;
2 采用与VGG类似的思想——堆叠的使用卷积,这里堆叠的使用Fire module
SqueezeNet与GoogLeNet和VGG的关系很大!
http://blog.csdn.net/u011995719/article/details/78850275)
命名
MobileNet的命名是从它的应用场景考虑的,顾名思义就是能够在移动端使用的网络模型。
创新点
1. 采用名为depth-wise separable convolution 的卷积方式代替传统卷积方式,以达到减少网络权值参数的目的。
通过采用depth-wise convolution的卷积方式,达到:1.减少参数数量 2.提升运算速度。(这两点是要区别开的,参数少的不一定运算速度快!)
depth-wise convolution不是MobileNet提出来的,也是借鉴,文中给的参考文献是 2014年的博士论文——《L. Sifre. Rigid-motion scattering for image classification. hD thesis, Ph. D. thesis, 2014》
depth-wise convolution 和 group convolution其实是一样的,都是一个卷积核负责一部分feature map,每个feature map只被一个卷积核卷积。
———————————–分割线————————————-
MobileNets精华在于卷积方式——depth-wise separable convolution;采用depth-wise separable convolution,会涉及两个超参:Width Multiplier和Resolution Multiplier这两个超参只是方便于设置要网络要设计为多小,方便于量化模型大小。
depth-wise convolution是将标准卷积分成两步:第一步 Depthwise convolution,即逐通道的卷积,一个卷积核负责一个通道,一个通道只被一个卷积核“滤波”;
第二步,Pointwise convolution,将depthwise convolution得到的feature map再“串”起来 ,注意这个“串”是很重要的。“串”作何解?为什么还需要 pointwise convolution?作者说:However it only filters input channels, it does not combine them to create new features. Soan additional layer that computes a linear combination ofthe output of depthwise convolution via 1 × 1 convolutionis needed in order to generate these new features。
首先要承认一点:输出的每一个feature map要包含输入层所有feature map的信息。仅采用depthwise-convolution,是没办法做到这点,因此需要pointwise convolution的辅助。
“输出的每一个feature map要包含输入层所有feature map的信息” 这个是所有采用depth-wise convolution操作的网络都要去解决的问题,ShuffleNet中的命名就和这个有关!详细请看2.3
Standard convolution、depthwise convolution和pointwiseconvolution示意图如下: 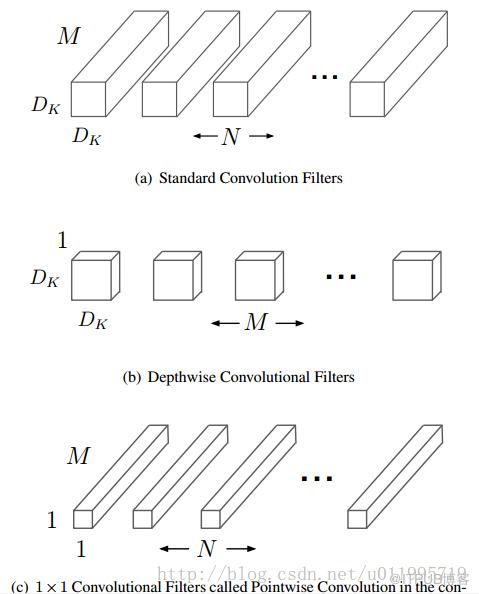
其中输入的feature map有M个,输出的feature map有N个。
Standard convolution呢,是采用N个大小为DK*DK的卷积核进行操作(注意卷积核大小是DK*DK, DK*DK*M是具体运算时候的大小!)
而depthwise convolution + pointwise convolution需要的卷积核呢?
Depthwise convolution :一个卷积核负责一个通道,一个通道只被一个卷积核卷积;则这里有M个DK*DK的卷积核;
Pointwise convolution:为了达到输出N个feature map的操作,所以采用N个1*1的卷积核进行卷积,这里的卷积方式和传统的卷积方式是一样的,只不过采用了1*1的卷积核;其目的就是让新的每一个feature map包含有上一层各个feature map的信息!在此理解为将depthwise convolution的输出进行“串”起来。
————————————–分割线———————————-
下面举例讲解 Standard convolution、depthwise convolution和pointwise convolution 。
假设输入的feature map 是两个5*5的,即5*5*2;输出feature map数量为3,大小是3*3(因为这里采用3*3卷积核)即3*3*3。
标准卷积,是将一个卷积核(3*3)复制M份(M=2), 是让二维的卷积核(面包片)拓展到与输入feature map一样的面包块形状。例如,我们设置3个 3*3的卷积核,如下图Kernel所示,但是在实际计算当中,卷积核并不是3*3*3这么多,而是3*3*2*3 ( w*h*c_in*c_out) 。也就是上面所说的把二维的卷积核拓展到与feature map一样的面包块形状,如下图的K1 扩展成 K11,K12 。
(注:不是复制M份,因为每个二维卷积核的参数是不一样的,因此不是复制!感谢DSQ_17这位朋友指出错误。)
2018年3月15日补充:实际上,卷积核实际的尺寸应该是 w*h*c_in*c_out。往往,我们忽略掉c_in这个数,在设置卷积核数量时,也不会涉及到这个参数,但是在计算过程中是不能忽略的。
其中,w*h就是通常我们所说的卷积核大小,例如3*3,5*5,7*7等;c_out是平时我们讲的卷积核个数,例如该卷积层设置了64个卷积核,则c_out = 64;而c_in则是等于上一层的feature map的数量。
Standard过程如下图,X表示卷积,+表示对应像素点相加,可以看到对于O1来说,其与输入的每一个feature map都“发生关系”,包含输入的各个feature map的信息。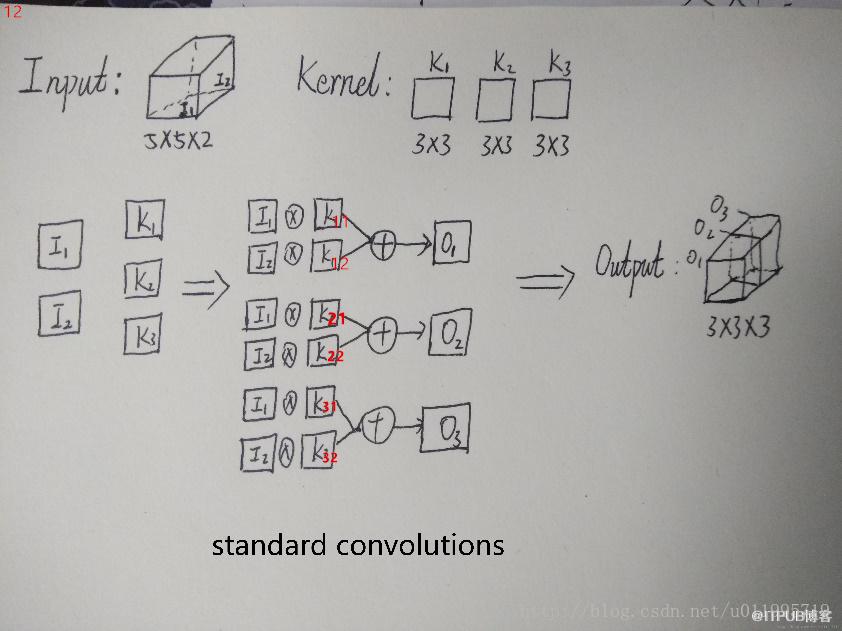
Depth-wise 过程如下图,而Depthwise并没有,可以看到depthwise convolution 得出的两个feature map——fd1 和fd2分别只与i1和i2 “发生关系” ,这就导致违背上面所承认的观点“输出的每一个feature map要包含输入层所有feature map的信息”,因而要引入pointwise convolution
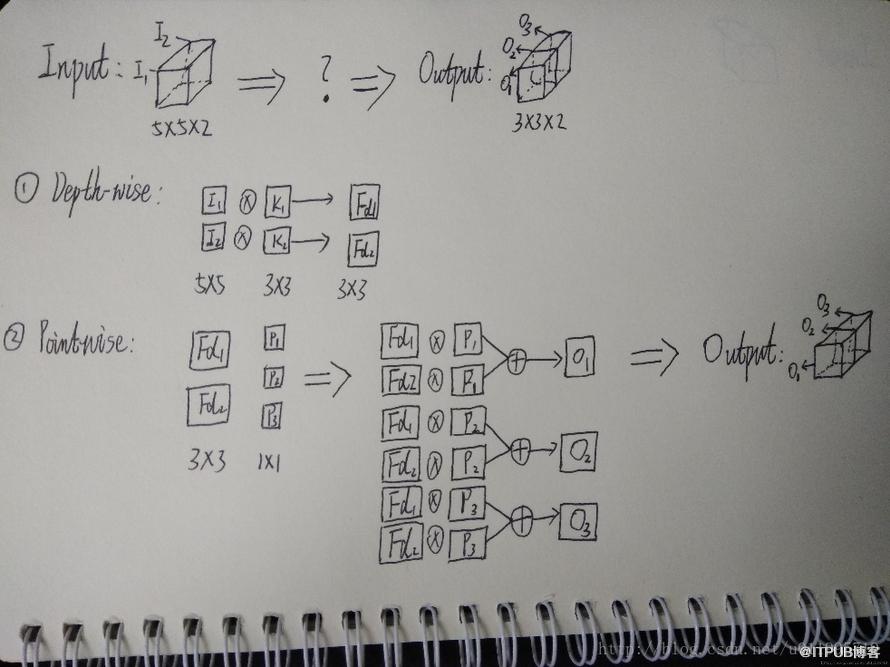
那么计算量减少了多少呢?通过如下公式计算:
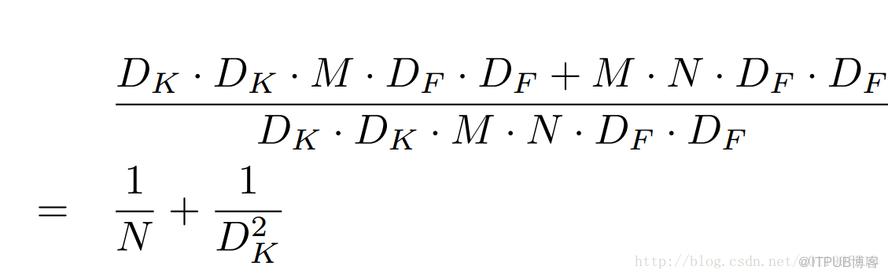
其中DK为标准卷积核大小,M是输入feature map通道数,DF为输入feature map大小,N是输出feature map大小。本例中,DK=3,M=2,DF=5,N=3 , 参数的减少量主要就与卷积核大小DK有关。在本文MobileNet的卷积核采用DK=3,则大约减少了8~9倍计算量。
看看MobileNet的网络结构,MobileNet共28层,可以发现这里下采样的方式没有采用池化层,而是利用depth-wise convolution的时候将步长设置为2,达到下采样的目的。
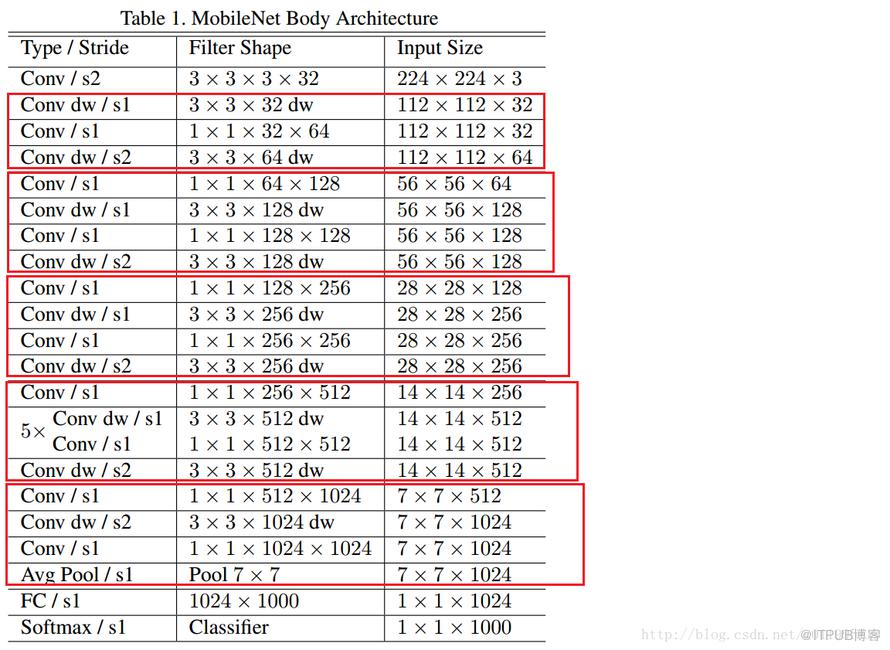
1.0 MobileNet-224 与GoogLeNet及VGG-16的对比:
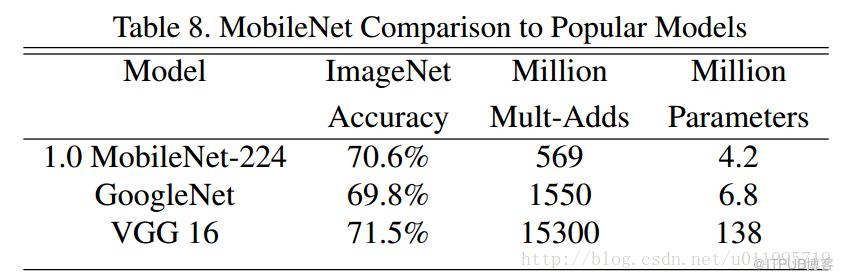
可以发现,相较于GoogLeNet,虽然参数差不多,都是一个量级的,但是在运算量上却小于GoogLeNet一个量级,这就得益于 depth-wise convolution !
MobileNet小结:
1. 核心思想是采用depth-wise convolution操作,在相同的权值参数数量的情况下,相较于standard convolution操作,可以减少数倍的计算量,从而达到提升网络运算速度的目的。
depth-wise convolution的思想非首创,借鉴于 2014年一篇博士论文:《L. Sifre. Rigid-motion scattering for image classification. hD thesis, Ph. D. thesis, 2014》
采用depth-wise convolution 会有一个问题,就是导致“信息流通不畅”,即输出的feature map仅包含输入的feature map的一部分,在这里,MobileNet采用了point-wise convolution解决这个问题。在后来,ShuffleNet采用同样的思想对网络进行改进,只不过把point-wise convolution换成了 channel shuffle,然后给网络美其名曰 ShuffleNet~ 欲知后事如何,请看 2.3 ShuffleNet
https://github.com/vdumoulin/conv_arithmetic),挑一个或者几个,结合起来,只要参数量少,实验效果好,就可以发(Shui)论文。
3.接着第2,如果设计出来一个新的卷积方式,如果也存在一些“副作用”,再想一个方法解决这个副作用,再美其名曰XX-Net。就是自己“挖”个坑,自己再填上去。
以上纯属读后感,写得比较“随意”,如果有什么地方描述有误,请大家指出来,欢迎大家前来讨论~
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/2298/viewspace-2801605/ ,如需转载,请注明出处,否则将追究法律责任。

