前期准备
TensorFlow 相关 API 可以到在实验 TensorFlow - 相关 API 中学习。
模型构建
示例代码:
现在您可以在 /home/ubuntu 目录下创建源文件 linear_regression_model.py,内容可参考:
示例代码:/home/ubuntu/linear_regression_model.py
linear_regression_model.py
#!/usr/bin/python
import numpy as np

class linearRegressionModel:
    def __init__(self,x_dimen):
        self.x_dimen = x_dimen
        self._index_in_epoch = 0
        self.constructModel()#呵呵
        self.sess = tf.Session()#这个
        self.sess.run(tf.global_variables_initializer())#和这个

    #权重初始化
    def weight_variable(self,shape):
        initial = tf.truncated_normal(shape,stddev = 0.1)#难道mean默认了
        return tf.Variable(initial)#把初始化好的值装到变量里面

    #偏置项初始化
    def bias_variable(self,shape):
        initial = tf.constant(0.1,shape=shape)#这丫的shape是用shape=传递的
        return tf.Variable(initial)
    #每次选取100个样本,如果选完,重新打乱
    def next_batch(self,batch_size):#目前定义的都是函数,还没有开始使用
        start = self._index_in_epoch
        self._index_in_epoch +=batch_size#i +=1 => i = i + 1,假设i=1,那就是2了
        if self._index_in_epoch > self._num_datas:#判断是否已经训练完了,即训练的次数大于训练集总的数据量
            perm = np.arange(self._num_datas)#self._num_datas指训练集的样本数量
            np.random.shuffle(perm)#打乱arange的值,接下来就是类似通过index/id这些标记来获取训练样本,那么获取的训练样本也是被打乱的了
            self._datas = self._datas[perm]#所有训练集输入数据被重置
            self._labels = self._labels[perm]#所有训练集输出数据被重置
            start = 0
            self._index_in_epoch = batch_size#batch_size是固定值吧,每次把它搞成固定值,不应该呀
            assert batch_size
训练模型并和 sklearn 库线性回归模型对比
示例代码:
现在您可以在 /home/ubuntu 目录下创建源文件 run.py,内容可参考:
示例代码:/home/ubuntu/run.py
run.py
#!/usr/bin/python
# -*- coding: utf-8 -*

from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score
from sklearn.datasets import make_regression
from sklearn.linear_model import LinearRegression
from linear_regression_model import linearRegressionModel as lrm

if __name__ == '__main__':
    x, y = make_regression(7000)
    x_train,x_test,y_train, y_test = train_test_split(x, y, test_size=0.5)
    y_lrm_train = y_train.reshape(-1, 1)
    y_lrm_test = y_test.reshape(-1, 1)

    linear = lrm(x.shape[1])
    linear.train(x_train, y_lrm_train,x_test,y_lrm_test)
    y_predict = linear.predict(x_test)
    print("Tensorflow R2: ", r2_score(y_predict.ravel(), y_lrm_test.ravel()))

    lr = LinearRegression()
    y_predict = lr.fit(x_train, y_train).predict(x_test)
    print("Sklearn R2: ", r2_score(y_predict, y_test)) #采用r2_score评分函数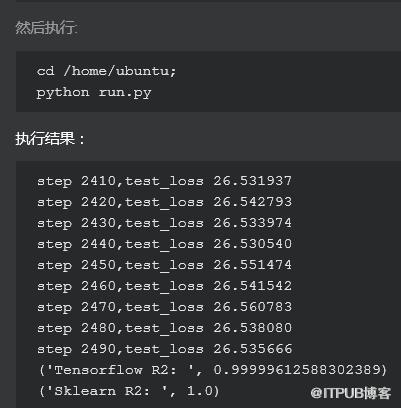
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/2281/viewspace-2799288/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
