JobTracker之辅助线程和对象映射模型分析(源码分析第五篇)
一、概述
二、JobTracker中各种线程的作用
JobTacker作为MapReduce框架的控制中心,其稳定性以及容错性的重要性就不言而喻了。JobTracker内部会通过offerServer方法去启动若干个重要的后台服务线程来检测和处理JobTracker在工作可能发生的各种异常情况以及产生的历史数据、残留数据。看看JobTracker的源码中这些线程都有哪些:
ExpireTrackers expireTrackers = new ExpireTrackers();//expireTrackersThread的线程体 Thread expireTrackersThread = null;//用于检测和清理死掉的TaskTracker RetireJobs retireJobs = new RetireJobs();//retireJobsThread的线程体 Thread retireJobsThread = null;//清理长时间保存在内存中已经完成的作业信息线程 final int retiredJobsCacheSize; ExpireLaunchingTasks expireLaunchingTasks = new ExpireLaunchingTasks();//expireLaunchingTaskThread的线程体 Thread expireLaunchingTaskThrea d = //检测已经被分配task的但是一直没有汇报的TaskTracker new Thread(expireLaunchingTasks,"expireLaunchingTasks"); CompletedJobStatusStore completedJobStatusStore = null;//completedJobsStoreThread 的线程体 Thread completedJobsStoreThread = null;//处理已经运行完毕的作业信息,将其保存在HDFS中
下面我们一个一个详细地来探讨这些线程。
(1)expireTrackersThread
;
class ExpireTrackers implements Runnable {
    public ExpireTrackers() {
    }

    public void run() {
      while (true) {
        try {
          //
          // Thread runs periodically to check whether trackers should be expired.
          // The sleep interval must be no more than half the maximum expiry time
          // for a task tracker.
          //
          Thread.sleep(TASKTRACKER_EXPIRY_INTERVAL / 3);//每隔这么多时间检测一次
          //
          // Loop through all expired items in the queue
          //
          // Need to lock the JobTracker here since we are
          // manipulating it"s data-structures via
          // ExpireTrackers.run -> JobTracker.lostTaskTracker ->
          // JobInProgress.failedTask -> JobTracker.markCompleteTaskAttempt
          // Also need to lock JobTracker before locking "taskTracker" &
          // "trackerExpiryQueue" to prevent deadlock:
          // @see {@link JobTracker.processHeartbeat(TaskTrackerStatus, boolean, long)}
          synchronized (JobTracker.this) {
            synchronized (taskTrackers) {
              synchronized (trackerExpiryQueue) {
                long now = clock.getTime();
                TaskTrackerStatus leastRecent = null;
                while ((trackerExpiryQueue.size() > 0) &&
                       (leastRecent = trackerExpiryQueue.first()) != null &&
     //取出队列中的第一个TaskTracker状态对象,即时最近汇报心跳的TaskTracker,看是否超过最大间隔时间
                       ((now - leastRecent.getLastSeen()) > TASKTRACKER_EXPIRY_INTERVAL)) {
                  // Remove profile from head of queue
       //将超过最大时间间隔且是最近汇报心跳的TaskTracker的状态信息从队列中移除
                  trackerExpiryQueue.remove(leastRecent);
                  String trackerName = leastRecent.getTrackerName();

                  // Figure out if last-seen time should be updated, or if tracker is dead
                 //获得最近一次汇报心跳的TaskTracker对象
                  TaskTracker current = getTaskTracker(trackerName);
                  TaskTrackerStatus newProfile =
                    (current == null ) ? null : current.getStatus();
                  // Items might leave the taskTracker set through other means; the
                  // status stored in "taskTrackers" might be null, which means the
                  // tracker has already been destroyed.
                  if (newProfile != null) {
              //判断最近一次汇报心跳信息的TaskTracker对象是否已经过期
                    if ((now - newProfile.getLastSeen()) > TASKTRACKER_EXPIRY_INTERVAL) {
  //TaskTracker已经超过最大时间间隔,将其destroy掉。如果该TaskTracker
  //在“黑名单”或者“灰名单”中,将其移除,最后将该TaskTracker的状态变为KILLED_UNCLEAN
                      removeTracker(current);
                      // remove the mapping from the hosts list
                      String hostname = newProfile.getHost();
                      hostnameToTaskTracker.get(hostname).remove(trackerName);
                    }
    //最近一次汇报心跳信息的TaskTracker没有过期,更新其在
    //trackerExpiryQueue队列中的信息
         else {
                      // Update time by inserting latest profile
                      trackerExpiryQueue.add(newProfile);
                    }
                  }
                }
              }
            }
          }
        } catch (InterruptedException iex) {
          break;
        } catch (Exception t) {
          LOG.error("Tracker Expiry Thread got exception: " +
                    StringUtils.stringifyException(t));
        }
      }
    }

  }
(2)retireJobsThread
先看线程体源码和我读源码时的注释的一些理解:
  public void run() {
    while (true) {
      try {
        Thread.sleep(RETIRE_JOB_CHECK_INTERVAL);//每隔RETIRE_JOB_CHECK_INTERVAL(1min)进行一次检测
        List retiredJobs = new ArrayList();
        long now = clock.getTime();
        long retireBefore = now - RETIRE_JOB_INTERVAL;//过期时间阀值
        synchronized (jobs) {
          for(JobInProgress job: jobs.values()) {
            if (minConditionToRetire(job, now) &&//判断作业状态信息,不能为RUNNING和PREP状态
                (job.getFinishTime()  < retireBefore)) {//判断时间差,看判断是否过期(判断作业是否过期的第一条件)
              retiredJobs.add(job);//将已经过期的JIP放到指定的List中以便下面处理
            }
          }
        }
        synchronized (userToJobsMap) {//userToJobsMap对象代表用户信息和JIP的映射
          Iterator>>
              userToJobsMapIt = userToJobsMap.entrySet().iterator();
          while (userToJobsMapIt.hasNext()) {
            Map.Entry> entry =
              userToJobsMapIt.next();
            ArrayList userJobs = entry.getValue();
            Iterator it = userJobs.iterator();
            while (it.hasNext() && //将当前环境所有JIP遍历
                userJobs.size() > MAX_COMPLETE_USER_JOBS_IN_MEMORY) {//判断作业是否过期的第二条件,判断当前JIP在内存的数目是否超过100(默认)
              JobInProgress jobUser = it.next();
              if (retiredJobs.contains(jobUser)) {
                LOG.info("Removing from userToJobsMap: " +
                    jobUser.getJobID());
                it.remove();//将过期并且JIP容量超过100的JIP从userToJobsMap结构中移除
              } else if (minConditionToRetire(jobUser, now)) {//再次判断是否超时,这个比较特殊now值还是原来的值,意思就是包含前面程序流程花费时间在内的JIP超时了
                LOG.info("User limit exceeded. Marking job: " +
                    jobUser.getJobID() + " for retire.");
                retiredJobs.add(jobUser);//将超时的JIP放进List中
                it.remove();//将过期的JIP从userToJobsMap结构中移除
              }
            }
            if (userJobs.isEmpty()) {//userToJobsMap结构的同步维护
              userToJobsMapIt.remove();
            }
          }
        }
        if (!retiredJobs.isEmpty()) {//判断过期的JIP队列是否完全清空
          synchronized (JobTracker.this) {
            synchronized (jobs) {
              synchronized (taskScheduler) {
                for (JobInProgress job: retiredJobs) {
                  removeJobTasks(job);//将JIP管理下的所有Tasks清除
                  jobs.remove(job.getProfile().getJobID());//从内存中清除JIP
                  for (JobInProgressListener l : jobInProgressListeners) {
                    l.jobRemoved(job);//从监听器中清除JIP
                  }
                  String jobUser = job.getProfile().getUser();
                  LOG.info("Retired job with id: "" +
                           job.getProfile().getJobID() + "" of user "" +
                           jobUser + """);
                  // clean up job files from the local disk
                  JobHistory.JobInfo.cleanupJob(job.getProfile().getJobID());//将作业文件从本地disk中删除
                  addToCache(job);//将过期作业统一保存在过期队列中,当过期作业超过1000个(由mapred.job.tracker.retiredjobs.cache.size参数配置,默认1000)时,将会从内存中彻底删除
                }
              }
            }
          }
        }
      } catch (InterruptedException t) {
        break;
      } catch (Throwable t) {
        LOG.error("Error in retiring job:
" +
                  StringUtils.stringifyException(t));
      }
    }
  }
}
|
当作业满足下面条件1、2或者1、3时,作业就会被转移到过期队列中并且在JobTracker中删除一些对应的数据结构,如userToJobsMap。
|
(3)expireLaunchingTaskThrea
expireLaunchingTaskThrea
public void run() {
      while (true) {
        try {
          // Every 3 minutes check for any tasks that are overdue
          Thread.sleep(TASKTRACKER_EXPIRY_INTERVAL/3);//检测时间间隔默认10/3min
          long now = clock.getTime();
          if(LOG.isDebugEnabled()) {
            LOG.debug("Starting launching task sweep");
          }
          synchronized (JobTracker.this) {
            synchronized (launchingTasks) {
              Iterator> itr =
                launchingTasks.entrySet().iterator();
              while (itr.hasNext()) {
                Map.Entry pair = itr.next();
                TaskAttemptID taskId = pair.getKey();
                long age = now - (pair.getValue()).longValue();
                LOG.info(taskId + " is " + age + " ms debug.");
            //判断Task没有进行汇报的时间是否超过10 * 60 * 1000ms即10min
             if (age > TASKTRACKER_EXPIRY_INTERVAL) {
                  LOG.info("Launching task " + taskId + " timed out.");
                  TaskInProgress tip = null;
                  tip = taskidToTIPMap.get(taskId);//获得当前超时没有汇报的TIP
                  if (tip != null) {
                    JobInProgress job = tip.getJob();
                    String trackerName = getAssignedTracker(taskId);
                    TaskTrackerStatus trackerStatus = //获得当前超时没有汇报的TIP状态信息对象
                      getTaskTrackerStatus(trackerName);

                    // This might happen when the tasktracker has already
                    // expired and this thread tries to call failedtask
                    // again. expire tasktracker should have called failed
                    // task!
                  //使当前超时没有汇报的Task失败,将其状态置为“FAILED”
                    if (trackerStatus != null)
                      job.failedTask(tip, taskId, "Error launching task",
                                     tip.isMapTask()? TaskStatus.Phase.MAP:
                                     TaskStatus.Phase.STARTING,
                                     TaskStatus.State.FAILED,
                                     trackerName);
                  }
                  itr.remove();//JobTracer从数据结构中,将此过期的TaskTracker清除掉
                } else {
                  // the tasks are sorted by start time, so once we find
                  // one that we want to keep, we are done for this cycle.
                  break;
                }
              }
            }
          }
        } catch (InterruptedException ie) {
          // all done
          break;
        } catch (Exception e) {
          LOG.error("Expire Launching Task Thread got exception: " +
                    StringUtils.stringifyException(e));
        }
      }
    }
(4)completedJobsStoreThread
该线程的作用主要是将已经运行完成的作业运行信息保存到HDFS上,并提供一系列存取信息的方法。通过保存作业运行日志这种方式,用户可以查询任意时间点提交的作业并可以还原其运行信息。该线程可以解决下面问题:
|
看看completedJobsStoreThread
active =
     conf.getBoolean("mapred.job.tracker.persist.jobstatus.active", false);
   if (active) {
     retainTime =
       conf.getInt("mapred.job.tracker.persist.jobstatus.hours", 0) * HOUR;
     jobInfoDir =
       conf.get("mapred.job.tracker.persist.jobstatus.dir", JOB_INFO_STORE_DIR);
-
mapred.job.tracker.persist.jobstatus.active:其否启动该线程,默认不启动。
-
mapred.job.tracker.persist.jobstatus.hours:作业运行信息保存时间,默认0。
-
mapred.job.tracker.persist.jobstatus.dir:作业运行信息保存的路径,默认为/jobtracker/jobsInfo
注意:从配置参数中我们可以看出MapReduce框架中,该线程默认是不启动的,如果要启动的话需要对上面的几个参数进行相应的配置。
三、JobTracker的对象映射管理模型
在前面对JobTracker线程作业源码分析的时候我们会经常看到映射的Map对象,如userToJobsMap。这些映射对象保存了JobTracker在运行过程中的重要信息,TaskTracker、TIP等结构信息。MapReduce框架这样做是为了使用这种key/value方式的数据结构去迅速查找和定位各种对象。比如,为了能够快速通过作业id找到与其对象的JIP对象,JobTracker会将所有运行作业按照jobID与JIP的映射保存到Map结构jobs中。为了快速找到某个TaskTracker上的正在运行的Task,JobTracker将TrackerID和TaskID集合的映射关系保存在Map结构tarckerToTaskMap中。有了这些映射结构,JobTrcker的各种操作,比如监控、更新等,实际上就是修改这些数据结构的映射关系。源码如下:
// All the known jobs.  (jobid->JobInProgress)
  Map jobs =
    Collections.synchronizedMap(new TreeMap());
  // (user -> list of JobInProgress)
  TreeMap> userToJobsMap =
    new TreeMap>();
  // (trackerID --> list of jobs to cleanup)
  Map> trackerToJobsToCleanup =
    new HashMap>();
  // (trackerID --> list of tasks to cleanup)
  Map> trackerToTasksToCleanup =
    new HashMap>();
  // All the known TaskInProgress items, mapped to by taskids (taskid->TIP)
  Map taskidToTIPMap =
    new TreeMap();
  // This is used to keep track of all trackers running on one host. While
  // decommissioning the host, all the trackers on the host will be lost.
  Map> hostnameToTaskTracker =
    Collections.synchronizedMap(new TreeMap>());
  // (taskid --> trackerID)
  TreeMap taskidToTrackerMap = new TreeMap();
  // (trackerID->TreeSet of taskids running at that tracker)
  TreeMap> trackerToTaskMap =
    new TreeMap>();
  // (trackerID -> TreeSet of completed taskids running at that tracker)
  TreeMap> trackerToMarkedTasksMap =
    new TreeMap>();
  // (trackerID --> last sent HeartBeatResponse)
  Map trackerToHeartbeatResponseMap =
    new TreeMap();
  // (hostname --> Node (NetworkTopology))
  Map hostnameToNodeMap =
    Collections.synchronizedMap(new TreeMap());
四、总结
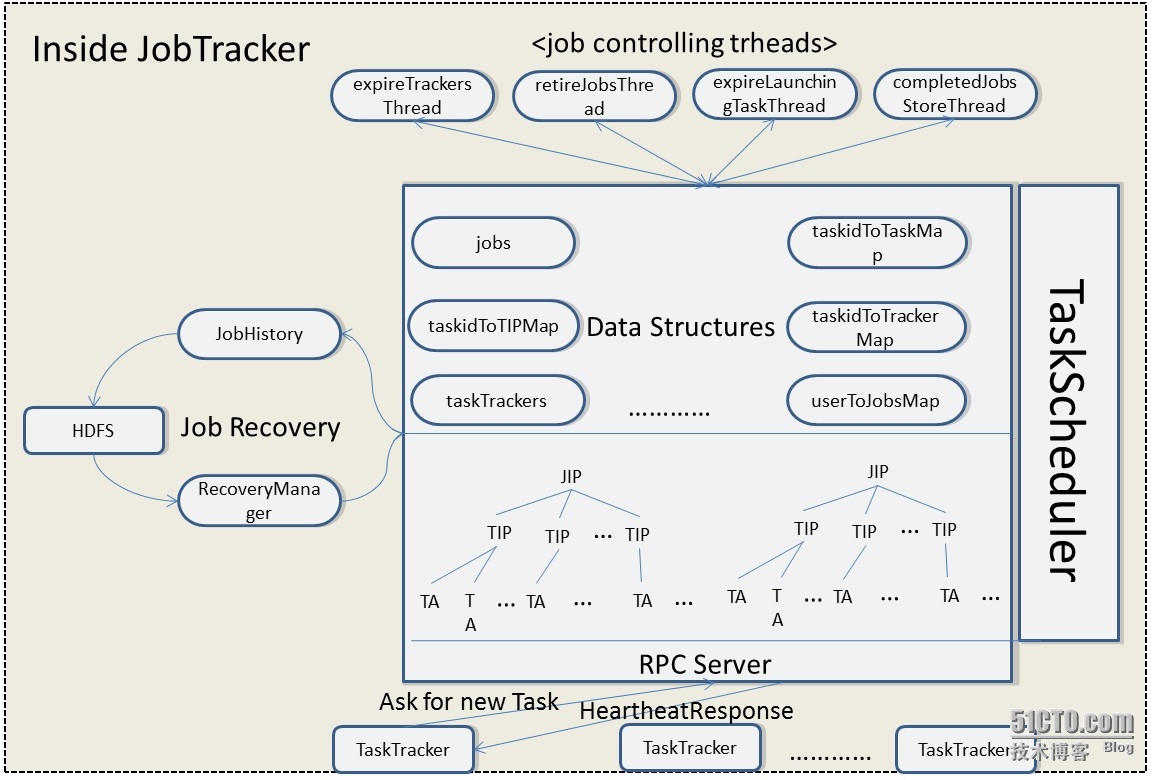
本文主要讲述了JobTracker中各种线程的作用以及他们具体的实现流程。另外,还介绍了JobTracker中对运行时各种对象的数据结构。到现在为止,对于JobTracker的部分实现机制已经有了一些认识,现在结合前几篇关于JobTracker机制研究的blog对其大体结构总结一下,引用参考资料[1]中的图,如下:
---------------------------------------hadoop源码分析系列------------------------------------------------------------------------------------------------------------
hadoop作业分片处理以及任务本地性分析(源码分析第一篇)
JobTracker之作业恢复与权限管理机制(源码分析第四篇)
JobTracker之辅助线程和对象映射模型分析(源码分析第五篇)
---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
参考文献:
[1]《Hadoop技术内幕:深入解析MapReduce架构设计与实现原理》
本文出自 “点点滴滴积少成多” 博客,谢绝转载!
看到一个分享足球新闻的网站,喜欢的去看看吧,或许对你有用
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/22719624/viewspace-1114403/ ,如需转载,请注明出处,否则将追究法律责任。

