这里的输入输出还没有设计掉底层类:
void setConf(Configuration
conf);
Configuration getConf();
<!-- 正文结束 -->
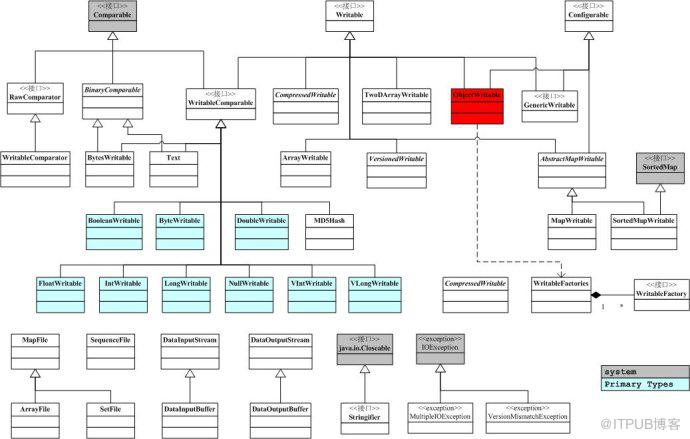
只是对mapreduce过程中输入输出使用的数据类型进行简单分析。
有三个重要的接口:writable、comparable、configurable
关系见下图:
writable:
两个方法:
void write(DataOutput out) throws IOException;
void readFields(DataInput in) throws IOException;
分别实现对数据的序列化和反序列化,相当于抽象数据类型的get和set方法,输入输出的方向不同:重点学习一下DataOutput、DataInput两个类型。
DataOutput、DataInput是java的输入输出流,定义在标准api中。DataOutput是输出流,将java基本数据类型(int,Boolean,char等)写入到一个输出流中。是输出流设备的抽象。DataInput为反序列化的输入流,逻辑相同。
comparable:
只有一个方法:public int compareTo(T o);与相同类型的对象进行比较,返回1、-1、0
一个比较典型的例子是IntWritable,这个类同时实现了writable、comparable两个接口。
configurable:
org.apache.hadoop.conf
public interface Configurable {
}
该接口一般被mapreduce程序所实现,只有getConf、setConf两个方法。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/22241854/viewspace-1120399/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
没有了~
下一篇:
没有了~

请登录后发表评论
登录
全部评论
