数据排序是对数据的初步处理,便于对整体数据的情况的大致了解,比如缺失值数量、最大值、最小值、异常值等等。
方法/步骤
-
spss的数据排序是对数据窗口中的数据按照某个或几个指定变量的变量值升序或降序重新排列。
以排序变量的多少分为“单值排序”、“多重排序”。多重排序中第一个指定的排序变量为主排序变量,依次为第二排序变量、第三排序变量等等,先以主排序变量为依据。
-
调出相应的窗口,其中选择“排序个案”,一行数据就是一个个案。第一个图片是原始的数据,即还没有排序的。
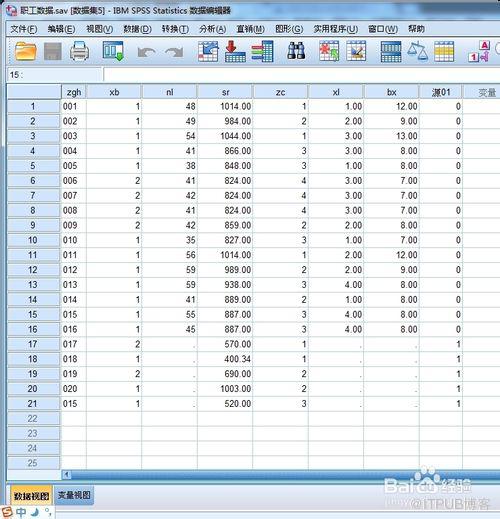
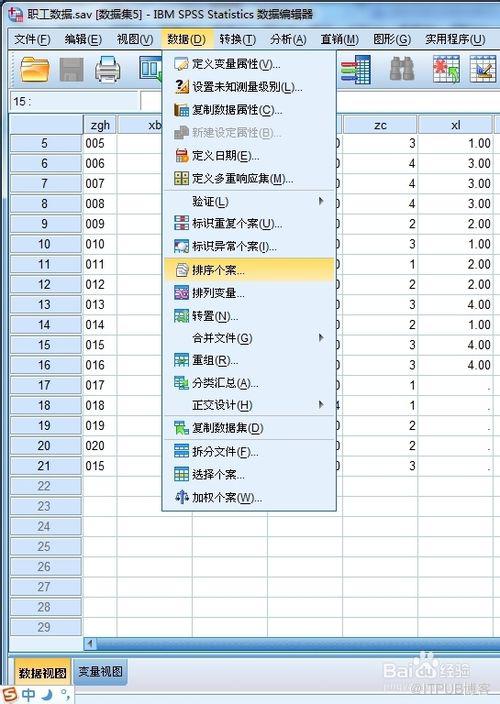
-
选择相关的变量作为“排序变量”,如果是“多重排序”,则选择多个变量即可,第一个变量就是“主排序变量”,第二个就是“第二排序变量”。这里演示的是“单值排序”,即选择一个变量作为“排序变量”,并按照“升序”排序的。
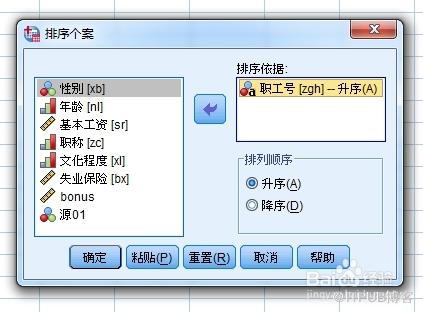
-
图片演示最后结果,第一个变量是“升序”的。
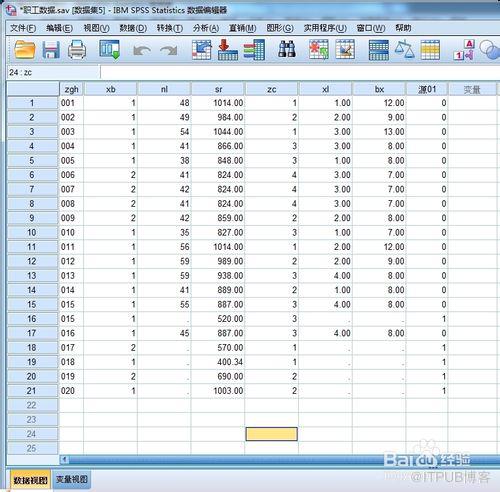 END
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/22028274/viewspace-1112487/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
没有了~
下一篇:
没有了~

请登录后发表评论
登录
全部评论
