基于Eclipse的Hadoop应用开发环境的配置
基于Eclipse的Hadoop应用开发环境的配置
配置好了Hadoop运行环境,下一步就要配置,开发环境了。实际上开发环境很好配置,网上很多的帖子,都指向了IBM提供的Hadoop开发工具,这个工具很好用。大家打开这个网址,很容易就能Step by step搞定,http://www.alphaworks.ibm.com/tech/mapreducetools。但是细心的读者不难发现,这个工具似乎是个绝版,到现在似乎还是停留在2007年3月23日呢,而且其支持的Eclipse也是3.3的,Hadoop更是0.17的。很多人在forum上还抱怨,安装上这个工具后,报出错误:Refresh DFS Children has encountered a problem:Refreshing DFS node failed: 1。呵呵,这个问题我也遇到了,我也很郁闷。我心里也在骂IBM这帮官僚如此不思进取。
这两天我在装载Hadoop Core的Examples测试,由于想要多了解些Hadoop,于是就打开了Hadoop的每个子目录,在打开/hadoop-0.19.0 /contrib/意外发现了eclipse-plugin,心里不禁窃喜,不知道是不是IBM的这个工具的升级版移到这里还是其他什么原因,工具不是在这里吗?只不过与以前不同,是个jar包!我把hadoop-0.19.0-eclipse-plugin.jar,拷贝到eclipse-SDK- 3.4-win32eclipseplugins下面,启动eclipse,居然真的安装成功了,真的是该工具的升级版,也没有了那个错误!真的是很意外!界面是这样滴,选择Window->Open Perspective,可见到一个窗口,里面有一个小象图标:Map/Reduce,点击它,会打开一个新的Perspective。然后点击 Window->Show View,可以打开一个View,如图1所示,

图1
在这个View中,我们可以创建一个或多个Hadoop运行环境,这个运行环境,有点像,在Eclipse中配置JDBC数据库连接一样。如图2,图3所示:

图2

图3
配置完成以后,显示如图1左边的树形结构一样,这很像在Eclipse配置了,Tomcat的Server项目一样。配置完成以后,显示如图1左边的树形结构一样,这很像在Eclipse配置了,Tomcat的Server项目一样。
你点击view中的小象图标,很可能会报一个错误:
Cannot connect to the Map/Reduce location: hadoop@ubuntu1
java.io.IOException: Unknown protocol to name node:
org.apache.hadoop.mapred.JobSubmissionProtocol
我也遇到这个问题,很让我郁闷,我愿想是不是我的服务器哪里出了问题?后来才知道,是我的端口配置错误了,我在hadoop-site.xml中不是配置了:
这两个端口很重要,9000是namenode的监听端口,而9001是jobtracker的监听端口,在图3的界面上新建DFS location时候,可以看到Map/Reduce Master,当时我还没弄明白,这是什么意思,现在才知道,这是jobtracker所在机器及监听端口,于是我设置成:host=ubuntu1,port=9001,而DFS Master中勾选Use M/R Master Host(意思是:是否使用与JobTracker相同的主机?)我的当然是勾上。端口当然也就是9000了,即host=ubuntu1,port=9000。
于是,连接the Map/Reduce location就不会再出现错误了。下面的用户是cdh,因为我的所有的ubuntu都是cdh的用户的。
我们可以用Web的方式来查看这个两个端口是否工作正常,namenode的Web访问端口是50070,由于我的namenode是建立在ubuntu1上的,因此,我要用Web方式访问namenode,那么在浏览器中敲入地址:http://ubuntu1:50070,你就会看到一个页面,如下图4:

图4
而9001是也是可以用Web方式来访问的,我的namenode和jobtracker是在一台机器上的,网址是http://ubuntu1:50030,如果你配置成功,可以打开如下图5的页面:

图5
tasktracker可以Web方式访问,由于我的tasktracker是建立在ubuntu2上的,因此网址是:http://ubuntu2:50060,如果你配置成功,可以打开如下图6的页面:
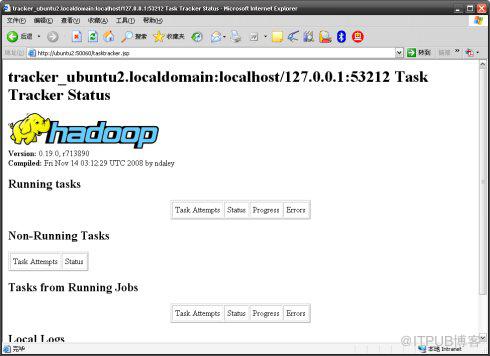
图6
为了能找到本地的Hadoop安装目录,打开Window->Preferences->Hadoop Map/Reduce,将本地的Hadoop安装目录添加进来,这个安装目录实际上就是把hadoop-0.19.0.tar.gz用解压工具解压到一个目录下面。这个目录就是安装目录。我的就是F:hadoop-0.19.0。如图7所示:

图7
点击File->New->Other,在弹出的窗口中会有Map/Reduce项目,如图8所示:

图8
点击下一步,如图9所示,

图9
再点击下一步,如图10所示,点击Finish就成了。

图10
右键点击自己所创建的项目,进入到Properties,打开界面如图11所示,可以在Java Build Path中,设置源代码和Java Doc路径,这样,你就可以看到Hadoop的所有Core源代码了,呵呵

图11
右键点击项目中的src,可以添加Mapper类,Reducer类,以及MapReducerDriver类,向导会自动为你生成这三个类的Framework。这对于新手尤其重要。如图12所示:

图12
编写完你的代码以后,你可以点击你的Driver类->Run on
hadoop,来运行你的Hadoop应用,这个运行是工具自动打包成jar,部署到Hadoop环境上去运行的。呵呵,至此,开发环境就配置好了,你可以尽情地享用Hadoop带给你的快乐了!祝大家在2009年的云计算的开发中,其乐无穷!

0
顶
-
新浪网友2009-02-04 16:27:21
是不是必须用jdk1.6啊。博主回复:2009-02-28 14:00:40
我用的是1.6,但是必须是1.5以上的。
-
新浪网友2009-02-15 18:25:16
你好,请问你是在windows下远程链接hadoop集群的吧?如果是的话,那么不需要设置用户密码吗?博主回复:2009-02-28 13:59:13
是的,我现在还只是初步试验,在一台笔记本上通过VMWare做了两台集群,两个Ubuntu设置的密码和用户名都一样。嗯,有问题可以再问我,我很愿意回答,一起学习。
-
新浪网友2009-03-08 09:14:42
你好,我是一个大四的学生,毕业设计就是选的这个题目,现在还处于配置安装的阶段,因为从来没接触过,就觉得很生疏,我是在windows下面安装好了cygwin,然后按步骤配好了环境变量,在下载了hadoop-0.19.1包,改了里面的hadoop-env.sh文件里面的java_home变量,这样是不是就算是配置好了呢?博主回复:2009-03-11 09:12:38
你好,你这仅仅完成了初步,我在文章里面已经写了,怎么配置。你可以好好看看,你只要按照我的操作步骤来写,肯定能配置成功的。祝你好运。
-
新浪网友2009-03-11 18:33:55
博主你好,我对你这篇文章很感兴趣。
我照着你的前一篇文章,已经在集群上把Hadoop环境搭建起来了。不过进行到这一篇一直不能出现图1的效果,DFS一直连不上。请指教一下可能出什么问题了?配置的时候需要注意哪些问题?谢谢!
报错:Cannotconnect to the Map/Reduce location: test
Failedto get the current user's information
我是在WINDOWS下装的eclipse,不知道是不是这个原因?博主回复:2009-03-30 21:14:12
我的Hadoop环境就是在Windows下面搭建的呀,但是你的Windows登录用户名和密码应该是和Hadoop环境的登录名和密码一致的。
-
新浪网友2009-03-29 16:07:54
用不用装Cygwin啊?博主回复:2009-03-30 21:14:50
用装,如果你要是在Windows下面运行Hadoop的例子的话。
-
新浪网友2009-03-30 17:55:41
你好!请问有没有用过0.18下面的eclipse-plugin,那个怎么不能用?博主回复:2009-03-30 21:15:40
你指的是怎么不能用了,请详细说明。因该在Eclipse3.3下面可以用的。
-
新浪网友2009-05-07 00:39:07
我也出现了相同的问题,我将Windows的登录用户名和密码要与Hadoop环境下的登录用户名和密码一致页不行博主回复:2009-06-06 17:30:24
所以,推荐你的Windows用户和Ubuntu的用户密码完全一致,这样才能开发好Hadoop程序。
-
新浪网友2009-07-23 16:03:44
所有步骤都走通了就是到最后Run on hadoop 什么反应都没有 请问这是怎么回事? -
新浪网友2009-10-22 17:33:09
最后一步不通,是因为你的Eclipse版本不对 -
新浪网友2009-11-03 11:14:45
我的也是上面的走通了,而且我配置好了但是最后一步的时候,Run on Hadoop 什么结果都没有啊,怎么回事啊,还是还有其他的配置? -
新浪网友2009-11-13 16:55:55
2009/2/5n,奻到目前p褐梗?米钚掳娴膃clipse 3.4 搭配 0.18.3 或 0.19.0 版的 hadoop plugin,在"run as" => "run on hadoop" 都q!法正常怟作(a蓨r要_H出恱d莝erver location的墫窗),此UO楲在2008/7/31就被v|s﨨&已被v|OH於(HADOOP-3744) Eclipse Plugin does not work with Eclipse Ganymede (3.4),目前尚待解lz。 -
新浪网友2009-12-28 00:05:46
靠,救我命了你…… -
新浪网友2010-02-28 04:26:23
很感谢。我用classical eclipse 3.5, Hadoop是最新的0.20.1, 阅读了你的文章后,我在src中找到plug-in, eclipse和hadoop都不熟,手动生成jar包,复制到eclipse plugin目录后也配置成功,正在仿写wordcount代码,还没有测试能否运行。 -
新浪网友2010-04-21 09:26:30
博主您好,我想问下有了hadoop-0.19.0-eclipse-plugin.jar这个文件是不是就不用安装mapreducetools工具了??????? -
abin2010-08-25 12:27:55
enyes -
yangyang198733992011-04-21 10:42:15
谢谢你,写的很详细的帖子,我转走了。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/21876206/viewspace-1119789/ ,如需转载,请注明出处,否则将追究法律责任。

