尝试进入大数据领域开发,从目前最火的Hadoop入手是必须的,本文一步步记录了 Ubuntu 环境安装Hadoop 1.2.1 ,搭建单机模式以及伪分布式模式,希望对各位和我一样的菜鸟有所帮助,共同学习进步,欢迎交流。尝试2.1安装失败,由于文件结构不太一样缺乏相关资料,也非做运维的,遂放弃改用成熟的hadoop 1.2.1版本。
----------------------------------------单机模式-----------------------------------------
下载:hadoop-1.2.1.tar.gz
解压:
-
tar
-xzvf hadoop-1.2.1.tar.gz
-
mv
hadoop-1.2.1/ /opt
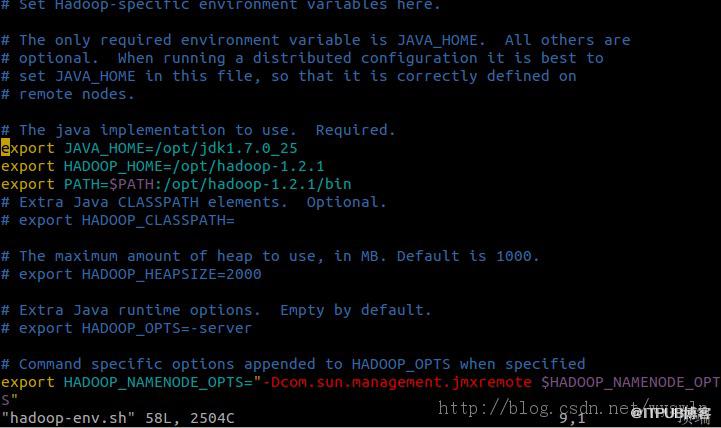
让环境变量配置生效source,是source,不是sh,补充下sh和.的区别,参考
-
source
hadoop-env.sh
检测是否安装成功
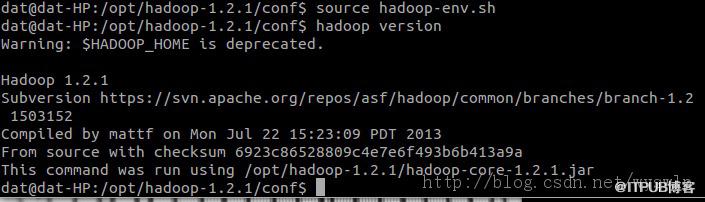
单机版hadoop安装成功,测试一下
-
mkdir
input
-
cp
-R conf input/
运行wordcount程序并将结果保存到output
hadoop hadoop-examples-1.2.1.jar
错误: 找不到或无法加载主类
hadoop-examples-1.2.1.jar
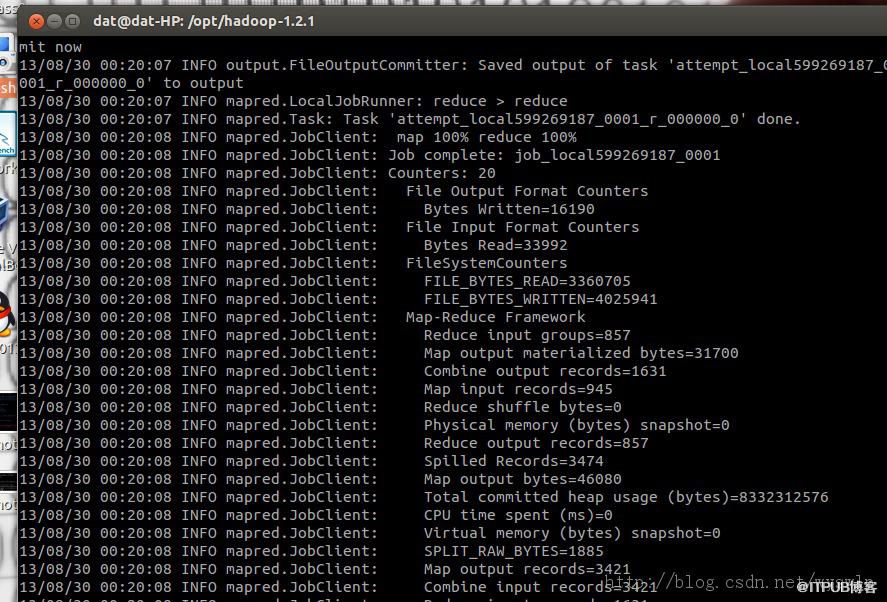
单机模式成功, 接下来搭建伪分布式
-------------------------------------------华丽的分割线 伪分布式-----------------------------------------
hadoop目录下创建以下目录:
-
dat@dat-HP:/opt/hadoop-1.2.1$
mkdir tmp -
dat@dat-HP:/opt/hadoop-1.2.1$
mkdir hdfs -
dat@dat-HP:/opt/hadoop-1.2.1$
mkdir hdfs/name -
dat@dat-HP:/opt/hadoop-1.2.1$
mkdir hafs/data
编辑core-site.xml
-
-
-
fs.default.name -
hdfs://localhost:9000 -
-
-
hadoop.tmp.dir -
/opt/hadoop-1.2.1/tmp -
-
hdfs-site.xml:
-
-
-
dfs.replication -
1 -
-
-
dfs.name.dir -
/opt/hadoop-1.2.1/hdfs/name -
-
-
dfs.data.dir -
/opt/hadoop-1.2.1/hdfs/data -
-
mapred-site.xml:
-
-
-
mapred.job.tracker -
localhost:9001 -
-
格式化HDFS(建议只格式化一次,多次格式化据传后边会引起问题,本人没有尝试...):
-
dat@dat-HP:/opt/hadoop-1.2.1/conf$
source hadoop-env.sh -
dat@dat-HP:/opt/hadoop-1.2.1/conf$
hadoop namenode -format

启动Hadoop:
执行执行bin/start-all.sh来启动所有服务,包括namenode,datanode,start-all.sh脚本用来装载守护进程
-
dat@dat-HP:/opt/hadoop-1.2.1/bin$
start-all.sh

用java的jps命令验证是否安装成功:
-
dat@dat-HP:/opt/hadoop-1.2.1$
jps

少一个DataNode进程没有启动,通过查看上边现实的路径下的日志发现:
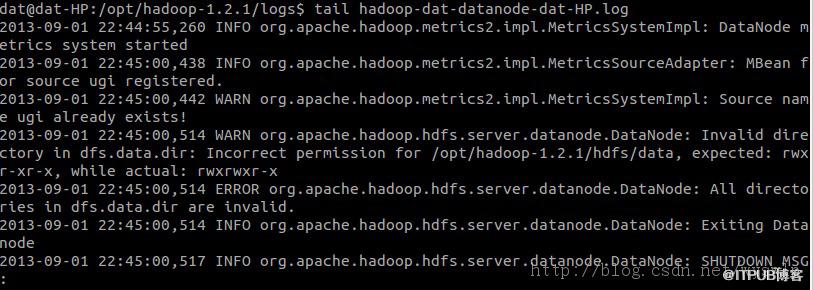
很明显,data文件夹的权限不对,修改权限:
-
dat@dat-HP:/opt/hadoop-1.2.1/hdfs$
chmod 755 data
关闭hadoop,重新启动:
-
dat@dat-HP:/opt/hadoop-1.2.1/bin$
stop-all.sh
-
dat@dat-HP:/opt/hadoop-1.2.1/bin$
start-all.sh
-
dat@dat-HP:/opt/hadoop-1.2.1/bin$
jps
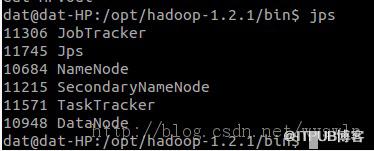
6个进程全部启动了,此时安装正常,可以进行Hadoop的相关操作了。
检查运行状态:可以通过下面的操作来查看服务是否正常,在Hadoop中用于监控集群健康状态的Web界面
http://localhost:50030/
http://localhost:50060/
http://localhost:50070/
hadoop的伪分布模式已经安装成功,再次在伪分布模式下运行一下WordCount来感受MapReduce过程:
这时注意程序是在文件系统dfs运行的,创建的文件也都基于文件系统:
首先在dfs中创建input目录
-
dat@dat-HP:/opt/hadoop-1.2.1/conf$
hadoop dfs -mkdir input -
Warning:
$HADOOP_HOME is deprecated.
将conf中的文件拷贝到dfs中的input
-
dat@dat-HP:/opt/hadoop-1.2.1$
hadoop dfs -copyFromLocal conf/* input
在伪分布式模式下运行WordCount
-
dat@dat-HP:/opt/hadoop-1.2.1$
hadoop jar hadoop-examples-1.2.1.jar wordcount input output

INFO mapred.JobClient:
解决办法:查询鸟文论坛帖子(http://stackoverflow.com/questions/10165549/hadoop-wordcount-example-stuck-at-map-100-reduce-0)发现,修改/etc/hosts文件,加入主机名和IP地址的映射。
检查主机名:
-
dat@dat-HP:/opt/hadoop-1.2.1/conf$
hostname
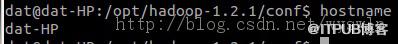
修改/etc/hosts文件:
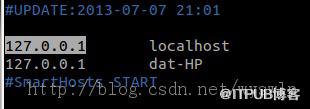
重新来过:
-
hadoop
dfs -rmr output/ -
hadoop
jar hadoop-examples-1.2.1.jar wordcount input output
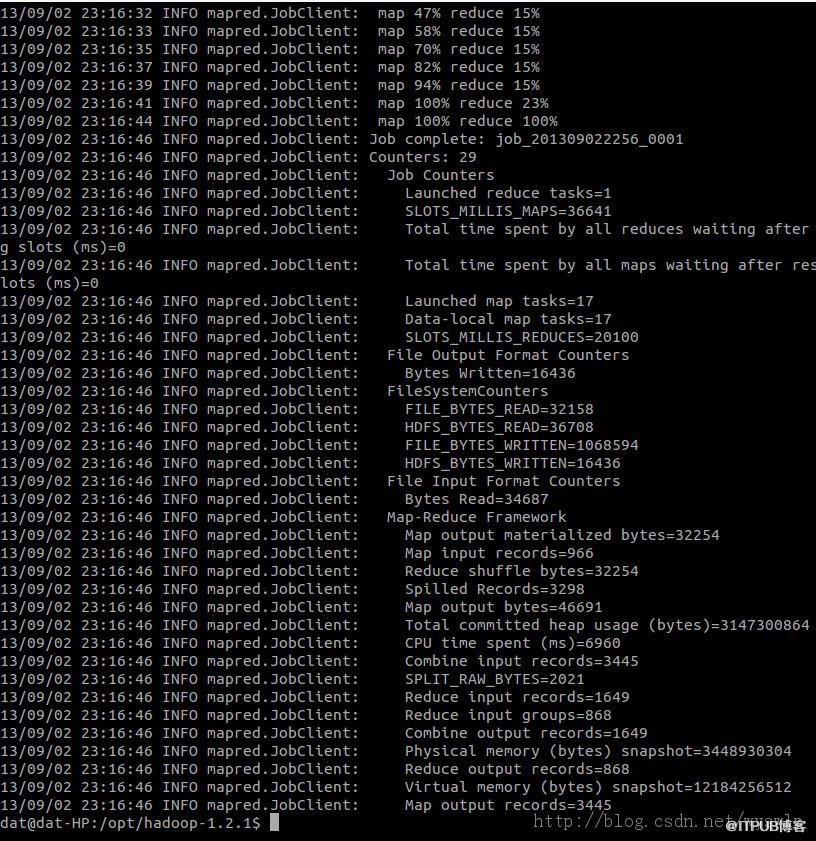
oK!!看见没有,你成功了!!!!!!
检测一下输出信息:
-
dat@dat-HP:/opt/hadoop-1.2.1$
hadoop dfs -cat output/*
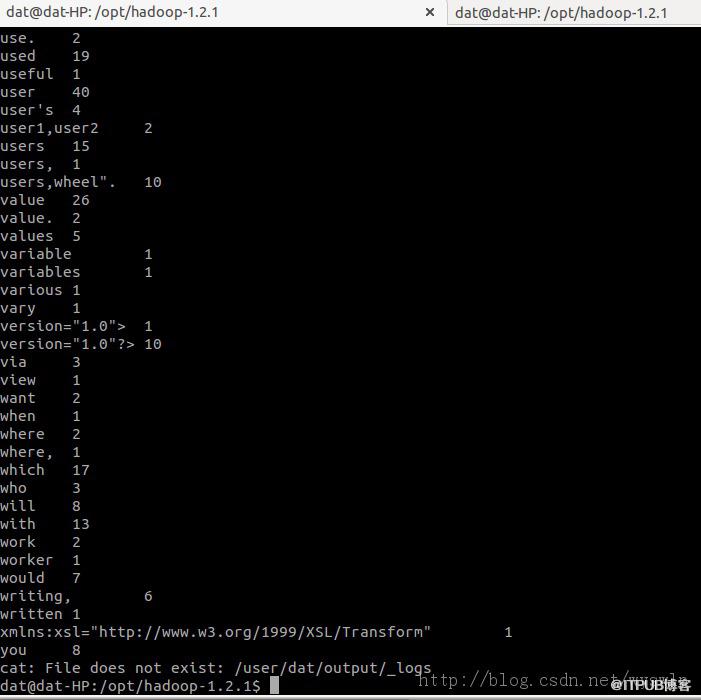
ok!!此时伪分布式系统环境已可以正常使用~~~!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/21340394/viewspace-1120044/ ,如需转载,请注明出处,否则将追究法律责任。

