对象存储进程Object Storage Daemons (OSDs)是分布式文件系统Ceph的一大特点,相比其它分布式文件系统,Ceph扩展性和稳定性更好。关于Ceph是什么,本站后期将会介绍。
在Ceph中,对象先保存到基本OSD,接着复制到其他备份OSD,这个复制过程是同步的,就是写完了,才能告诉上层应用说写成功。保证了数据的可用性。
Client的每个写操作下发到OSD之后,会产生2~3个磁盘seek操作:
把写操作记录到OSD的Journal文件上(Journal是元数据,为了保证写操作的原子性)。
把写操作更新到Object对应的文件上。
把写操作记录到PG Log文件上。
更细一步说,对于一个OSD来说,写完成之前必须要把元数据保存到它的Journal。而写操作是先写Journal,再写Object,所以,为了提升集群性能,写Journal的速度一定要快。
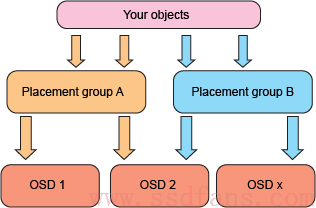
因此,一般为了让Ceph集群更快,性价比更高,需要考虑两条设计思想:
- 把文件放在慢速、便宜的存储设备上,比如SATA HDD。
- 把Journal放在快速设备上,比如SSD,闪存卡。
另一个常见的设计思想是每个HDD对应一个OSD。当前很多系统配备两个SSD,很多HDD,如果SSD只存放Journal的话,容量是完全足够的,因为1个OSD的Journal一般不超过6GB,即使有16个HDD,Journal大约只有96GB,绝大部分SSD的容量是绰绰有余的。
很多管理员担心SSD会挂掉,所以用SSD组成了RAID-1,其实就是搞了个镜像,容量减半。然后把Journal放到了SSD RAID组上。其实还有一个办法是,从每个SSD拿出一个分区组成RAID-1,来做系统盘。剩下的分区来保存Ceph Journal,但是不做RAID。
不过这样有可能会导致一种糟糕的状况。当SSD放了10个或更多OSD Journal,它们和操作系统共享同一个SSD,如果有一段时间大家的读写很频繁的时候,Ceph的性能会受到影响。比如某个主机挂了,冗余机器开始扫描数据做恢复,这个时候,其他OSD的性能就很差了,因为分到的带宽很少了。
那么,使用RAID-1来保护Journal就好一点吗?因为Ceph目前必须要扫描整个OSD文件存储器才能恢复Journal,所以只要Journal丢了,那OSD也就没了,必须要扫描整个磁盘慢慢恢复。但是RAID-1有个缺点就是每次写都要写两遍。其实有个更好的办法就是把所有的OSD Journal分成两拨,分别放到两个SSD,这样,坏掉一个,还有一半的Journal是好的。
Ceph还有个Monitor,MON,主要作用是维持集群的主副本映射图,可以查询同步操作时的最新版本的映射图。利用的key/value存储快照和迭代器,执行OSD的同步。如果MON和OSD在同一个SSD上时,如果SSD变慢,那么MON也就挂掉了,如果有备份MON的话,操作不受影响。
如果要用SSD和HDD来部署Ceph的话,那么最终的结论是:
- 每个节点的OSD不要太多,小于8个比较合适,这种情况下Journal放在SSD效果比较好。原因就是SSD Journal多了,性能就受影响。
- 假如OSD实在太多,那就不要用SSD保存Journal,用HDD可能更好一点。或者说把OS装在HDD上,然后用没有RAID的SSD保存OSD Journal。
-
用一些专用的MON。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/196700/viewspace-2151931/ ,如需转载,请注明出处,否则将追究法律责任。

