回归算法的实现过程与分类算法类似,区别在于分类算法的标签是分离散的(字符型分类而不是数值性),而回归算法的标签是连续的(数值性)。常用的有 linear_model 、 svm 、 neighbors 、 tree 、 ensemble ( RandomForestClassifier )、 ensemble(GradientBoostingClassifier) 等。
以 boston 数据集为例,使用 sklearn 估计器构建线性回归模型,具体代码如下:
##加载所需函数
from sklearn.linear_model import LinearRegression
from sklearn.datasets import load_boston
from sklearn.model_selection import train_test_split
## 加载boston数据
boston = load_boston()
X = boston['data']
y = boston['target']
names = boston['feature_names']
## 将数据划分为训练集测试集
X_train,X_test,y_train,y_test = train_test_split(X,y,test_size = 0.2,random_state=125)
## 建立线性回归模型
clf = LinearRegression().fit(X_train,y_train)
print('建立的LinearRegression模型为:','\n',clf)
## 预测训练集结果
y_pred = clf.predict(X_test)
print('预测前20个结果为:','\n',y_pred[:20])
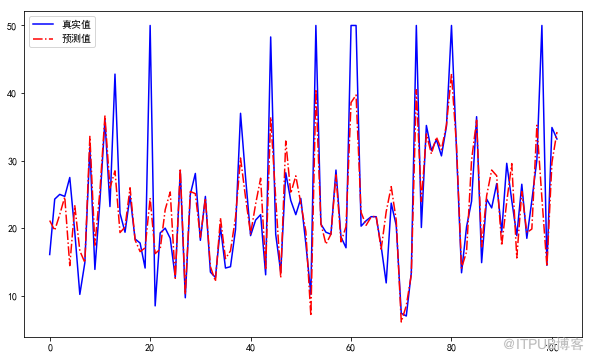
## 回归结果可视化
import matplotlib.pyplot as plt
from matplotlib import rcParams
rcParams['font.sans-serif'] = 'SimHei'
fig = plt.figure(figsize=(10,6)) ##设定空白画布,并制定大小
##用不同的颜色表示不同数据
plt.plot(range(y_test.shape[0]),y_test,color="blue", linewidth=1.5, linestyle="-")
plt.plot(range(y_test.shape[0]),y_pred,color="red", linewidth=1.5, linestyle="-.")
plt.legend(['真实值','预测值'])
plt.savefig('tmp/聚类结果.png')
plt.show() ##显示图片
##评价回归模型
from sklearn.metrics import explained_variance_score,\
mean_absolute_error,\
mean_squared_error,\
median_absolute_error,r2_score
print('Boston数据线性回归模型的平均绝对误差为:',
mean_absolute_error(y_test,y_pred))
print('Boston数据线性回归模型的均方误差为:',
mean_squared_error(y_test,y_pred))
print('Boston数据线性回归模型的中值绝对误差为:',
median_absolute_error(y_test,y_pred))
print('Boston数据线性回归模型的可解释方差值为:',
explained_variance_score(y_test,y_pred))
print('Boston数据线性回归模型的R方值为:',
r2_score(y_test,y_pred))
------
Boston数据线性回归模型的平均绝对误差为: 3.377642697362844
Boston数据线性回归模型的均方误差为: 31.150596676905256
Boston数据线性回归模型的中值绝对误差为: 1.7774213157359604
Boston数据线性回归模型的可解释方差值为: 0.7105949626282883
Boston数据线性回归模型的R方值为: 0.7068954225782389
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/18841027/viewspace-2655952/ ,如需转载,请注明出处,否则将追究法律责任。

