摘要:本文指在详细介绍语音转化声学特征的过程,并详细介绍不同声学特征在不同模型中的应用。
本文分享自华为云社区《你真的懂语音特征背后的原理吗?》,作者: 白马过平川 。
语音数据常被用于人工智能任务,但语音数据往往不能像图像任务那样直接输入到模型中训练,其在长时域上没有明显的特征变化,很难学习到语音数据的特征,加之语音的时域数据通常由16K采样率构成,即1秒16000个采样点,直接输入时域采样点训练数据量大且很难有训练出实际效果。因此语音任务通常是将语音数据转化为声学特征作为模型的输入或者输出。因此本文指在详细介绍语音转化声学特征的过程,并详细介绍不同声学特征在不同模型中的应用。
首先搞清语音是怎么产生的对于我们理解语音有很大帮助。人通过声道产生声音,声道的形状决定了发出怎样的声音。声道的形状包括舌头,牙齿等。如果可以准确的知道这个形状,那么我们就可以对产生的音素进行准确的描述。声道的形状通常由语音短时功率谱的包络中显示出来。那如何得到功率谱,或者在功率谱的基础上得到频谱包络,便是可以或得语音的特征。
一、时域图
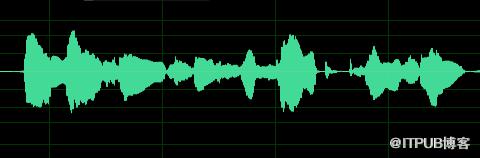
图1:音频的时域图
时域图中,语音信号直接用它的时间波形表示出来,上图1是用Adobe Audition打开的音频的时域图,表示这段语音波形时量化精度是16bit,从图中可以得到各个音的起始位置,但很难看出更加有用的信息。但如果我们将其放大到100ms的场景下,可以得到下图2所示的图像。
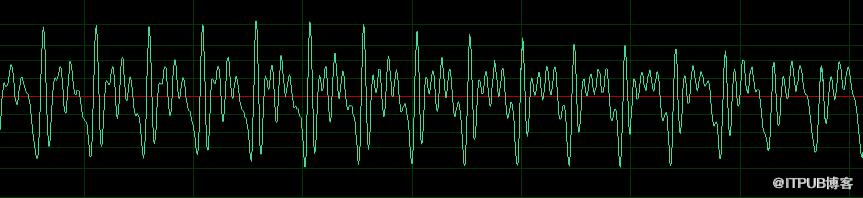
图2:音频的短时时域图
从上图我们可以看出在短时的的时间维度上,语音时域波形是存在一定的周期的,不同的发音往往对应着不同的周期的变化,因此在短时域上我们可以将波形通过傅里叶变换转化为频域图,观察音频的周期特性,从而获取有用的音频特征。
短时傅里叶变换(STFT)是最经典的时频域分析方法。所谓短时傅里叶变换,顾名思义,是对短时的信号做傅里叶变化。由于语音波形只有在短时域上才呈现一定周期性,因此使用的短时傅里叶变换可以更为准确的观察语音在频域上的变化。傅里叶变化实现的示意图如下:
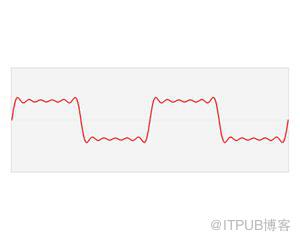
图3:傅里叶变换的从时域转化为频域的示意图
上图显示的了如何通过傅里叶变化将时域波形转化为频域谱图的过程,但在由于本身傅里叶变化的算法复杂度为O(N^2),难以应用,在计算机中应用中更多的是使用快速傅里叶变换(FFT)。其中转化的推理证明参考[知乎](https://zhuanlan.zhihu.com/p/31584464)
二、获取音频特征
由上述一可以知道获取音频的频域特征的具体方法原理,那如何操作将原始音频转化为模型训练的音频特征,其中任然需要很多辅助操作。具体流程如下图4所示:
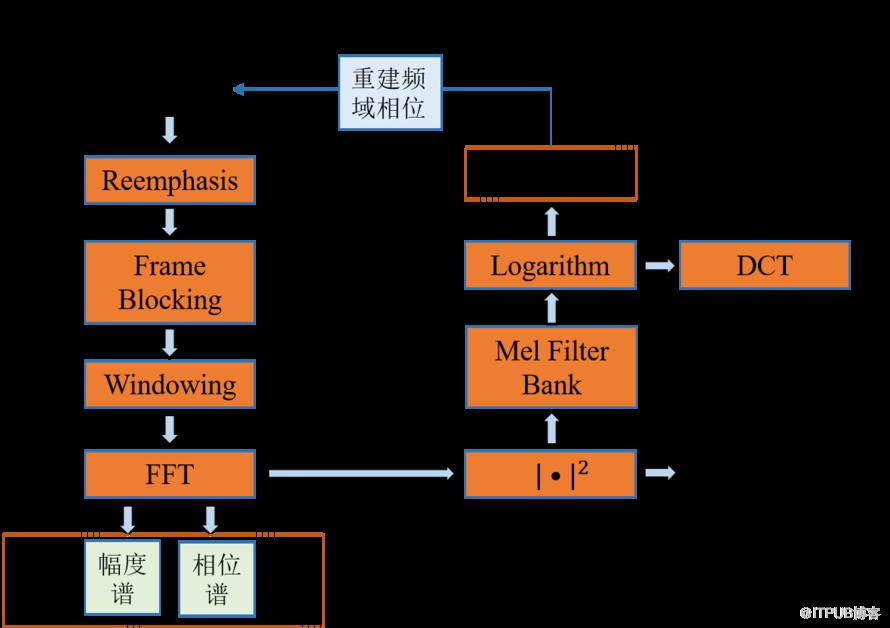
图4:音频转化为音频特征的流程图
(1)预加重
预加重处理其实是将语音信号通过一个高通滤波器:
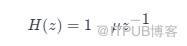
其中muμ ,我们通常取为0.97。预加重的目的是提升高频部分,使信号的频谱变得平坦,保持在低频到高频的整个频带中,能用同样的信噪比求频谱。同时,也是为了消除发生过程中声带和嘴唇的效应,来补偿语音信号受到发音系统所抑制的高频部分,也为了突出高频的共振峰。
pre_emphasis = 0.97
emphasized_signal = np.append(original_signal[0], original_signal[1:] - pre_emphasis * original_signal[:-1])
(2)分帧
由于傅里叶变换要求输入信号是平稳的,不平稳的信号做傅里叶变换是没有什么意义的。由上述我们可以知道语音在长时间上是不稳定的,在短时上稳定是有一定的周期性的,即语音在宏观上来看是不平稳的,你的嘴巴一动,信号的特征就变了。但是从微观上来看,在比较短的时间内,嘴巴动得是没有那么快的,语音信号就可以看成平稳的,就可以截取出来做傅里叶变换了,因此要进行分帧的操作,即截取短时的语音片段。
那么一帧有多长呢?帧长要满足两个条件:
- 从宏观上看,它必须足够短来保证帧内信号是平稳的。前面说过,口型的变化是导致信号不平稳的原因,所以在一帧的期间内口型不能有明显变化,即一帧的长度应当小于一个音素的长度。正常语速下,音素的持续时间大约是 50~200 毫秒,所以帧长一般取为小于 50 毫秒。
- 从微观上来看,它又必须包括足够多的振动周期,因为傅里叶变换是要分析频率的,只有重复足够多次才能分析频率。语音的基频,男声在 100 赫兹左右,女声在 200 赫兹左右,换算成周期就是 10 ms和 5 ms。既然一帧要包含多个周期,所以一般取至少 20 毫秒。
注意: 分帧的截取并不是严格的分片段,而是有一个帧移的概念,即确定好帧窗口的大小,每次按照帧移大小移动,截取短时音频片段,通常帧移的大小为5-10ms,窗口的大小通常为帧移的2-3倍即20-30ms。之所以设置帧移的方式主要是为了后续加窗的操作。
具体分帧的流程如下所示:
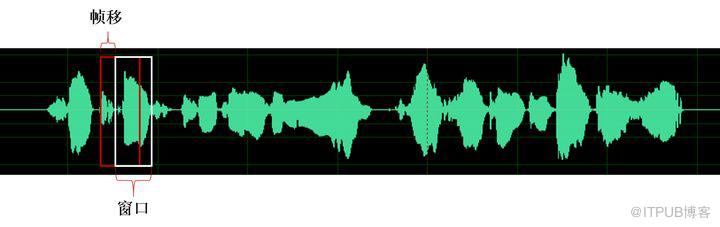
图5:音频分帧示意图
(3)加窗
取出来的一帧信号,在做傅里叶变换之前,要先进行「加窗」的操作,即与一个「窗函数」相乘,如下图所示:
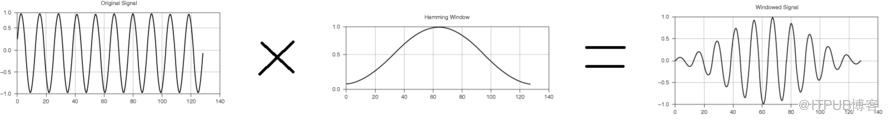
图5:音频加窗示意图
加窗的目的是让一帧信号的幅度在两端渐变到 0。渐变对傅里叶变换有好处,可以让频谱上的各个峰更细,不容易糊在一起(术语叫做减轻频谱泄漏),加窗的代价是一帧信号两端的部分被削弱了,没有像中央的部分那样得到重视。弥补的办法是,帧不要背靠背地截取,而是相互重叠一部分。相邻两帧的起始位置的时间差叫做帧移。
通常我们使用汉明窗进行加窗,将分帧后的每一帧乘以汉明窗,以增加帧左端和右端的连续性。假设分帧后的信号为 S(n), n=0,1,…,N-1, NS(n),n=0,1,…,N−1,N 为帧的大小,那么乘上汉明窗后:
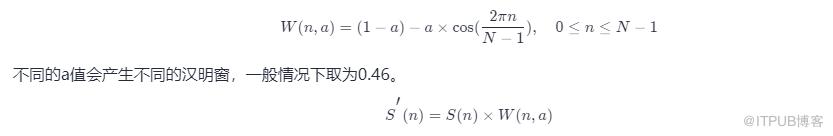
实现的代码:
# 简单的汉明窗构建
N = 200
x = np.arange(N)
y = 0.54 * np.ones(N) - 0.46 * np.cos(2*np.pi*x/(N-1))

# 加汉明窗
frames *= np.hamming(frame_length)
(4)快速傅里叶变换FFT
由于信号在时域上的变换通常很难看出信号的特性,所以通常将它转换为频域上的能量分布来观察,不同的能量分布,就能代表不同语音的特性。在乘上汉明窗后,每帧还必须再经过快速傅里叶变换以得到在频谱上的能量分布。对分帧加窗后的各帧信号进行快速傅里叶变换得到各帧的频谱。快速傅里叶变换的实现原理已经在前面介绍过,这里不过多介绍。详细的推理和实现推介参考知乎FFT(http://su.modelarts.club/qQB9)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/1830/viewspace-2795916/ ,如需转载,请注明出处,否则将追究法律责任。

