一位前辈发给我一道算法题,这里整理一下自己的解题思路。
请设计一种处理算法能高效的检查出字符串中第一次出现的重复字符。给定的字符串长度小于等于500个字符,包含字母、数字、英文符号。
解
查找第一次出现的重复字符...
- 逐个遍历字符,判断当前字符之前的字符数组中是否出现此字符,第一次出现则跳出循环
考察:在字符数组中如何快速的查找某个字符。
知识:
- 字符是Java中的原始(Primitive)类型,可以和int类型直接转换的。它的包装类为Character.
- 要查找字符数组是无序的,要不要对无序数组进行排序?不需要排序:排序算法最快的时间复杂度也为O(nlogn),而遍历一遍的时间复杂度为O(n),所以如果只进行一次操作,排序不如遍历。
- 如果能进行O(1),或者比O(1)略差一点的操作就好了,可以考虑使用HashMap,HashSet直接取值,HashMap内部使用数组来存储数据。
实现
- 普通版本,因为看到字符串长度小于500个字符,查找重复的字符,数据量比较小,普通的两层循环在数据量小的时候也可以尝试。时间复杂度为O(n^2)
    /**
     * 常规的查找第一个重复字符串的方法
     * @return 当字符串为空时,返回null
     */
    public static Character normalFind(String str){

        if (str == null || "".equals(str)) {
            return null;
        }

        if (str.length() > 500){
            //日志,根据文档,判断是否处理大字符串
            System.out.println("warn 输入的字符长度过大");
        }

for (int i = 1; i - 剥离HashMap实现部分,自己实现HashMap内部的数组存取,数据量比较小,采用简化的链表。
- 考虑到数据量是在是太小的时候,这里阈值设置为15,长度小于15时使用常规的查找来操作,省的创建对象分配空间
- 可设置内部要索引的数组容量。
依次遍历每个字符,遍历过的字符进行hashCode,字符的hashCode为自身代表的int值,hashCode与数组容量求余,将字符再以链表的形式存在数组中,如果其它字符的求出的下标重复,将当前节点加入到链表的最后节点。
    static class Node {
        /**
         * 存放下个节点
         */
        Node next;

        /**
         * 存放当前节点的值
         */
        int value;

        public Node() {
        }

        public Node(Node next, int value) {
            this.next = next;
            this.value = value;
        }

    }

      public static Character myFind(String str, Integer capacity) {
        if (str == null || "".equals(str)) {
            return null;
        }
        if (str.length() > 500) {
            //日志,根据说明判断是否处理
            System.out.println("warn 输入的字符长度过大");
        }
        if (str.length() = 500){
            capacity = 500;
        }

        Node[] chars = new Node[capacity];
for (int i = 0; i - 采用HashSet,Java内置数据结构进行数据的存取
如果待查找的字符数组中不存在字符,就加入新的字符,如果存在字符就返回当前字符
    public static Character setFind(String str) {
        if (str == null || "".equals(str)) {
            return null;
        }

        if (str.length() > 500) {
            //日志,根据说明判断是否处理
            System.out.println("warn 输入的字符长度过大");
        }

        HashSet hashSet = new HashSet();
        for (int i = 0; i
测试结果
测试代码如下:
 /**
     * 1. 字符类型为数字,字母,特殊字符
     * 2. 数组时连续的内存空间,可以直接根据下标来查找元素
     * 3. 计算机对数字比对字符敏感,因此字符的存储采用数字形式
     */
  public static void main(String[] args) {
        if (args.length == 0) {
            System.out.println("请在运行时输入字符串");
            return;
        }

        for (int i = 0; i
编译运行程序
javac me/aihe/exam/FindFirstRepeatdChar.java 运行程序: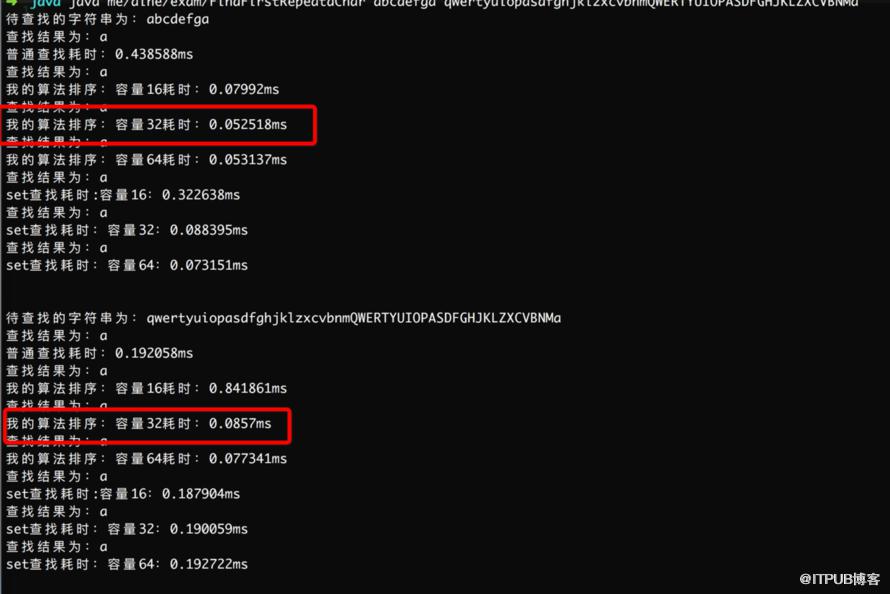
暂时只用了两个长度的字符串测试,可以多运行几次查看效果, 一般耗时和字符串的长度与指定的数组容量有关。
分析
- 这次写的算法是牺牲空间来换取时间,普通的按顺序逐个对比不需要额外的空间。
- 算法参考HashMap内部实现,但对其做了一些精简处理,Node节点这次存储的是字符字符的hashCode值,字符与int可以互相转换,Node只存储值就好了。
- 省去了HashMap的resize()操作,直接在查找的时候指定数组的容量。数组的空间越大越不容易产生下标冲突,可以直接进行O(1)取出数据。
最后
最近越来越意识到算法的重要性,也在恶补中,稳扎稳打,希望能早日实现目标。
附录
完整代码:
package me.aihe.exam;

import java.math.BigDecimal;
import java.util.HashSet;

/**
 * @author aihe 2018/6/27
 */
public class FindFirstRepeatdChar {

    static class Node {
        /**
         * 存放下个节点
         */
        Node next;

        /**
         * 存放当前节点的值
         */
        int value;

        public Node() {
        }

        public Node(Node next, int value) {
            this.next = next;
            this.value = value;
        }

    }

    /**
     * 普通的查找第一个重复字符串的方法
     *
     * @return
     */
    public static Character normalFind(String str) {

        if (str == null || "".equals(str)) {
            return null;
        }

        if (str.length() > 500) {
            //日志,根据说明判断是否处理
            System.out.println("warn 输入的字符长度过大");
        }
        //从第一个下标开始找
        for (int i = 1; i  500) {
            //日志,根据说明判断是否处理
            System.out.println("warn 输入的字符长度过大");
        }
        if (str.length() = 500){
            capacity = 500;
        }

        Node[] chars = new Node[capacity];
        for (int i = 0; i  500) {
            //日志,根据说明判断是否处理
            System.out.println("warn 输入的字符长度过大");
        }

        if (capacity == null){
            capacity = 16;
        }

        if (capacity >= 500){
            capacity = 500;
        }
        HashSet hashSet = new HashSet(capacity);
        for (int i = 0; i ?[]{}交换代码由学会制定单符编方案基文本数据。起始于后期年最初是美家供不同计算机在相互通信时用作共遵守的西字它已被国际标准化组织定为国际标准,称为ISO 646标准。适用于所有拉丁文字字母";
        if (args.length == 0) {
            System.out.println("请在运行时输入字符串");
            return;
        }

        for (int i = 0; i
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/1747/viewspace-2803354/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
8个超炫酷仿苹果应用的HTML5动画
下一篇:
Chrome中开启ssh一种什么体验

请登录后发表评论
登录
全部评论
