Hadoop平台上的海量数据排序
Yahoo!研究人员使用Hadoop完成了Jim Gray基准排序,此排序包含许多相关的基准,每个基准都有自己的规则。所有的排序基准都是通过测量不同记录的排序时间来制定的,每个记录为100字节,其中前面的10字节是键,剩余的部分是数值。MinuteSort是比较在一分钟内所排序的数据量大小,GraySort是比较在对大规模数据(至少100TB)进行排序时的排序速率(TBs/minute)。基准规则具体如下:
- 输入数据必须与数据生成器生成的数据完全匹配;
- 任务开始的时候,输入数据不能在操作系统的文件缓存中。在Linux环境下,排序程序之间需要使用内存来交换其他内容;
- 输入和输出数据都是没有经过压缩的;
- 输出不能对输入进行重写;
- 输出文件必须存放到磁盘上;
- 必须计算输入和输出数据的每个键/值对的CRC32,共128位校验和,当然,输入和输出必须对应相等;
- 输出如果分成多个输出文件,那么必须是完全有序的,也就是将这些输出文件连接以后必须是完全有序的输出;
- 开始和分布程序到集群上也要记入计算时间内;
- 任何抽样也要记入计算时间内。
Yahoo!的研究人员使用Hadoop排列1TB数据用时62秒,排列1PB数据用时16.25个小时,具体如表3-2所示,它获得了Daytona类GraySort和MinuteSort级别的冠军。
表3-2 数据规模与排序时间
| 数据大小(Bytes) | 节 点 数 | 副 本 数 | 时 间 |
| 500 000 000 000 | 1406 | 1 | 59秒 |
| 100 000 000 000 000 | 3452 | 2 | 173分钟 |
| 1 000 000 000 000 000 | 3658 | 2 | 975分钟 |
下面的内容是根据基准排序的官方网站(http://sortbenchmark.org/)上有关使用Hadoop排序的相关内容整理而成。
- Yahoo!的研究人员编写了三个Hadoop应用程序来进行TB级数据的排序:
- TeraGen是产生数据的map/reduce程序;
- TeraSort进行数据取样,并使用map/reduce对数据进行排序;
- TeraValidate是用来验证输出数据是否有序的map/reduce程序。
TeraGen用来产生数据,它将数据按行排列并且根据执行任务的数目为每个map分配任务,每个map任务产生所分配行数范围内的数据。最后,TeraGen使用1800个任务产生总共100亿行的数据存储在HDFS上,每个存储块的大小为512MB。
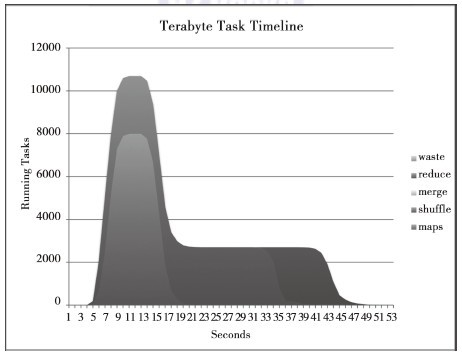
TeraSort是标准的map/reduce排序程序,但这里使用的是不同的分配方法。程序中使用N-1个已排好序的抽样键值来为reduce任务分配排序数据的行数范围。例如,键值key在范围sample[i-1]<=key TeraValidate保证输出数据是全部排好序的,它为输出目录的每个文件分配一个map任务(如图3-10所示),map任务检查每个值是否大于等于前一个值,同时输出最大值和最小值给reduce任务,reduce任务检查第i个文件的最小值是否大于第i-1文件的最大值,如果不是则产生错误报告。 图3-9 reduce任务的输出大小和完成时间分布图 以上应用程序运行在雅虎搭建的集群上,其集群配置为: 整个排序过程在209秒(3.48分钟)内完成,尽管拥有910个节点,但是网络核心是与其他2000个节点的集群共享的,所以运行时间会因为其他集群的活动而有所变化。 使用Hadoop进行 GraySort基准排序时,Yahoo!的研究人员将上面的map/reduce应用程序稍加修改以适应新的规则,整个程序分为4个部分,分别为: TeraGen和TeraSort与上面介绍的一样,TeraValidate除了增加了计算输出目录校验和总和的任务以外,其他都一样,这里不再赘述。 TeraSum计算每个键/值对的CRC32的校验和,每个map任务计算输入的校验和并输出,然后一个reduce任务将每个map生成的校验和相加。这个程序用来计算输入目录下每个键/值对校验和的和,还用来检查排序输出后的正确性。 图3-10 每个阶段的任务数 这次基准测试运行在Yahoo!的Hammer集群上,集群的具体细节如下: 对于较大规模的排序,这里NameNode和JobTracker使用的是64位的JVM。排序测试所用的Hadoop平台也做了一些变化,主要有: Hadoop与上面的测试相比有了很大的改进,可以在更短的时间内执行更多的任务。值得注意的是,在大集群和分布式应用程序中需要转移大量数据,这会导致执行时间有很大的变化。但是随着Hadoop的改进,它能够更好地处理硬件故障,这种时间变化也就微不足道了。不同规模的数据排序所需的时间如表3-2所示。 因为较小规模的数据需要更短的延迟和更快的网络,所以使用集群中的部分节点来进行计算。将较小规模计算的输出副本数设置为1,因为整个过程较短且运行在较小的集群上,节点坏掉的可能性相对较小。而在较大规模的计算上,节点坏掉是难免的,于是将节点副本数设置为2。HDFS保证节点换掉后数据不会丢失,因为不同的副本放在不同的节点上。 Yahoo!的研究人员统计了JobTracker上从任务提交状况获得的任务数随时间的变化,图3-11、图3-12、图3-13、图3-14显示了每个时间点下的任务数。maps只有一个阶段,而reduces拥有三个阶段:shuffle、merge和reduce。shuffle是从maps中转移数据的,merge在测试中并不需要;reduce阶段进行最后的聚集并写到HDFS上。如果将这些图与图3-6进行比较,你会发现建立任务的速度变快了。图3-6中每次心跳建立一个任务,那么所有任务建立起来需要40秒,现在Hadoop每次心跳可以设置好一个TaskTracker,可见减少任务建立的开销是非常重要的。 图3-11 数据量为500GB时任务数随时间的变化 图3-12 数据量为1TB时任务数随时间的变化 图3-13 数据量为100TB时任务数随时间的变化 图3-14 数据量为1PB时任务数随时间的变化 运行大规模数据时,数据传输的次数对任务性能的影响也是非常大的。在PB级数据排序中,每个map处理15GB的数据而不是默认的128MB,每个reduce处理50GB的数据。如果按照1.5GB/map进行处理,需要 40个小时才能完成。因此,为了增加吞吐量,增加每个块的大小是非常重要的。 ---------------------------------- 本文节选自《Hadoop实战》第3章 3.5节“Hadoop平台上的海量数据排序”(作者:陆嘉恒) 《Hadoop实战》目录 前言



第1 章 Hadoop 简介/1
1.1 什么是Hadoop/2
1.1.1 Hadoop 概述/2
1.1.2 Hadoop 的历史/2
1.1.3 Hadoop 的功能与作用/2
1.1.4 Hadoop 的优势/3
1.1.5 Hadoop 的应用现状和发展趋势/3
1.2 Hadoop 项目及其结构/3
1.3 Hadoop 的体系结构/6
1.3.1 HDFS 的体系结构/6
1.3.2 MapReduce 的体系结构/7
1.4 Hadoop 与分布式开发/7
1.5 Hadoop 计算模型—MapReduce/10
1.6 Hadoop 的数据管理/10
1.6.1 HDFS 的数据管理/11
1.6.2 HBase 的数据管理/12
1.6.3 Hive 的数据管理/15
1.7 小结/17
第2 章 Hadoop 的安装与配置 /18
2.1 在Linux 上安装与配置Hadoop/19
2.1.1 安装JDK 1.6/19
2.1.2 配置SSH 免密码登录/20
2.1.3 安装并运行Hadoop/21
2.2 在Windows 上安装与配置Hadoop/23
2.2.1 安装Cygwin/24
2.2.2 配置环境变量/24
2.2.3 安装和启动sshd 服务/24
2.2.4 配置SSH 免密码登录/24
2.3 安装和配置Hadoop 集群/25
2.3.1 网络拓扑/25
2.3.2 定义集群拓扑/25
2.3.3 建立和安装Cluster /26
2.4 日志分析及几个小技巧/32
2.5 小结/33
第3 章 Hadoop 应用案例分析/35
3.1 Hadoop 在Yahoo !的应用/36
3.2 Hadoop 在eBay 的应用/38
3.3 Hadoop 在百度的应用/40
3.4 Hadoop 在Facebook 的应用/43
3.5 Hadoop 平台上的海量数据排序/46
3.6 小结/53
第4 章 MapReduce 计算模型/54
4.1 为什么要用MapReduce/55
4.2 MapReduce 计算模型 /56
4.2.1 MapReduce Job/56
4.2.2 Hadoop 中的Hello World 程序/56
4.2.3 MapReduce 的数据流和控制流/64
4.3 MapReduce 任务的优化/65
4.4 Hadoop 流 /67
4.4.1 Hadoop 流的工作原理/68
4.4.2 Hadoop 流的命令/69
4.4.3 实战案例:添加Bash 程序和Python 程序到Hadoop 流中/70
4.5 Hadoop Pipes/72
4.6 小结 /74
第5 章 开发MapReduce 应用程序/75
5.1 系统参数的配置/76
5.2 配置开发环境 /78
5.3 编写MapReduce 程序/79
5.3.1 Map 处理/79
5.3.2 Reduce 处理/80
5.4 本地测试 /81
5.5 运行MapReduce 程序 /83
5.5.1 打包/84
5.5.2 在本地模式下运行/85
5.5.3 在集群上运行/86
5.6 网络用户界面/87
5.6.1 JobTracker 页面/87
5.6.2 工作页面/88
5.6.3 返回结果/90
5.6.4 任务页面/93
5.6.5 任务细节页面/93
5.7 性能调优/94
5.8 MapReduce 工作流/96
5.8.1 将问题分解成MapReduce 工作/97
5.8.2 运行相互依赖的工作/97
5.9 小结/98
第6 章 MapReduce 应用案例/99
6.1 单词计数/100
6.1.1 实例描述/100
6.1.2 设计思路/100
6.1.3 程序代码/101
6.1.4 代码解读/102
6.1.5 程序执行/103
6.1.6 代码结果/103
6.2 数据去重/104
6.2.1 实例描述/104
6.2.2 设计思路/105
6.2.3 程序代码/105
6.3 排序/106
6.3.1 实例描述/106
6.3.2 设计思路/107
6.3.3 程序代码/107
6.4 单表关联/109
6.4.1 实例描述/109
6.4.2 设计思路/110
6.4.3 程序代码/110
6.5 多表关联/113
6.5.1 实例描述/113
6.5.2 设计思路/114
6.5.3 程序代码/114
6.6 小结/116
第7 章 MapReduce 工作机制/117
7.1 MapReduce 作业的执行流程/118
7.1.1 MapReduce 任务的执行总流程/118
7.1.2 提交作业/119
7.1.3 初始化作业/121
7.1.4 分配任务/123
7.1.5 执行任务/125
7.1.6 更新任务执行进度和状态/126
7.1.7 完成作业/127
7.2 错误处理机制 /127
7.2.1 硬件故障/127
7.2.2 任务失败/128
7.3 作业调度机制 /128
7.4 shuffle 和排序/129
7.4.1 map 端/130
7.4.2 reduce 端/131
7.4.3 shuffle 过程的优化/132
7.5 任务执行 /133
7.5.1 推测式执行/133
7.5.2 任务JVM 重用/134
7.5.3 跳过坏记录/134
7.5.4 任务执行环境/135
7.6 小结/136
第8 章 Hadoop I/O 操作/137
8.1 I/O 操作中的数据检查/138
8.2 数据的压缩 /142
8.2.1 Hadoop 对压缩工具的选择/142
8.2.2 压缩分割和输入分割/143
8.2.3 在MapReduce 程序中使用压缩/143
8.3 数据的I/O 中序列化操作/144
8.3.1 Writable 类/144
8.3.2 实现自己的Hadoop 数据类型/152
8.4 针对MapReduce 的文件类/153
8.4.1 SequenceFile 类/154
8.4.2 MapFile 类/159
8.5 小结/161
第9 章 HDFS 详解/162
9.1 Hadoop 的文件系统/163
9.2 HDFS 简介/165
9.3 HDFS 体系结构/166
9.3.1 HDFS 的相关概念/166
9.3.2 HDFS 的体系结构/167
9.4 HDFS 的基本操作/169
9.4.1 HDFS 的命令行操作/169
9.4.2 HDFS 的Web 界面/171
9.5 HDFS 常用Java API 详解/173
9.5.1 使用Hadoop URL 读取数据/173
9.5.2 使用FileSystem API 读取数据/174
9.5.3 创建目录/176
9.5.4 写数据/177
9.5.5 删除数据/178
9.5.6 文件系统查询/178
9.6 HDFS 中的读写数据流/182
9.6.1 文件的读取/182
9.6.2 文件的写入/184
9.6.3 一致性模型/185
9.7 HDFS 命令详解/186
9.7.1 通过distcp 进行并行复制/186
9.7.2 HDFS 的平衡/187
9.7.3 使用Hadoop 归档文件/188
9.7.4 其他命令/190
9.8 小结/194
第10 章 Hadoop 的管理/195
10.1 HDFS 文件结构/196
10.2 Hadoop 的状态监视和管理工具/200
10.2.1 审计日志/200
10.2.2 监控日志/200
10.2.3 Metrics/201
10.2.4 Java 管理扩展 /203
10.2.5 Ganglia/204
10.2.6 Hadoop 管理命令/206
10.3 Hadoop 集群的维护/210
10.3.1 安全模式/210
10.3.2 Hadoop 的备份/211
10.3.3 Hadoop 的节点管理/212
10.3.4 系统升级/214
10.4 小结/216
第11 章 Hive 详解/217
11.1 Hive 简介/218
11.1.1 Hive 的数据存储/218
11.1.2 Hive 的元数据存储/220
11.2 Hive 的基本操作/220
11.2.1 在集群上安装Hive/220
11.2.2 配置Hive/222
11.3 Hive QL 详解/224
11.3.1 数据定义(DDL)操作/224
11.3.2 数据操作(DML)/231
11.3.3 SQL 操作/233
11.3.4 Hive QL 的使用实例/235
11.4 Hive 的网络(WebUI)接口/237
11.5 Hive 的JDBC 接口/238
11.6 Hive 的优化/241
11.7 小结/243
第12 章 HBase 详解/244
12.1 HBase 简介/245
12.2 HBase 的基本操作/245
12.2.1 HBase 的安装/245
12.2.2 运行HBase /249
12.2.3 HBase Shell/250
12.2.4 HBase 配置/254
12.3 HBase 体系结构/255
12.4 HBase 数据模型/259
12.4.1 数据模型/259
12.4.2 概念视图/260
12.4.3 物理视图/260
12.5 HBase 与RDBMS/261
12.6 HBase 与HDFS/262
12.7 HBase 客户端/262
12.8 Java API /263
12.9 HBase 编程实例之MapReduce /270
12.10 模式设计/273
12.10.1 学生表/273
12.10.2 事件表/274
12.11 小结/275
第13 章 Mahout 详解/276
13.1 Mahout 简介/277
13.2 Mahout 的安装和配置/277
13.3 Mahout API 简介/278
13.4 Mahout 中的聚类和分类/280
13.4.1 什么是聚类和分类/280
13.4.2 Mahout 中的数据表示/281
13.4.3 将文本转化成向量/282
13.4.4 Mahout 中的聚类、分类算法/283
13.4.5 算法应用实例/288
13.5 Mahout 应用:建立一个推荐引擎/292
13.5.1 推荐引擎简介/292
13.5.2 使用Taste 构建一个简单的推荐引擎/292
13.5.3 简单分布式系统下基于产品的推荐系统简介/294
13.6 小结/297
第14 章 Pig 详解/299
14.1 Pig 简介/300
14.2 Pig 的安装和配置 /300
14.2.1 Pig 的安装条件/300
14.2.2 Pig 的下载、安装和配置/301
14.2.3 Pig 运行模式/301
14.3 Pig Latin 语言/304
14.3.1 Pig Latin 语言简介/304
14.3.2 Pig Latin 的使用/305
14.3.3 Pig Latin 的数据类型/307
14.3.4 Pig Latin 关键字/308
14.4 用户定义函数 /313
14.4.1 编写用户定义函数/313
14.4.2 使用用户定义函数/315
14.5 Pig 实例 /315
14.5.1 Local 模式/316
14.5.2 MapReduce 模式/318
14.6 Pig 进阶/319
14.6.1 数据实例/319
14.6.2 Pig 数据分析/320
14.7 小结/324
第15 章 ZooKeeper 详解/326
15.1 ZooKeeper 简介/327
15.1.1 ZooKeeper 的设计目标/327
15.1.2 数据模型和层次命名空间/328
15.1.3 ZooKeeper 中的节点和临时节点/328
15.1.4 ZooKeeper 的应用/329
15.2 ZooKeeper 的安装和配置/329
15.2.1 在集群上安装ZooKeeper/329
15.2.2 配置ZooKeeper/334
15.2.3 运行ZooKeeper/336
15.3 ZooKeeper 的简单操作/339
15.3.1 使用ZooKeeper 命令的简单操作步骤/339
15.3.2 ZooKeeper API 的简单使用/340
15.4 ZooKeeper 的特性/343
15.4.1 ZooKeeper 的数据模型/343
15.4.2 ZooKeeper 会话及状态/345
15.4.3 ZooKeeper Watches/346
15.4.4 ZooKeeper ACL/346
15.4.5 ZooKeeper 的一致性保证/347
15.5 ZooKeeper 的Leader 选举/348
15.6 ZooKeeper 锁服务/348
15.6.1 ZooKeeper 中的锁机制/349
15.6.2 ZooKeeper 提供的一个写锁的实现/350
15.7 使用ZooKeeper 创建应用程序 /351
15.8 小结/355
第16 章 Avro 详解/356
16.1 Avro 简介/357
16.1.1 模式声明/358
16.1.2 数据序列化/362
16.1.3 数据排列顺序/364
16.1.4 对象容器文件 /365
16.1.5 协议声明/367
16.1.6 协议传输格式/368
16.1.7 模式解析/370
16.2 Avro 的C/C++ 实现/371
16.3 Avro 的Java 实现/382
16.4 GenAvro(Avro IDL)语言/385
16.5 Avro SASL 概述/390
16.6 小结/392
第17 章 Chukwa 详解 /393
17.1 Chukwa 简介/394
17.2 Chukwa 架构/395
17.2.1 客户端(Agent)及其数据模型/395
17.2.2 收集器(Collector)和分离解析器(Demux)/396
17.2.3 HICC/398
17.3 Chukwa 的可靠性/399
17.4 Chukwa 集群搭建/400
17.4.1 基本配置要求/400
17.4.2 安装Chukwa/400
17.5 Chukwa 数据流的处理/407
17.6 Chukwa 与其他监控系统比较/408
17.7 小结/409
第18 章 Hadoop 的常用插件与开发/411
18.1 Hadoop Studio 简介和使用/412
18.1.1 Hadoop Studio 的安装和配置/412
18.1.2 Hadoop Studio 的使用举例/413
18.2 Hadoop Eclipse 简介和使用/419
18.2.1 Hadoop Eclipse 安装和配置/420
18.2.2 Hadoop Eclipse 的使用举例/420
18.2.3 Hadoop Eclipse 插件开发/421
18.3 Hadoop Streaming 简介和使用/422
18.3.1 Hadoop Streaming 的使用举例/426
18.3.2 使用Hadoop Streaming 时常见的问题/428
18.4 Hadoop Libhdfs 简介和使用/430
18.4.1 Hadoop Libhdfs 安装和配置/430
18.4.2 Hadoop Libhdfs API 简介/430
18.4.3 Hadoop Libhdfs 的使用举例/431
18.5 小结/432
 1.gif
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/16502878/viewspace-709569/ ,如需转载,请注明出处,否则将追究法律责任。

