SQL Server 2005技术内幕:查询、调整和优化: 用C#实现SQL查询
前面几篇文章作为自己的读书笔记(SQL Server 2005技术内幕:查询、调整和优化),基本都是书上的内容,没敢放在首页上。现在学习SQL Server都是理论知识,自己有个习惯,一直看理论看下去不容易吸收,所以看到“聚合”这一节决定写写代码,用来加深对SQL Server执行计划的理解。
首先看看我在在SQL Server中是怎么处理连接查询和分组查询的。

 代码
if OBJECT_ID('tableA') is not null
drop table tableA
Create table tableA(
ID int identity primary key,
Name varchar(30)
)
if OBJECT_ID('tableB') is not null
drop table tableB
Create table tableB(
ID int,
summary varchar(30)
)
--插入测试数据
insert into tableA(Name) select 'A' union all select 'B' union all select 'C'
insert into tableB(ID, summary)
select 1, 'test-001' union all
select 1, 'test-002' union all
select 3, 'test-001' union all
select 4, 'test-001'
--左连接查询
select A.ID, A.Name, B.summary from tableA A left join tableB B on(A.ID = B.ID)
--根据ID分组查询
select ID, COUNT(1) number from tableB group by ID
上面一段SQL非常简单,创建了两张表,TableA和TableB,字典非常简单,TableB中ID是TableA的外键,这里没有主动建立外键关系。插入几条测试数据,其中实现左连接和分组查询结果如下:
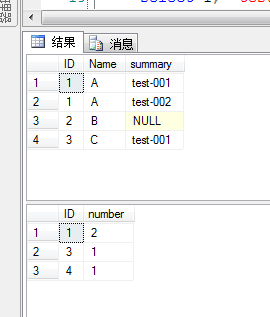
下面我们用C#代码是连接查询和分组功能:
代码
{
public int ID { get; set; }
public Char Name { get; set; }
}
class TableB
{
public int ID { get; set; }
public String summary { get; set; }
}
第一部创建两个实体类与SQL Server中两个实体相对应,然后插入测试数据:
代码
private IList<TableB> tableB = null;
public SQLQuery()
{
tableA = new List<TableA>()
{
new TableA(){ID=1, Name = 'A'},
new TableA(){ID=2, Name = 'B'},
new TableA(){ID=3, Name = 'C'}
};
tableB = new List<TableB>()
{
new TableB(){ID=1, summary = "test-001"},
new TableB(){ID=1, summary = "test-002"},
new TableB(){ID=3, summary = "test-001"},
new TableB(){ID=4, summary = "test-001"},
};
}
实现连接查询的代码如下:
代码
/// 实现SQL中左连接的效果
///
public void JoinQuery()
{
foreach (var item in tableA)
{
foreach (var item2 in tableB)
if (item.ID == item2.ID)
Console.WriteLine("ID: {0}; Name: {1}; Summary: {2}", item.ID, item.Name, item2.summary);
if ((from s in tableB where s.ID == item.ID select s).Count() == 0)
Console.WriteLine("ID: {0}; Name: {1}; Summary: {2}", item.ID, item.Name, null);
}
}
嵌套循环中的两个集合tableA和tableB是数据库中两个表,第二循环中比对连接键,相同则输出,第一个循环中最后的那个if用来检查tableB集合中是存在引用tableA的当前ID,如果没有输出一行有ID,Summary为null的记录,这里是左连接的特例,如果是普通的内连接,这一行可以去掉。
实现分组查询的代码如下:
代码
/// 分组查询
///
public void GroupByQuery()
{
int[] ID = (from s in tableB group tableB by s.ID into groupKey select groupKey.Key).ToArray();
int IDIndex = 0;
int count = 0;
foreach (var item in tableB)
{
if (ID[IDIndex] != item.ID)
{
Console.WriteLine("ID: {0}; Number: {1}", ID[IDIndex], count);
count = 0;
IDIndex++;
if (ID[IDIndex] == item.ID)
count++;
}
else
count++;
}
Console.WriteLine("ID: {0}; Number: {1}", ID[IDIndex], count);
}
这段代码开始对分组键进行去重,这点可以参考我的上篇文章,采用是的流聚合,这里不多加解释。变量IDIndex是用来获取当前ID的索引,Count计算分组情况,也是我们分组查询的目的所在。这里的算法可能有问题,有重复的地方,但功能实现,那位大侠有兴趣可以帮忙改改。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/16436858/viewspace-672876/ ,如需转载,请注明出处,否则将追究法律责任。

