本系列主要讲解kafka基本设计和原理分析,分如下内容:
kafka文件存储机制
topic中partition存储分布
假设实验环境中Kafka集群只有一个broker,xxx/message-folder为数据文件存储根目录,在Kafka broker中server.properties文件配置(参数log.dirs=xxx/message-folder),例如创建topic名称分别为test, partitions数量都为partitions=4,副本为1
存储路径和目录规则为:xxx/logs
test-0
test-1
test-2
test-3
在Kafka文件存储中,同一个topic下有多个不同的partition,每个partiton为一个目录,partition的名称规则为:topic名称+有序序号,第一个序号从0开始计,最大的序号为partition数量减1,partition是实际物理上的概念,而topic是逻辑上的概念。
partition中文件存储方式
下面示意图形象说明了partition中文件存储方式:
- 每个partion(目录)相当于一个巨型文件被平均分配到多个大小相等segment(段)数据文件中。但每个段segment file消息数量不一定相等,这种特性方便old segment file快速被删除。
- 每个partiton只需要支持顺序读写就行了,segment文件生命周期由服务端配置参数决定。
这样做的好处就是能快速删除无用文件,有效提高磁盘利用率。
partition中segment文件存储结构
segment文件由两部分组成,分别为“.index”文件和“.log”文件,分别表示为segment索引文件和数据文件。这两个文件的命令规则为:partition全局的第一个segment从0开始,后续每个segment文件名为上一个segment文件最后一条消息的offset值,数值大小为64位,20位数字字符长度,没有数字用0填充。
下面文件列表是笔者在Kafka broker上做的一个实验,创建一个topicXXX包含1 partition,设置每个segment大小为500MB,并启动producer向Kafka broker写入大量数据,如下图所示segment文件列表形象说明了上述2个规则:
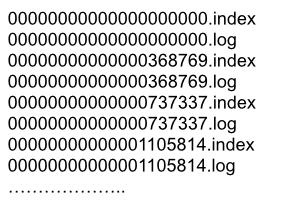
以上述图2一对segment file文件为例,说明segment中index<—->data file对应关系物理结构如下: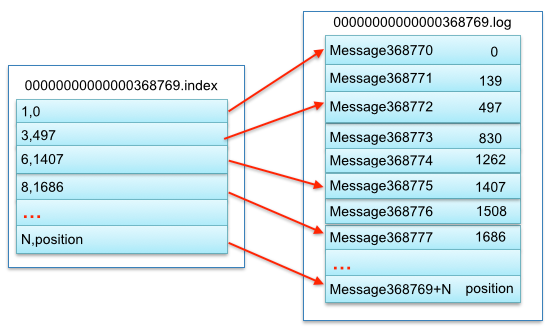
上述图3索引文件存储大量元数据,数据文件存储大量消息,索引文件中元数据指向对应数据文件中message的物理偏移地址。
其中以索引文件中元数据3,497为例,依次在数据文件中表示第3个message(在全局partiton表示第368772个message)、以及该消息的物理偏移地址为497。
从上图了解到segment data file由许多message组成,下面详细说明message物理结构如下:
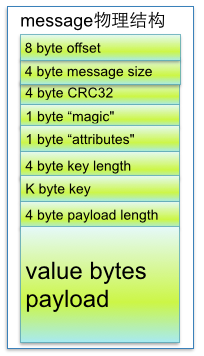
相关字段含义对应如下: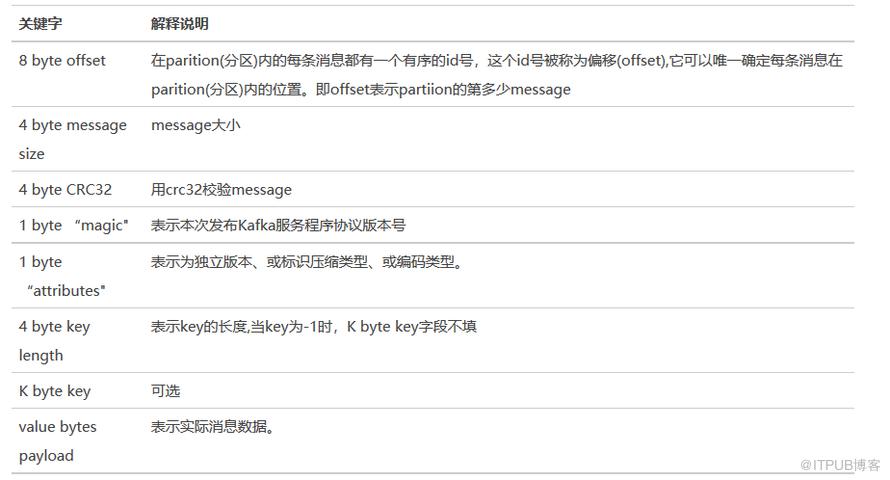
通过offset查找message
例如读取offset=368776的message,需要通过下面2个步骤查找。
-
第一步查找segment file
上图为例,其中00000000000000000000.index表示最开始的文件,起始偏移量(offset)为0.第二个文件00000000000000368769.index的消息量起始偏移量为368770 = 368769 + 1.同样,第三个文件00000000000000737337.index的起始偏移量为737338=737337 + 1,其他后续文件依次类推,以起始偏移量命名并排序这些文件,只要根据offset二分查找文件列表,就可以快速定位到具体文件。
当offset=368776时定位到00000000000000368769.index|log -
第二步通过segment file查找message
通过第一步定位到segment file,当offset=368776时,依次定位到00000000000000368769.index的元数据物理位置和00000000000000368769.log的物理偏移地址,然后再通过00000000000000368769.log顺序查找直到offset=368776为止。
从上图可知这样做的优点,segment index file采取稀疏索引存储方式,它减少索引文件大小,通过mmap可以直接内存操作,稀疏索引为数据文件的每个对应message设置一个元数据指针,它比稠密索引节省了更多的存储空间,但查找起来需要消耗更多的时间。
Kafka高效文件存储设计特点
- Kafka把topic中一个parition大文件分成多个小文件段,通过多个小文件段,就容易定期清除或删除已经消费完文件,减少磁盘占用。
- 通过索引信息可以快速定位message和确定response的最大大小。
- 通过index元数据全部映射到memory,可以避免segment file的IO磁盘操作。
- 通过索引文件稀疏存储,可以大幅降低index文件元数据占用空间大小。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/1567/viewspace-2822789/ ,如需转载,请注明出处,否则将追究法律责任。

