1.top
linux 常用的性能分析工具,能够实时显示系统各个进程的资源使用情况。
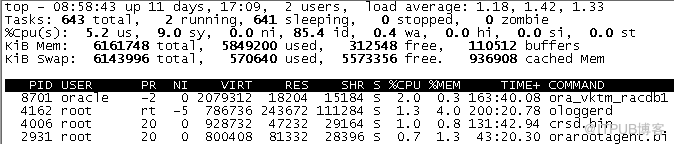
第一行
top - 系统时间
up - 系统运行时间
users - 目前登录用户
load average - 系统1,5,15 分钟的平均负载(该数值除以CPU逻辑core数如果>5 则表示系统负载过高)
第二行
总进程:159 total, 运行:1 running, 休眠:157 sleeping, 停止: 1 stopped, 僵尸进程: 0 zombie
第三行
cpu 状态信息
us - 用户占用cpu百分比
sy - 内核占用cpu百分比
ni - 改变过优先级的进程占用cpu百分比
id - 空闲cpu百分比
wa - io等待占用cpu百分比
hi - 硬中断占用cpu百分比
si - 软中断占用cpu百分比
第四行
memory状态信息
第五行
swap交换区信息
备注:
可用内存=free + buffer + cached
对于内存监控,在top里我们要时刻监控第五行swap交换分区的used,如果这个数值在不断的变化,说明内核在不断进行内存和swap的数据交换,这是真正的内存不够用了。
第四行中使用中的内存总量(used)指的是现在系统内核控制的内存数,
第四行中空闲内存总量(free)是内核还未纳入其管控范围的数量。
纳入内核管理的内存不见得都在使用中,还包括过去使用过的现在可以被重复利用的内存,内核并不把这些可被重新使用的内存交还到free中去,因此在linux上free内存会越来越少,但不用为此担心。
第六行
各进程状态
PID — 进程id
USER — 进程所有者
PR — 进程优先级
NI — nice值。负值表示高优先级,正值表示低优先级
VIRT — 进程使用的虚拟内存总量,单位kb。VIRT=SWAP+RES
RES — 进程使用的、未被换出的物理内存大小,单位kb。RES=CODE+DATA
SHR — 共享内存大小,单位kb
S —进程状态。D=不可中断的睡眠状态 R=运行 S=睡眠 T=跟踪/停止 Z=僵尸进程
%CPU — 上次更新到现在的CPU时间占用百分比
%MEM — 进程使用的物理内存百分比
TIME+ — 进程使用的CPU时间总计,单位1/100秒
COMMAND — 进程名称(命令名/命令行)
其他交互命令
- 按1键,显示每个逻辑CPU
- x 打开排序列加亮,shift + < or > 改变排序列
- h 显示帮助画面,给出一些简短的命令总结说明
- k 终止一个进程。
- i 忽略闲置和僵死进程。这是一个开关式命令。
- q 退出程序
- r 重新安排一个进程的优先级别
- S 切换到累计模式
- s 改变两次刷新之间的延迟时间(单位为s
- f或者F 从当前显示中添加或者删除项目
- o或者O 改变显示项目的顺序
- l 切换显示平均负载和启动时间信息
- m 切换显示内存信息
- t 切换显示进程和CPU状态信息
- c 切换显示命令名称和完整命令行
- M 根据驻留内存大小进行排序
- P 根据CPU使用百分比大小进行排序
- T 根据时间/累计时间进行排序
- W 将当前设置写入~/.toprc文件中
2.sar
系统性能分析工具,可以从多方面进行报告。
(1).CPU
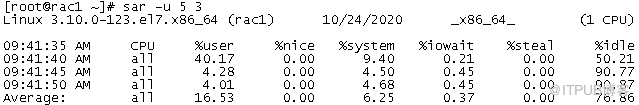
输出项说明:
CPU:all 表示统计信息为所有 CPU 的平均值。
%user:显示在用户级别(application)运行使用 CPU 总时间的百分比。
%nice:显示在用户级别,用于nice操作,所占用 CPU 总时间的百分比。
%system:在核心级别(kernel)运行所使用 CPU 总时间的百分比。
%iowait:显示用于等待I/O操作占用 CPU 总时间的百分比。
%steal:管理程序(hypervisor)为另一个虚拟进程提供服务而等待虚拟 CPU 的百分比。
%idle:显示 CPU 空闲时间占用 CPU 总时间的百分比。
1. 若 %iowait 的值过高,表示硬盘存在I/O瓶颈
2. 若 %idle 的值高但系统响应慢时,有可能是 CPU 等待分配内存,此时应加大内存容量
3. 若 %idle 的值持续低于1,则系统的 CPU 处理能力相对较低,表明系统中最需要解决的资源是 CPU 。
(2).MEM 和 SWAP
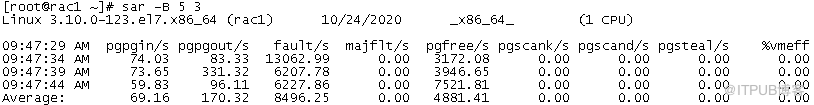
输出项说明:
pgpgin/s:表示每秒从磁盘或SWAP置换到内存的字节数(KB)
pgpgout/s:表示每秒从内存置换到磁盘或SWAP的字节数(KB)
fault/s:每秒钟系统产生的缺页数,即主缺页与次缺页之和(major + minor)
majflt/s:每秒钟产生的主缺页数.
pgfree/s:每秒被放入空闲队列中的页个数
pgscank/s:每秒被kswapd扫描的页个数
pgscand/s:每秒直接被扫描的页个数
pgsteal/s:每秒钟从cache中被清除来满足内存需要的页个数
%vmeff:每秒清除的页(pgsteal)占总扫描页(pgscank+pgscand)的百分比
(3).IO
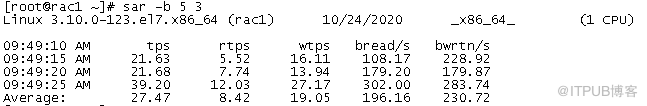
输出项说明:
tps:每秒钟物理设备的 I/O 传输总量
rtps:每秒钟从物理设备读入的数据总量
wtps:每秒钟向物理设备写入的数据总量
bread/s:每秒钟从物理设备读入的数据量,单位为 块/s
bwrtn/s:每秒钟向物理设备写入的数据量,单位为 块/s
(4).进程队列
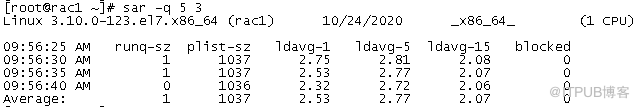
输出项说明:
runq-sz:运行队列的长度(等待运行的进程数)
plist-sz:进程列表中进程(processes)和线程(threads)的数量
ldavg-1:最后1分钟的系统平均负载(System load average)
ldavg-5:过去5分钟的系统平均负载
ldavg-15:过去15分钟的系统平均负载
(5).系统交换活动
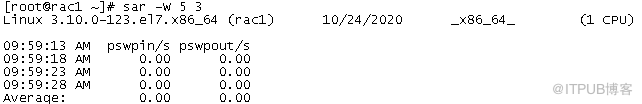
输出项说明:
pswpin/s:每秒系统换入的交换页面(swap page)数量
pswpout/s:每秒系统换出的交换页面(swap page)数量
(6).设备使用
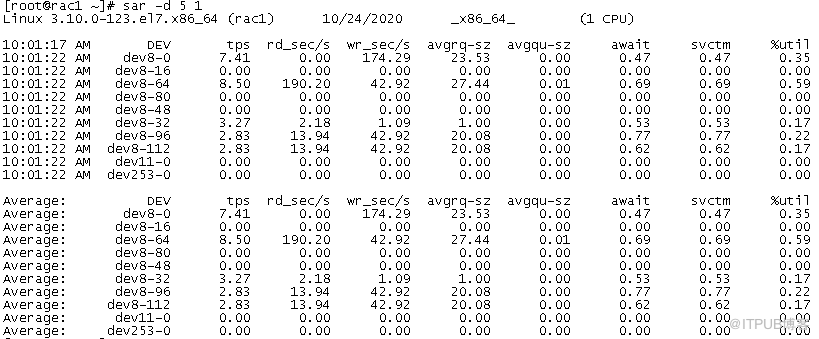
其中:
参数-p可以打印出sda,hdc等磁盘设备名称,如果不用参数-p,设备节点则有可能是dev8-0,dev22-0
tps:每秒从物理磁盘I/O的次数.多个逻辑请求会被合并为一个I/O磁盘请求,一次传输的大小是不确定的.
rd_sec/s:每秒读扇区的次数.
wr_sec/s:每秒写扇区的次数.
avgrq-sz:平均每次设备I/O操作的数据大小(扇区).
avgqu-sz:磁盘请求队列的平均长度.
await:从请求磁盘操作到系统完成处理,每次请求的平均消耗时间,包括请求队列等待时间,单位是毫秒(1秒=1000毫秒).
svctm:系统处理每次请求的平均时间,不包括在请求队列中消耗的时间.
%util:I/O请求占CPU的百分比,比率越大,说明越饱和.
1. avgqu-sz 的值较低时,设备的利用率较高。
2. 当%util的值接近 1% 时,表示设备带宽已经占满。
备注:
怀疑CPU存在瓶颈,可用 sar -u 和 sar -q 等来查看
怀疑内存存在瓶颈,可用 sar -B、sar -r 和 sar -W 等来查看
怀疑I/O存在瓶颈,可用 sar -b、sar -u 和 sar -d 等来查看
3.netstat
在内核中访问网络及相关信息的程序,它能提供TCP连接,TCP和UDP监听,进程内存管理的相关报告。
(1).显示网卡列表
# netstat -i
Kernel Interface table
Iface      MTU    RX-OK RX-ERR RX-DRP RX-OVR    TX-OK TX-ERR TX-DRP TX-OVR Flg
eno16777  1500 11722397      0      1 0      16984562      0      0      0 BMRU
eno16777  1500      - no statistics available -                        BMRU
eno33554  1500 105293544      0      1 0      95628133      0      0      0 BMRU
eno33554  1500      - no statistics available -                        BMRU
lo       65536 18388496      0      0 0      18388496      0      0      0 LRU
virbr0    1500        0      0      0 0             0      0      0      0 BMU
(2). netstat -lntup
# netstat -lntup
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address           Foreign Address         State       PID/Program name
tcp        0      0 127.0.0.1:25            0.0.0.0:*               LISTEN      1669/master
tcp        0      0 169.254.176.93:61020    0.0.0.0:*               LISTEN      3953/osysmond.bin
tcp        0      0 169.254.176.93:61021    0.0.0.0:*               LISTEN      4162/ologgerd
tcp        0      0 0.0.0.0:32159           0.0.0.0:*               LISTEN      3062/gpnpd.bin
tcp        0      0 127.0.0.1:2016          0.0.0.0:*               LISTEN      3014/oraagent.bin
tcp        0      0 0.0.0.0:2049            0.0.0.0:*               LISTEN      -
tcp        0      0 0.0.0.0:27586           0.0.0.0:*               LISTEN      -
tcp        0      0 0.0.0.0:875             0.0.0.0:*               LISTEN      3418/rpc.rquotad
tcp        0      0 0.0.0.0:111             0.0.0.0:*               LISTEN      1429/rpcbind
tcp        0      0 0.0.0.0:20048           0.0.0.0:*               LISTEN      3372/rpc.mountd
tcp        0      0 109.115.12.36:1521      0.0.0.0:*               LISTEN      5574/tnslsnr
tcp        0      0 109.115.12.34:1521      0.0.0.0:*               LISTEN      5574/tnslsnr
tcp        0      0 127.0.0.1:6100          0.0.0.0:*               LISTEN      5313/ons
tcp        0      0 192.168.122.1:53        0.0.0.0:*               LISTEN      1828/dnsmasq
tcp        0      0 192.168.11.11:1526      0.0.0.0:*               LISTEN      5369/tnslsnr
tcp        0      0 0.0.0.0:22              0.0.0.0:*               LISTEN      1436/sshd
tcp        0      0 169.254.176.93:41336    0.0.0.0:*               LISTEN      5574/tnslsnr
tcp        0      0 0.0.0.0:43928           0.0.0.0:*               LISTEN      1458/rpc.statd
tcp6       0      0 ::1:25                  :::*                    LISTEN      1669/master
tcp6       0      0 ::1:2016                :::*                    LISTEN      3014/oraagent.bin
tcp6       0      0 :::2049                 :::*                    LISTEN      -
tcp6       0      0 :::61415                :::*                    LISTEN      -
tcp6       0      0 :::11215                :::*                    LISTEN      1458/rpc.statd
tcp6       0      0 :::111                  :::*                    LISTEN      1429/rpcbind
tcp6       0      0 :::20048                :::*                    LISTEN      3372/rpc.mountd
tcp6       0      0 ::1:6100                :::*                    LISTEN      5313/ons
tcp6       0      0 :::55829                :::*                    LISTEN      8876/ora_d000_racdb
tcp6       0      0 :::21                   :::*                    LISTEN      1426/vsftpd
tcp6       0      0 :::22                   :::*                    LISTEN      1436/sshd
tcp6       0      0 :::6200                 :::*                    LISTEN      5313/ons
udp        0      0 169.254.176.93:55258    0.0.0.0:*                           9319/ora_q004_racdb
udp        0      0 169.254.176.93:38891    0.0.0.0:*                           6449/asm_pxmn_+ASM1
udp        0      0 192.168.11.11:59372     0.0.0.0:*                           3042/evmd.bin
udp        0      0 169.254.176.93:22516    0.0.0.0:*                           8781/ora_lms0_racdb
udp        0      0 169.254.176.93:22527    0.0.0.0:*                           6360/asm_mman_+ASM1
(3).找出程序运行端口
# netstat -anp | grep ssh
tcp        0      0 0.0.0.0:22              0.0.0.0:*               LISTEN      1436/sshd
tcp        0      0 109.115.12.34:22        109.115.16.186:51401    ESTABLISHED 119821/sshd: root@p
tcp6       0      0 :::22                   :::*                    LISTEN      1436/sshd
unix  3      [ ]         STREAM     CONNECTED     24153    1436/sshd
unix  2      [ ]         DGRAM                    28257165 119821/sshd: root@p
(4).其他常用命令
按oracleSID来查询连接数据库的客户端IP
netstat -anpT | grep oracleSID | awk '{print $5}' | grep -o -E  '1.*:' | awk -F ':' '{print $1}' | sort
按监听端口1521来查询连接数据库的客户端IP
netstat -anpT | grep 1521 | awk '{print $5}' | grep -o -E  '1.*:' | awk -F ':' '{print $1}' | sort
查询连接1521端口的process进程数
netstat -pan |grep 1521 |wc -l
查询来自某台服务器192.168.21.15的连接的process进程数
netstat -pan |grep  192.168.21.15 |wc -l
汇总连接1521端口的每个客户端IP的连接数
netstat -apnT|grep 1521 |awk  '{print $5}'|sort -u |grep -v 1521 |grep -v '*' |awk -F ':'  '{print $4}'|uniq -c |sort -nr
netstat -anpT|grep 1521 |awk  '{print $5}'|grep -o -E  '1.*:' |awk -F ':' '{print $1}' | sort |uniq -c |sort -nr
4.ps
基本进程查看命令
CPU占用最多的前10个进程:
ps auxw|head -1;ps auxw|sort -rn -k3|head -10
内存消耗最多的前10个进程
ps auxw|head -1;ps auxw|sort -rn -k4|head -10
虚拟内存使用最多的前10个进程
ps auxw|head -1;ps auxw|sort -rn -k5|head -10
5.vmstat
用来获得有关进程、虚存、页面交换空间及 CPU活动的信息。这些信息反映了系统的负载情况.
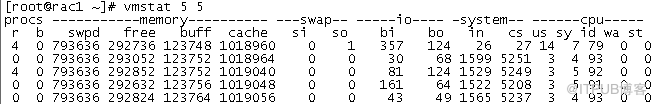
Procs(进程):
r: 运行队列中进程数量
b: 等待IO的进程数量
Memory(内存):
swpd: 使用虚拟内存大小
free: 可用内存大小
buff: 用作缓冲的内存大小
cache: 用作缓存的内存大小
Swap:
si: 每秒从交换区写到内存的大小
so: 每秒写入交换区的内存大小
IO:(现在的Linux版本块的大小为1024bytes)
bi: 每秒读取的块数
bo: 每秒写入的块数
系统:
in: 每秒中断数,包括时钟中断。【interrupt】
cs: 每秒上下文切换数。 【count/second】
CPU(以百分比表示):
us: 用户进程执行时间(user time)
sy: 系统进程执行时间(system time)
id: 空闲时间(包括IO等待时间),中央处理器的空闲时间 。以百分比表示。
wa: 等待IO时间
备注:
如果r经常大于4,id经常少于40,表示cpu的负荷很重。
如果bi,bo长期不等于0,表示内存不足。
如果disk经常不等于0,且在b中的队列大于3,表示io性能不好。
未完待续...
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/15412087/viewspace-2729320/ ,如需转载,请注明出处,否则将追究法律责任。

