摘要:为了解决现阶段大数据存算分离痛点问题,华为云大数据推出重量级数据湖Catalog服务。
1 背景
随着5G、IoT等技术的发展,企业积累了越来越多的数据,需要激发更多的数据价值变现。传统大数据平台从建设到落地的长周期,不利于业务的高速发展;平台建成后,维护、升级、扩容均以集群为单位,管理离散,操作繁重。
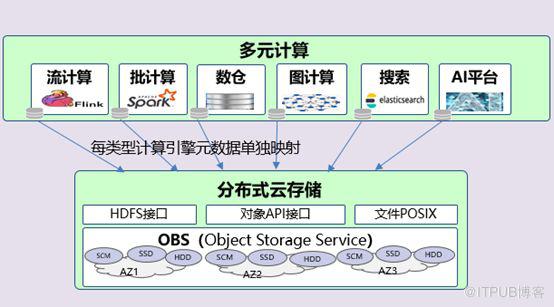
众多用户采用了华为云大数据存算分离方案,存算分离解决方案指的是业务数据分离,共享的是数据,元数据不共享,每类引擎单独映射构建。也正因为元数据不共享,导致现阶段大数据存算分离方案存在如下几点痛点:
- 缺少统一管理视图:元数据分散,难于统一管理;
- 缺少统一的细粒度权限管理:缺少统一的对数据库、表、列的权限控制,缺少有效的逻辑及权限隔离;
- 计算资源无法快速扩缩容:计算集群需要考虑元数据的备份和恢复,增加资源成本和运维成本;
2 数据湖Catalog简介
为了解决现阶段大数据存算分离痛点问题,华为云大数据推出重量级数据湖Catalog服务。
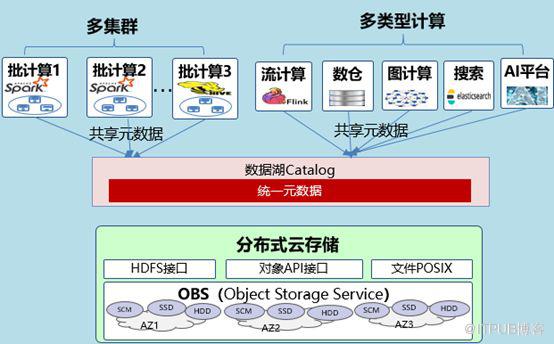
数据湖Catalog是面向多元计算引擎提供统一元数据服务。支持多元计算统一并共享元数据,实现引擎级元数据分离,全湖一张视图,支持业务灵活访问,助力存算分离架构升级变迁。数据湖Catalog主要有如下五点关键特性:
- 存算分离更专业、简化;
- 支持多引擎、多集群,灵活易用,性能更高;
- 多维度可靠性保驾护航;
- 细粒度权限管控,访问共享更安全;
- 支持元数据多版本以及DAG跟踪和分析;
经过数据湖Catalog加持后,在原有业务数据分离的基础上,实现引擎级元数据分离,主要有如下三大优势:
- 统一元数据管理,全湖统一数据资产视图,多引擎统一可视;
- 元数据多引擎共享,数据无需单独映射,软件多版本自由选择;
- 可靠性:计算与数据完全解耦,集群故障,数据可靠,元数据可靠;
3 数据湖Catalog关键特性
下面主要介绍数据湖Catalog五大关键特性。
3.1 存算分离更专业、简化
传统存算分离解决方案一般指的是业务数据分离,共享的是数据,元数据不共享,每类引擎单独映射构建。而数据湖Catalog通过统一多集群、多类型计算的元数据管理,实现全湖统一数据资产视图,多引擎统一可视,数据无需单独映射,多引擎多版本自由选择。
- 数据湖Catalog独立部署,MRS集群释放不会清理元数据,元数据无需备份和迁移,节约运维管理成本,随用随释放;
- MRS集群可以做不同的业务,所有集群都可以很方便的实现数据共享和数据访问;
- MRS集群可以真正聚焦业务,根据业务需要进行集群的创建和释放,真正的可以做到按需创建、用完即释放,节约资源和运维成本。
3.2 支持多引擎、多集群,灵活易用,性能更高
传统大数据大多以MetaStore进行元数据管理,以thrift api方式对外提供元数据管理能力,且仅针对Hive生态相关元数据。而数据湖Catalog提供兼容Hive MetaStore API和RESTfull API,支持结构化、非结构化数据源以结构化的模型进行元数据管理助力高层次的协作。
- 兼容Hive MetaStore API,支持Hive生态诸如Hive/Spark/Presto/Impala/Flink等引擎,可以通过简单的配置即可快速实现数据湖Catalog对接集成;
- 支持华为云其他云服务以开放RESTfull API的方式进行对接集成;
- 基于MetaStore内核自底向上逐层优化,性能更高,某客户场景下性能较开源提升3-5倍;
3.3 多维度可靠性保驾护航
随着业务快速增长,数据湖Catalog提供了多维度可靠性增强能力,快速满足客户业务增长的诉求,为客户保驾护航。
- 支持跨AZ容灾部署、节点故障容错、特性级故障发现和自愈,为用户提供了高可用部署架构,极大提升业务的可靠性;
- 支持动态流控、静态流控、服务降级、接口级熔断,保障业务平滑应对业务激增;
- 支持公共服务依赖故障放通,当周边服务异常时,最大程度保证业务连续性;
- 支持丰富的集群监控和告警能力,实时发现系统异常,保障业务稳定运行;
3.4 细粒度权限管控,访问共享更安全
数据湖Catalog基于华为云IAM实现细粒度权限管控,将元数据作为资源进行统一权限管理。各云服务必须相应的权限才可以访问数据湖Catalog,例如表或分区。
- 支持基于角色的访问策略,数据湖Catalog对所有元数据的操作均支持基于角色的IAM策略。通过讲策略附加到账户中的用户或组,可向其授予数据湖Catalog中创建、访问或修改数据湖Catalog资源(例如表、分区)的权限。通过将策略附加到IAM角色,用户可以向其他华为云账户中的IAM角色授予跨账户访问权限;
- 支持使用资源策略控制对数据湖Catalog资源的访问,这些资源包括数据库、表、分区和用户定义的函数,以及与这些资源交互的APIs;
- 支持基于角色或资源的访问策略跨账户授予访问权限,实现多账号间元数据的共享和访问控制。
3.5 支持元数据多版本以及DAG跟踪和分析
在经典机器学习场景和深度学习场景下,数据类型、数据版本、工程(模型、脚本等)随时间变化,难以复用,难以监管。数据湖Catalog提供元数据多版本能力,让AI数据开发项目如同GIT管理代码一样管理涉及到的数据和工程模型、脚本。与此同时,数据湖Catalog提供DAG跟踪和分析能力,可以帮助AI数据开发按照时间线、流水线查看不同时期、不同阶段的模型指标以及上下游信息。数据湖Catalog可以帮助极大提升AI数据开发的效率。
4 典型应用场景
4.1 基于MRS构建企业级数据湖大数据处理分析平台
用户基于华为云MapReduce服务构建自己的数据湖数据处理分析平台,随着企业快速发展,集群规模和数据也急剧膨胀,用户迫切需要完全解耦计算和数据,让计算资源可以按需使用,集中统一管理不同存储中的元数据。
数据湖Catalog价值
- 多MRS集群元数据统一管理,避免数据孤岛;
- 自底向上逐层优化,性能更高;
- 多维度可靠性保驾护航,更可靠;
- 支持细粒度权限管控,更安全;
4.2 基于ModelArts构建数据湖AI开发平台
大数据是AI的基础,AI也是大数据的未来。数据湖可以很好的在经典机器学习场景和深度学习场景下服务用户:经验和数据靠个人、无管理;难以复用,难以监管;数据类型多,不同团队用的工具不同,随时间变化;无数据版本和分支管理;缺乏数据回流机制,需要数据湖具备能够统一“表”、“数据集”等概念,形成高层次的协作,需要数据湖具备能够实现元数据统一并借此进行数据版本和分支管理。
数据湖Catalog价值
- 提供多引擎SDK和REST API,方便用户集成;
- 支持多版本管理,包括数据版本、分支、事务等;
- 支持AI和大数据DAG血缘跟踪和分析;
- 统一元数据模型,助力异构数据源统一数据服务;
5 总结
数据湖Catalog极大增强MRS服务存算分离方面的能力,让MRS更聚焦算力,真正能按需创建、用完即释放,为用户节约了资源成本和运维管理成本;同时对ModelArts构建数据湖AI开发平台提供企业级经验和数据复用、异构数据源统一访问、多版本管理和DAG血缘管理提供了坚实的元数据管理基础。对于用户构建企业级数据湖大数据处理分析平台和数据湖AI开发平台,数据湖Catalog将会成为用户统一元数据管理平台首选。
同时作为一款新的重量级统一元数据管理服务,我们在引擎元数据领域还在持续学习和探索过程中,数据湖Catalog后面会持续从性能优化、可靠性、生态建设、数据价值挖掘多个角度进行优化和改进,包括统计分析、CBO以及扩展应用、AI融合高级特性等。
本文分享自华为云社区《统一元数据,华为云MRS 数据湖Catalog重磅推出!》,原文作者:ryanlunar。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/1536/viewspace-2796130/ ,如需转载,请注明出处,否则将追究法律责任。

