从第三关开始真的是越来越难了。前面三关顺利的话,我们就可以来到第四关了,第四关地址:http://www.heibanke.com/lesson/crawler_ex03/。
本关的难点是从页面解析并拼接出需要的目标密码,理解题目很重要啊~
另外获取密码的页面加载耗时很长,也需要考虑如何处理。
解题思路首次进入题目页面,同样的跳转到了登录页面:
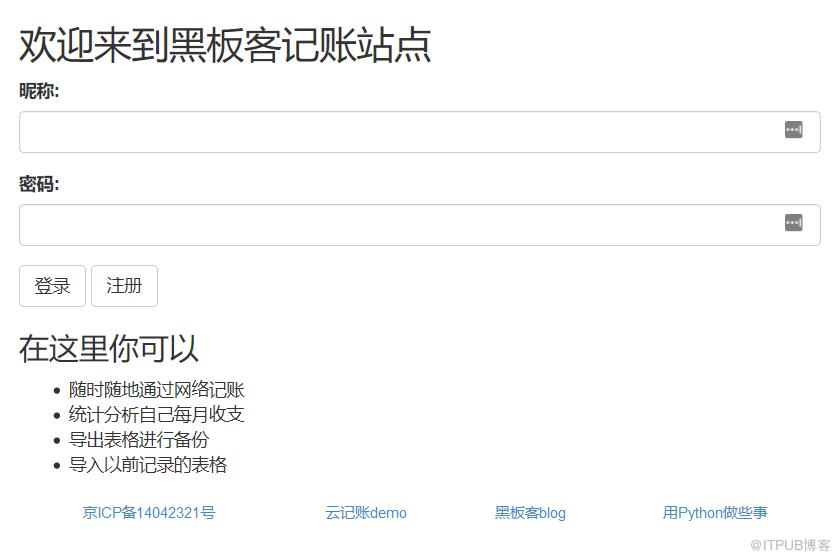
登录成功后,出现如下页面,发现还是猜密码。

但这次提示密码不是试出来的,而是需要找出来,那从哪里找呢?
我们就按前面几关的惯例随便输入个数字试下吧:

提示密码错误,同时给出了下一步操作的提示,一个找密码的页面,继续访问该页面:

初步观察,页面的表格中有两列,其中一列是密码的位置(还是随机的),另外一列是密码的值。
猜测是将密码的值拼接成一个字符串,但是页面只有 13 页,每页 8 个数值,正好 100 个数,而位置数最大的出现了 100,将这 100 个数放入到 dict(location,value) 里,然后再对 dict 的 key 进行排序,然后再对 value 进行拼接,不就得到密码了嘛。
然而现实是残酷的,仔细观察后发现密码的位置中存在重复,也就是遍历完 13 页数据,并不能得到所有的密码值,然后我就猜想是不是对没有出现在页面的位置进行填充 0处理,发现还是失败......
在多次试验中,发现每次获取到的密码的位置并不是相同的,也就是页面里的随机的意思。
就是需要我们不断的调用查询密码列表页面,一直到密码的位置能够填充 0-100 这些个 key 为止,然后就能够获取到所有密码的值了。
# coding=utf-8

import requests, bs4

# 题目URL
url = 'http://www.heibanke.com/lesson/crawler_ex03/'

# 登录URL,获取cookie
login_url = 'http://www.heibanke.com/accounts/login/?next=/lesson/crawler_ex03/'

# 获取密码URL
pwd_url = 'http://www.heibanke.com/lesson/crawler_ex03/pw_list/'

login_data = {'username':'liuhaha', 'password':'123456'}

# 获取默认cookie
response = requests.get(url)
if response.status_code == 200:
    print('Welcome')
cookies = response.cookies

# 登录
login_data['csrfmiddlewaretoken'] = cookies['csrftoken']
login_response = requests.post(login_url, allow_redirects=False, data=login_data, cookies=cookies)
if login_response.status_code == 200:
    print('login sucessfully')

# 获取登录成功后的cookie
cookies = login_response.cookies

payload = {}
pwd_data = {}
i = 0
# 通过观察,密码应该有100个数字组成。
# 由于每次获取到的密码会有重复,所以不是一次查询完就能获取到所有数字
# 这里一直进行查询,直到获取到100个数字
while len(pwd_data)
最终执行了 62 次后获取到了全部密码。

我觉得第四关的难点在于题意的理解。另外还有一个坑需要填。
经过上面的程序,我们可以发现执行过程比较漫长,另外页面也有提示说:网页会慢半拍,实验证明运行一次用时差不多 1400s,将近 24 分钟啊!
那么也许需要一个高效率的方法进行解析,多线程?
且看下回分解。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/1470/viewspace-2812246/ ,如需转载,请注明出处,否则将追究法律责任。

