存储大师班 | ZFS存储池块管理与事务模型
作者简介:肖文文,QingStor 文件存储开发工程师,主要负责文件存储的开发,有多年的存储开发经验,喜爱技术热爱技术。
ZFS History
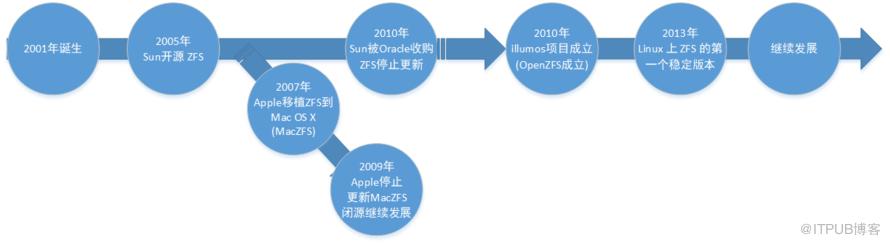
1 ZFS 的诞生:ZFS 由 Sun 存储部门的 CTO 、研究员 Jeff Bonwick 带领团队开发。开发于 2001 年,作为 Sun Microsystems Solaris 操作系统的一部分。
- 带领开发 ZFS 的是 Jeff Bonwick。他首先有了对 ZFS 整体架构的构思,然后游说 Sun 高层,亲自组建起了 ZFS 开发团队。
- 招募了当时刚从大学毕业的 Matt Ahrens,又从 Solaris 的 Storage Team 抽调了 UFS 部分的负责人 Mark Shellenbaum 和 Mark Maybee 来开发 ZFS。
2 ZFS 的开源:在2005年,Sun 开源 Solaris 的大部分,包括 ZFS 开源;开源项目 OpenSolaris。
3 illumos 项目成立,OpenZFS:
- 在2010年,Sun 被 Oracle 收购,ZFS 成为 Oracle 的注册商标。Oracle 停止为 OpenSolaris 和 ZFS 项目提供更新的源代码,三分之二的 ZFS 核心开发者决定离开 Oracle 公司。
- illumos 项目的成立,维护已经存在的开源的 Solaris 代码,并且在 2013 年成立 OpenZFS 以配合 ZFS 开源的发展。
4 ZFS on Linux:2013年,Linux 上 ZFS 的第一个稳定版本,继续发展。
ZFS Overview
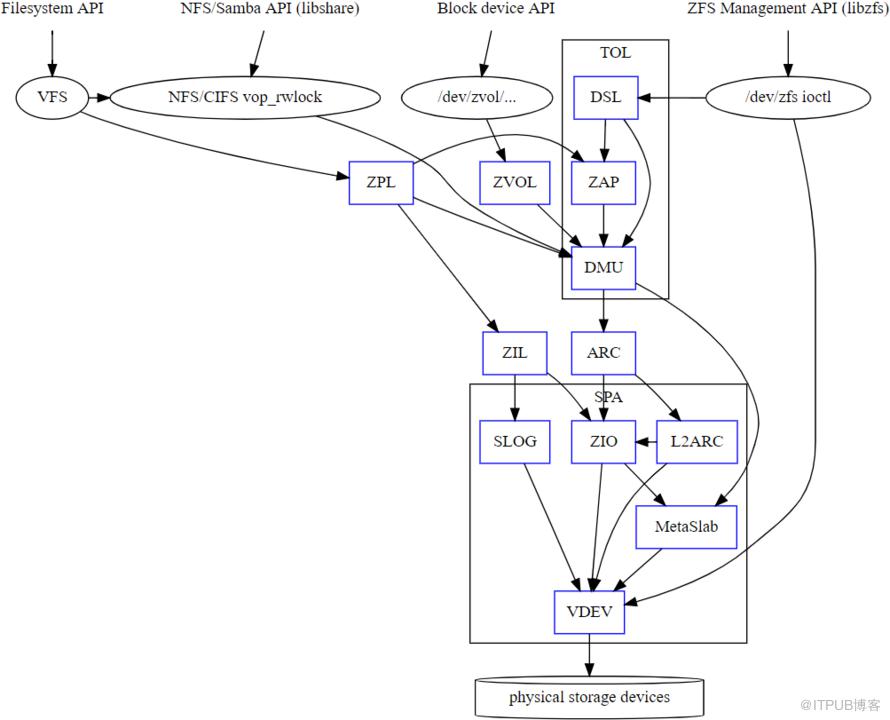
ZFS(Zettabyte File System)是一个跨时代的文件系统,被称为最后一个单机文件系统,已经被证实可以移植到多种 OS 平台上。它拥有如下特性:
1 完全兼容 posix 语义(ZPL: ZFS POSIX Layer)。
2 提供逻辑卷功能(ZVOL: ZFS Volumes)。
3 提交完善的管理功能:通过 libzfs 的工具,经过 ioctl 发送管理命令到zfs kernel module。
4 提供接近无限的存储空间:将物理存储设备进行池化管理,文件系统建立在设备存储池上。当文件系统空间不够,可以将物理设备动态添加存储池中。存储池上的单个文件系统极限值:
- 支持 2^{48} 个快照。
- 支持 2^{48} 个文件。
- 单个文件最大 16EB。
5 事务模型 + COW: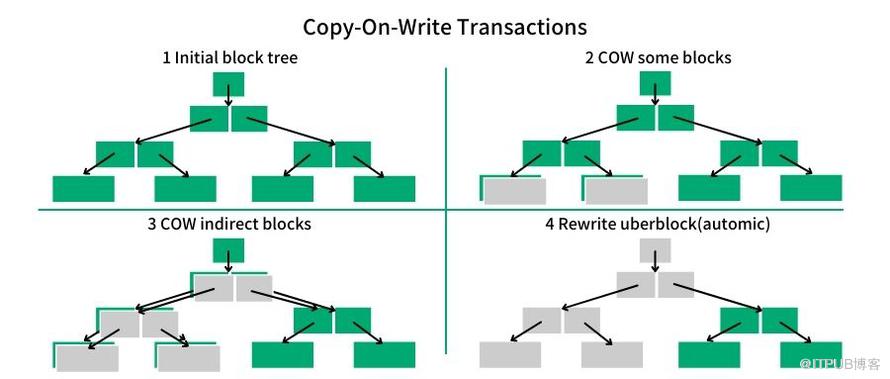
事务模型和 COW 是强绑定的关系。
- COW(Copy On Write):对文件的数据不是原地直接修改,而是拷贝更新的方式,数据块的内容更新不存在中间状态。
- 事务:保证了对文件的一组操作都是原子性的,并且每个事务之间是相互独立的。所有文件的同一个事务 ID 的集合打包成一个事务组,进行从 file 到 root 的全局的拓扑的更新。
- 事务 TX 和事务组 TXG 的关系(在事务模型章节详细介绍):
- XG:在同一个事务 ID(TXG-num)下的 TX 构成一个事务组 TXG
- 当一个 TXG 中的被需要改的数据达到一个阈值(脏数据阈值),或者周期到了,发生一次事务组的轮转,在这个事务组的 sync 结束之后,生成一个全新的 root 的拓扑树(layout)。
6 端到端的数据安全性: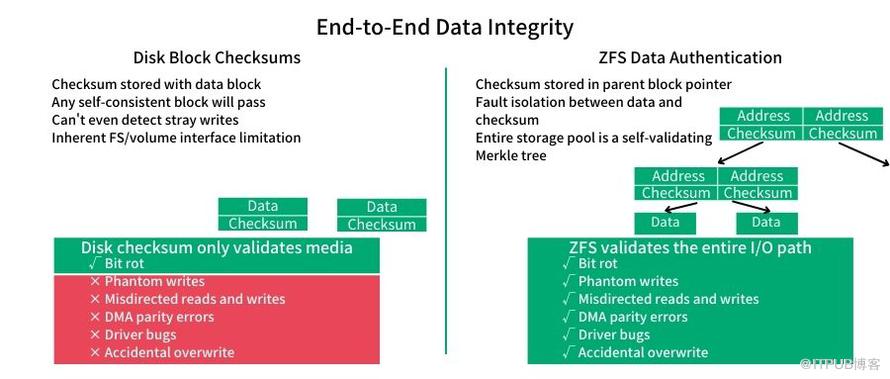
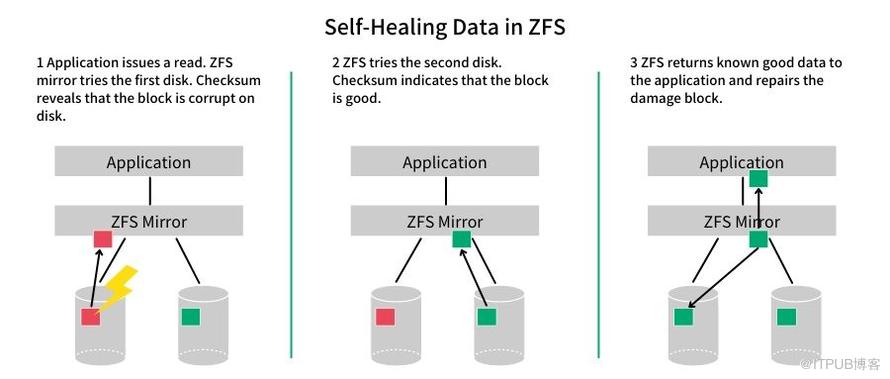
- 256 位的 Checksum,Checksum 的数据存储在父亲节点上。
- 形成一棵自验证的 Merkle Tree, 当 ZFS 在 load 数据时会进行校验。
- 它在负责读取数据的时候会自动和 256 位校验码进行校验,会主动发现这种 Silent Data Corruption:
- 通过相应的 Mirror 硬盘或者通过 RAID-Z 阵列中其他硬盘得到正确的数据返回给上层应用,并且同时自动修复原硬盘的 Corruption Data。
- 数据恢复也可以给通过读取有效副本的方式进行修复:比如像 ZFS 的 spacemap 数据会存储多份。
7 支持快照和克隆
- 由于 ZFS 采用的 COW 机制,每次的更新 new 数据均不会破坏磁盘上已有的 old 数据。
- ZFS 可以根据需要保留old 数据。
- 这是实现快照功能的基础,实际的快照功能实现是选择一个 TXG-num 作为快照点,将 old root 下拓扑的保存起来,不去释放被更新的数据块地址。
- 当然实际的快照功能要复杂的多,这里不做赘述。
8 支持数据去重功能
9 支持数据压缩功能
存储池
存储池 + 块管理
大多数单机文件系统是物理设备强绑定的,一旦在某个物理设备上格式化文件系统之后,该文件系统的可用空间和物理设备大小息息相关。但是 ZFS 将实际的物理设备和文件系统进行隔离,文件系统是建立在存储池上,存储池上的文件系统共用存储池的物理空间,同时可以动态添加物理设备到存储池中,以增加存储池的可用空间。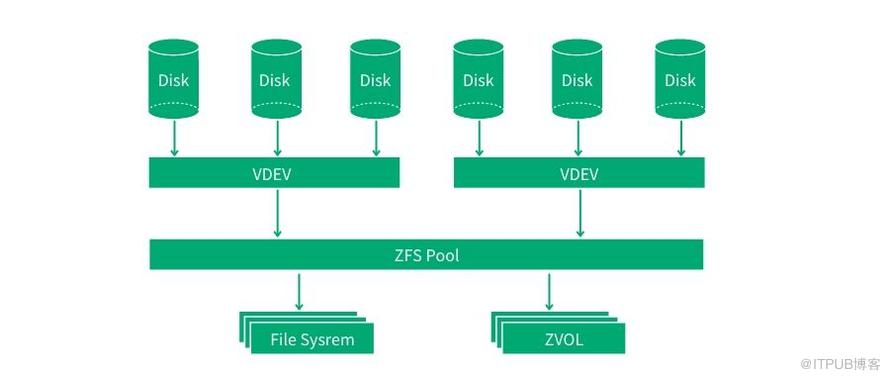
存储池中的设备管理是一种树形结构进行管理的,如下图所示: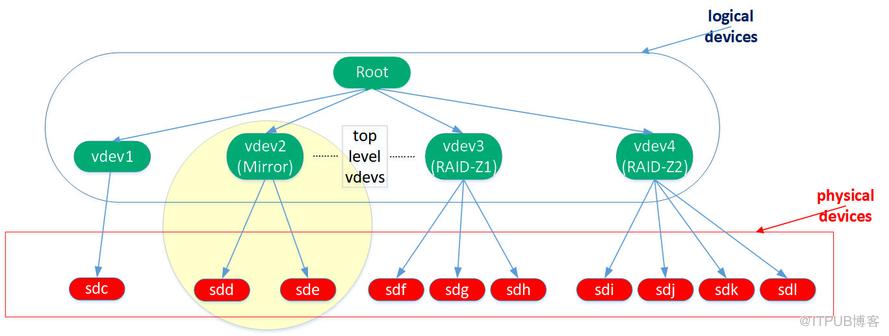
使用如下命令创建一个存储池tank
zpool create -f tank sdc mirror sdd sde raidz1 sdf sdg sdh raidz2 sdi sdj sdk sdl

逻辑虚拟设备为VDEV1、VDEV2、VDEV3、VDEV4
VDEV1对应的物理设备为:sdc
VDEV2对应的物理设备为:sdd、sde组成的RAID1
VDEV1对应的物理设备为:sdf、sdg、sdh组成RAIDZ1
VDEV1对应的物理设备为:sdi、sdj、sdk、sdl组成的RAIDZ22.
Label 磁盘结构:
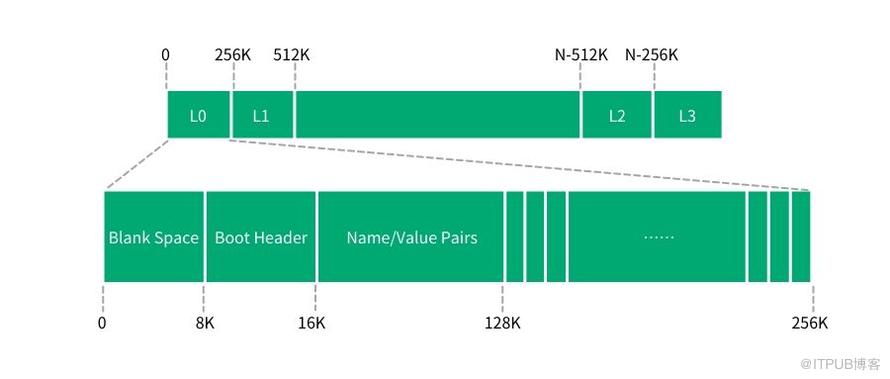
- 在 ZFS 中直接的分配空间的是虚拟设备 VDEV 去完成的,每个 VDEV 下的 physical devices 都存在如下的 Label 信息,在物理设备的首尾两个,共四个。
- 更新方式是两阶段更新的:在一个 TXG 中 sync 的结束阶段先更新 L0,L2;如果成功再更新 L1 和 L3。
- 这样更新和布局的好处是:无论何时掉电,总会有一个 Label 是可用的。
- Name/Vaule 记录的就是当前的 VDEV 下的物理设备的拓扑关系
sdc 的 Label 信息:
[root@ks0 ~]# zdb -l /dev/sdc1

LABEL 0

version: 5000
name: 'tank'
state: 0
txg: 4
pool_guid: 2896170471310910827
errata: 0
hostname: 'ks0'
top_guid: 2751819047198290687   //vdev guid
guid: 2751819047198290687       //phyical dev guid
vdev_children: 4              //总共4个vdevs
vdev_tree:
type: 'disk'
id: 0                       //vdev id编号
guid: 2751819047198290687   //vdev guid
path: '/dev/sdc1'
whole_disk: 1
metaslab_array: 148         //vdev的metaslab的个数
metaslab_shift: 27          //vdev的metaslab大小
ashift: 9                   //metaslab分最小分配单元512B
asize: 21459632128          //vdev的大小
is_log: 0
create_txg: 4
features_for_read:
com.delphix:hole_birth
com.delphix:embedded_data
labels = 0 1 2 3
sdd 和 sdc 的 Label 信息
   type: 'mirror'                 | type: 'mirror'
   id: 1                          | id: 1
   guid: 14326320160136866584     | guid: 14326320160136866584
   metaslab_array: 146            | metaslab_array: 146
   metaslab_shift: 25             | metaslab_shift: 25
   ashift: 9                      | ashift: 9
   asize: 5353504768              | asize: 5353504768
   is_log: 0                      | is_log: 0
   create_txg: 4                  | create_txg: 4
   children[0]:                   | children[0]:
       type: 'disk'               | type: 'disk'
       id: 0                      | id: 0
       guid: 14834175139806304144 | guid: 14834175139806304144
       path: '/dev/sdd1'          | path: '/dev/sdd1'
       whole_disk: 1              | whole_disk: 1
       create_txg: 4              | create_txg: 4
   children[1]:                   | children[1]:
       type: 'disk'               | type: 'disk'
       id: 1                      | id: 1
       guid: 4487740773939268111  | guid: 4487740773939268111
       path: '/dev/sde1'          | path: '/dev/sde1'
       whole_disk: 1              | whole_disk: 1
       create_txg: 4              | create_txg: 4
features_for_read:                 | features_for_read:
com.delphix:hole_birth         | com.delphix:hole_birth
com.delphix:embedded_data      | com.delphix:embedded_data
labels = 0 1 2 3                   | labels = 0 1 2 3
块管理
传统方式:
谈到存储池,也免不了需要介绍块管理机制,ZFS 的块管理机制是不同于其他的单机文件系统的管理方式。首先需要介绍一下传统的几种块管理方式:
-
位图管理:最常用的空间管理方法是位图。最小空间单元状态(分配或者空闲)用一个 bit 位表示。
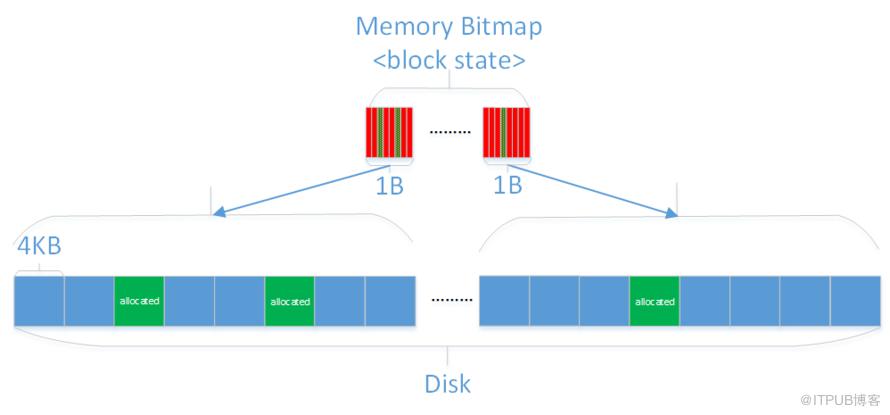
- 列如:4TB 磁盘,最小分配单元 4KB 需要 4KKKK}/4K/8=256MB;但是随着空间的增大比如 324T 的空间,这个位图的大小占用的内存空间就变得无法忽视了,并且每次空间的申请和释放都是要持久化位图信息到物理设备上,导致大量的磁盘 IO 操作,存在写放大问题。
- 解决方法:分而治之,使用多级管理的方式,比如:将 4TB 的空间分为多组,以位图组的方式进行管理,以二级甚至多级的方式管理位图都是可以的。如果有位图信息需要写入磁盘,只需要更新有改变的位图组信息到物理设备上,磁盘 IO 次数大大减少。
- 存在的问题:如果删除文件,该文件的空间分布在所有的位图组上,导致更新位图组的磁盘 IO 的并没有减少;位图管理方式无法避免随机释放的带来的大量的磁盘 IO 问题。
-
B*树:另外一个常用的管理空闲空间的方式使用 B-tree 管理,叶子节点存储实际的空闲的的偏移和大小。
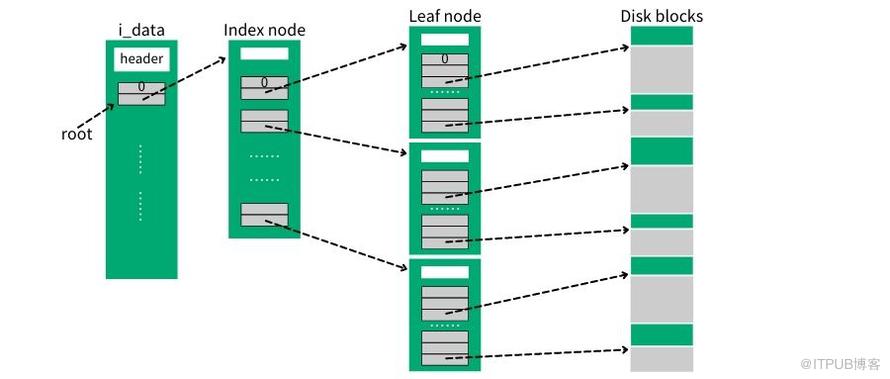
- 优点:分配连续的空间效率很高。
- 存在的问题:删除大文件时释放空间同样会带来大量的随机写,需要更新大量的叶子节点信息,同样存在写放大的问题。
ZFS 的管理方式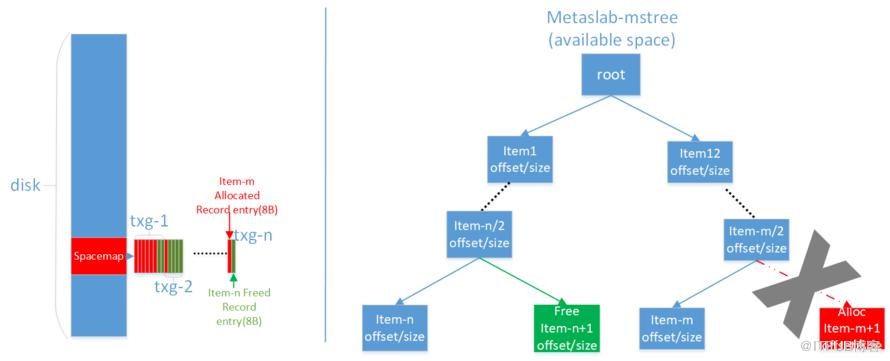
一种全新的空间管理方式:将空间的分配和释放行为作为 log 存入到磁盘中,而不是将空间的状态写入到磁盘。内存中维护的是可用空间的 range-tree,item 是 offset/size 。周期性的将分配和释放的记录写入到磁盘中。
当系统重新启动的时候,在内存中重做全部的 allocation 和 free 的记录,那么可以在内存中构建可用空间的 range-tree。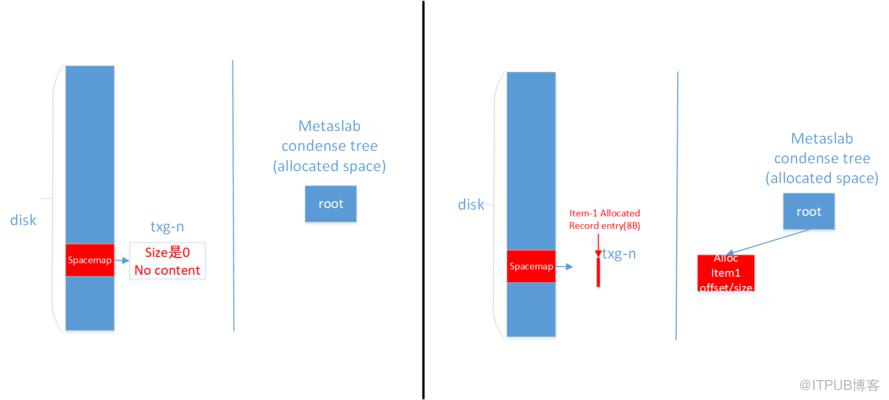
- 如果有很多分配释放被相互抵消了,会对之前累计写入的 log 进行一次精简。使用可用空间的 range-tree 得到一个分配空间的 range-tree(condense tree),作为 allocation 的记录写入到磁盘中。最极端的情况是分配空间的 range-tree 没有 item(全部空间可用),这个时候需要记录的 log 大小就是 0(真实情况是即使没有任何业务分配空间,最少占用一个两个 data block,一个是 spacemap header,一个记录 header 的使用的 record)。
- 或者空间使用的很多之后,也会进行 log 的精简。最极端的情况是分配空间的 range-tree 可能只有一个 item(空间被全部使用完了),此时的 log 大小是一个 item 的大小。
- ZFS 将每个 VDEV 的空间进行单独管理,每个 VDEV 按照按照一定大小进行分段管理管理,每个段称之为 metaslab ,在内存中使用 metaslab 的 mstree 管理可用空间,分配释放空间的 log 通过 spacemap 进行记录。
-
spacemap 使用的空间也会记录在 spacemap 的内容中。
-
由于 ZFS 中将 spacemap 也视作为一个文件的,所以更新的方式也是 COW 的,那就会存在每次 sync 中更新 spacemap 都会产生空间分配,那么 spacemap 的更新的怎么结束?ZFS 在更新 spacemap 的过程中取巧:spacemap 在一次 TXG-sync 逻辑中可能会更新多次,第一次更新是 COW 的,以后的更新都是 rewrite(Not COW)的;这样更新的好处是:
- COW 保证旧的 spacemap layout(拓扑)是有效的,如果更新的过程中意外宕机,依旧能从旧的 spacemap 中构建全部的块信息。
- rewrite 保证的 sync 的可以收敛结束,在第一次以后的 sync 逻辑中不再分配新的地址,而是在第一次 sync 分配的地址上追加的空间 record。
-
事务模型
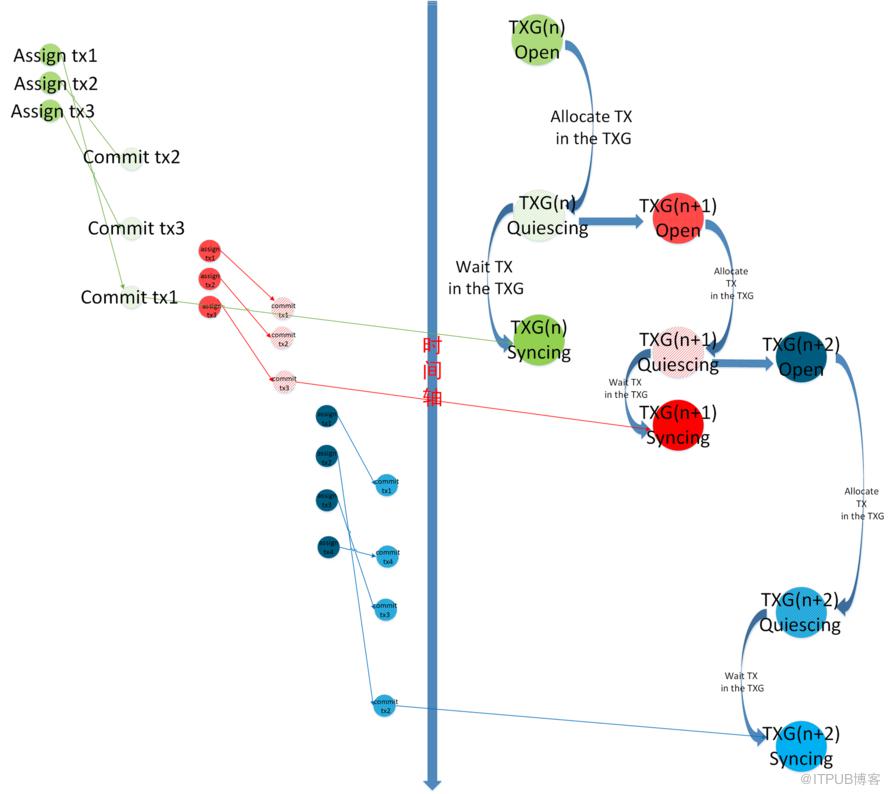
TX步骤:
- 更新文件的数据之前,需要将文件的 layout load 到 memory 中,
- 将更新操作和 TX-ID 绑定起来,更新 memory 中数据块的内容。
- 在 zio pipeline 流程中,分配空间,并写入物理设备。
- 将 dnode 标记为 dirty,绑定相关的 TXG 上,让 TXG-sync 线程逻辑去 COW 更新 dnode 的 indirect block 和 header block。
- 通知绑定的 TXG(相同TXG值)将 pending 事务计数减去1。
TXG 步骤:
- TXG 等待所有的 pending TX 完成,此时文件的 data block 内容都已经落盘。
- 在 sync 线程中,开始更新文件的 indirect block ,将最新的 data block 地址和 checksum 写入到 indirect 中,为 indirect 和 header 分配空间,一次更新内存中 indirect 和 header,然后写入到磁盘。
- 将在这个 TXG 中分配和释放操作,作为 record 写入到 spacemap 中;继续向上更新 metaclass 的信息到磁盘中,直到更新到 uber。
- 然后两阶段提交 Label中 uber 的信息,uber 中记录是最新的文件的系统 root 地址。
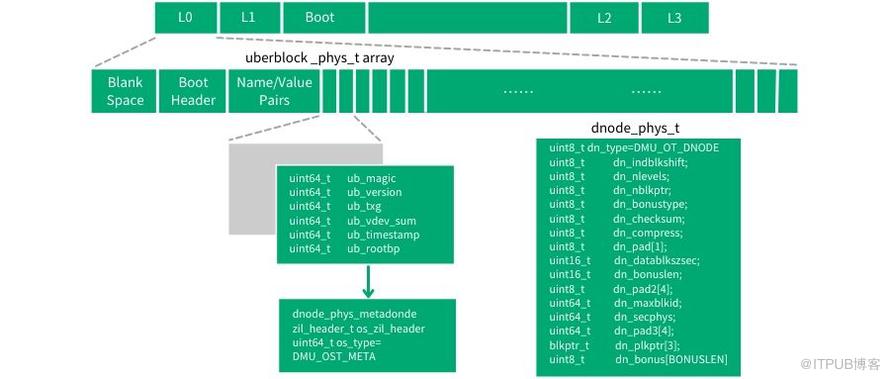
- root 中记录 zfs 最新的名字空间的 root 的地址。
- root 中记录了最新的空间管理的 root 的地址。
- root 中记录最新的 intend log 的 root 的地址。
存在的问题:
- 是只有 TX 结束的时候,给自 ZPL 上层的业务返回结果。
- 但是此时 TXG 的 sync 是异步执行,有可能 TXG 的 uber 还没更新。
- TXG 中的 TX 业务操作所产生的最新的空间 layout 状态还未持久化的磁盘。
- 如果此时的发生了 crash ,业务已经返回给上层应用。
- 但是重启之后的空间状态是 TX 未操作的状态,从而导致数据不一致的问题。
- 为了避免这种不一致,这就需要介绍 Intend log 机制了。
未完待续
受篇幅限制,本文仅介绍了 ZFS 中的存储池、块管理与事务模型,后续我们会继续分享 Intend log、ZIO、DMU、ARC、Snap、Clone等机制。
Summary
来自Linus的一盆冷水:[《Don’t Use ZFS on Linux: Linus Torvalds》]。我们并不需把 Linus 的每句话奉为圭臬,辩证的看待他的观点,并且 Linus 主要表达的还是对 Oracle 的不信任,以及可维护性方面担忧,并没有对 ZFS 优秀的设计喷垃圾话。直到今天再看二十年前设计的 ZFS,它的 COW,TXG,ZIO,LOG,块管理的设计理念依然让我惊叹不已,ZFS 针对数据存储的痛点,从最底层设计进行革命性的优化和创新。
om) 发布!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/1446/viewspace-2797345/ ,如需转载,请注明出处,否则将追究法律责任。

