通常数据库故障切换称为“Failover”,当主从库是异步复制或同步复制时,如果主库出现了问题失效,我们有两个方案可以激活从库作为主库来提供服务。
一、手工切换
通过“pg_ctl promote”命令来激活从库。
当主库故障后,从库系统日志中会出现错误:
[halo@localhost ~]$ 2022-05-18 09:57:33.015 CST [1508] 致命错误: 无法从WAL流中获得数据: 服务器意外地关闭了联接这种现象通常意味着服务器在处理请求之前或者正在处理请求的时候意外中止2022-05-18 09:57:33.016 CST [1504] 日志: 0/302D640 处的记录长度不合法:想要 24,但得到的是 02022-05-18 09:57:33.020 CST [2602] 致命错误: 无法连接到主用服务器:无法联接到服务器: 拒绝连接服务器是否在主机 "node1"(10.16.16.165) 上运行并且准备接受在端口1921 上的 TCP/IP 联接?
从库提示无法连接到主库。
这时我们可以手动执行pg_ctl promote命令来提升从库,当pg_ctl promote被运行,pg_promote()被调用,或一个触发器文件被找到(promote_trigger_file),从库模式会退出并且服务器会切换到普通操作。
[halo@localhost ~]$ pg_ctl promote等待服务器进程加载 ....2022-05-18 09:58:22.101 CST [1504] 日志: 接收到提或请求2022-05-18 09:58:22.101 CST [1504] 日志: redo 在 0/302D608 完成2022-05-18 09:58:22.101 CST [1504] 日志: 上一次完成事务是在日志时间2022-05-18 09:37:14.742818+08完成的.2022-05-18 09:58:22.143 CST [1504] 日志: 已选择的新时间线ID:22022-05-18 09:58:22.228 CST [1504] 日志: 归档恢复完毕2022-05-18 09:58:22.243 CST [1503] 日志: 数据库系统准备接受连接完成服务器加载完毕
一旦pg_ctl promote命令正确完成,此时从库即被提升为主库,可以正常对外提供服务。
我们可以用psql连接到数据库中,看到数据库已经变成主库状态:
halo0root=# select pg_is_in_recovery();pg_is_in_recovery-------------------f(1 行记录)
如果原主库故障解决之后,通常我们会把原主库转换成新主库的Standby从库。正常一般是需要重新搭建从库,因为原主库的一些数据还没有同步过去就把从库激活了,从库相当于丢失了一些数据。再重新搭建从库的话,如果数据库很大,基础备份执行时间会很长,解决这个问题的方法可以使用pg_rewind命令。不需要复制太多的数据就可以把原主库转换成新主库的从库。
使用pg_rewind命令要求原主库必须把wal_log_hints参数设置成on,或者在数据库初始化时使用“-k”参数开启 checksums 功能,这样配置的主库在出现故障时才能使用pg_rewind命令。
如果没有把参数wal_log_hints设置成on,运行pg_rewind时会报错:
[halo@localhost ~]$ pg_rewind -D $PGDATA --source-server='host=192.168.56.109 user=pgrewind password=123456 dbname=halo0root' -Ppg_rewind: 已连接服务器pg_rewind: 致命的: 目标服务器需要使用数据校验和或者让"wal_log_hints = on"

将原主库wal_log_hints参数为“on”之后,把数据库重启再正常关闭,然后再执行pg_rewind:
[halo@localhost ~]$ pg_rewind -D $PGDATA --source-server='host=node2 user=pgrewind password=123456 dbname=halo0root' -Ppg_rewind: 已连接服务器pg_rewind: 服务器在时间线1上的WAL位置0/302D640处发生了分歧pg_rewind: 从时间线1上0/302D590处的最后一个普通检查点倒带pg_rewind: 读取源文件列表pg_rewind: 读取目标文件列表pg_rewind: 读取目标中的WALpg_rewind: 需要复制 51 MB(整个源目录的大小是 73 MB)已复制52893/52893 kB (100%)pg_rewind: 正在创建备份标签并且更新控制文件pg_rewind: 正在同步目标数据目录pg_rewind: 完成!
注意,上面的“-D”参数指向本地的目录,“node2”可以是IP地址,user需要是超级用户。
pg_rewind执行完成之后,需要手动创建文件“standby.signal”:
touch $PGDATA/standby.signal并将postgresql.auto.conf文件中的信息删掉。然后配置postgresql.conf中添加如下内容:
primary_conninfo = 'user=replica password=123456 channel_binding=prefer host=node1 port=1921 sslmode=prefer sslcompression=0 ssl_min_protocol_version=TLSv1.2 gssencmode=disable krbsrvname=halo target_session_attrs=any'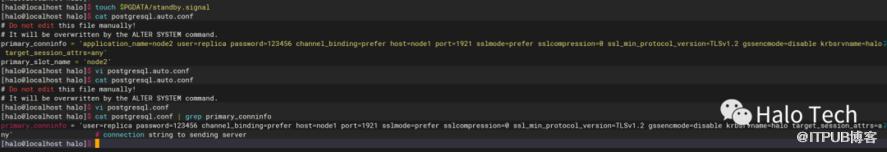
这样原主库才能变成新主库的从库。现在启动node1数据库,就变成了node2的从库:
[halo@localhost halo]$ pg_ctl start等待服务器进程启动 ....2022-05-18 10:57:15.956 CST [6220] 日志: 终止日志输出到标准错误输出设备2022-05-18 10:57:15.956 CST [6220] 提示: 后续的日志输出将进入到目标日志 "csvlog".2022-05-18 10:57:15.956 CST [6220] 日志: 正在启动 Halo 13.6 on x86_64-pc-linux-gnu, compiled by gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-44), 64-bit2022-05-18 10:57:15.957 CST [6220] 日志: 正在监听IPv4地址"0.0.0.0",端口 19212022-05-18 10:57:15.957 CST [6220] 日志: 正在监听IPv6地址"::",端口 19212022-05-18 10:57:15.960 CST [6220] 日志: 在Unix套接字 "/var/run/halo/.s.PGSQL.1921"上侦听2022-05-18 10:57:15.966 CST [6221] 日志: 当日志时间2022-05-17 10:38:22 CST进行恢复时,数据库系统被中断2022-05-18 10:57:15.966 CST [6221] 提示: 如果这种现象多次发生,那么表示数据可能已经损坏,您可能需要选择更早一点的恢复目标2022-05-18 10:57:16.569 CST [6221] 日志: 正在进入备用模式2022-05-18 10:57:16.574 CST [6221] 日志: redo 在 0/302D558 开始2022-05-18 10:57:16.577 CST [6221] 日志: 在0/304DFA8上已到达一致性恢复状态2022-05-18 10:57:16.577 CST [6221] 日志: 0/304DFA8 处的记录长度不合法:想要 24,但得到的是 02022-05-18 10:57:16.578 CST [6220] 日志: 数据库系统准备接受只读请求的连接2022-05-18 10:57:16.584 CST [6226] 日志: 在时间点: 0/3000000 (时间安排2)启动日志的流操作完成服务器进程已经启动
注意:一定要先建好standby.signal文件,再启动数据库。
二、自动切换
我们基于keepalived实现2节点的主从自动切换。
在主从库上使用root用户安装keepalived
yum install -y keepalived安装之后修改/etc/keepalived路径下keepalived.conf原文件名
使用自己的keepalived.conf文件、health_check.sh文件,放到/etc/keepalived下
keepalived.conf文件global_defs {router_id halo_13vrrp_skip_check_adv_addrvrrp_garp_interval 0vrrp_gna_interval 0script_user rootenable_script_security}vrrp_script health_check {script "/etc/keepalived/health_check.sh /u01/app/halo/product/dbms/13 /data/halo 10.16.16.169"interval 1weight -5fall 2rise 1}vrrp_instance VI_1 {state BACKUPinterface eth0virtual_router_id 51priority 100advert_int 1authentication {auth_type PASSauth_pass 12345}track_script {health_check}virtual_ipaddress {}}health_check.sh脚本#!/bin/bashPGHOME=$1PGDATA=$2VIPADDR=$3A=`ps -C postgres --no-header | wc -l`B=`ip a | grep $VIPADDR | wc -l`C=`ps -ef | grep postgres | grep 'startup recovering' | wc -l`D=`ps -ef | grep postgres | grep 'walreceiver' | wc -l`echo "===`date "+%Y-%m-%d--%H:%M:%S"`===" >> /tmp/health_check.logecho "Status A: $A" >> /tmp/health_check.logecho "Status VIP: $B" >> /tmp/health_check.logecho "Status C: $C" >> /tmp/health_check.logecho "Status D: $D " >> /tmp/health_check.logif [ $A -eq 0 ]; thenecho "`date "+%Y-%m-%d--%H:%M:%S"` failed" >> /tmp/health_check.logsystemctl stop keepalivedelseif [ $B -eq 1 -a $C -eq 1 -a $D -eq 0 ]; thensu - halo -c "$PGHOME/bin/pg_ctl promote -D $PGDATA"echo "`date "+%Y-%m-%d--%H:%M:%S"` standby promote " >> /tmp/health_check.logfifi
# 启动 keepalivedsystemctl start keepalived
先启动主库再启动从库。
当主库故障后,从库自动检测到主库出现故障,并提升自己为主库。VIP也一并从主库迁移至从库,应用无需修改配置即可继续正常运行(应用需支持重连)。
原文作者:Halo Tech;如有侵权,请联系管理员删除。

