大家好,我是酋长彭。
今天我们来做一件事情,把你每天都在敲的select语句拆开,看看从你按下回车的那一刻到屏幕上显示结果,
mysql有SQL内部到底经历了哪些步骤。理解了这条链路,你对慢查询优化和索引设计的认知就会从背规则升级到懂原理。
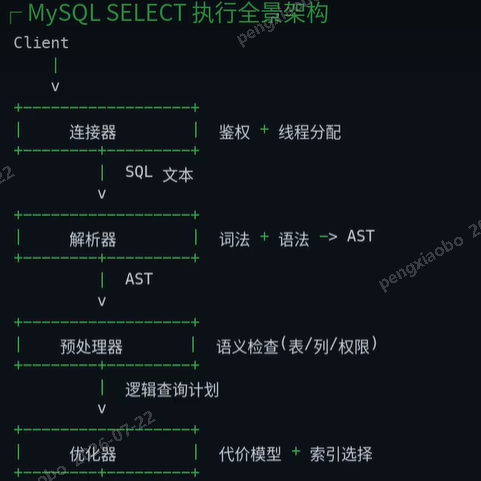
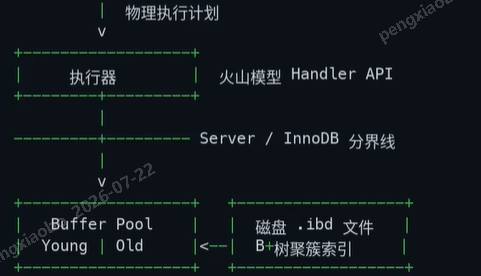
先看全景图,一条sql从客服端出发,依次经过连接器,解析器,预处理器,优化器,执行器,
这五个组件都属于MySQL server,然后通过handler API跨越分界线,然后进入innodb存储引擎层,
在Buffer pool 和磁盘之间找到数据并返回。
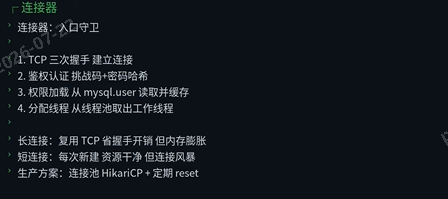
我们一步一步来拆解,第一站是链接器。当你执行mysql命令连接数据库时,连接器做三件事情:
tcp握手建立网络连接,鉴权验证你的用户名和密码,然后从mysql.user表加载你的权限并缓存到连接对象中。
生产环境一般用长连接加连接池来平衡性能和内存消耗。
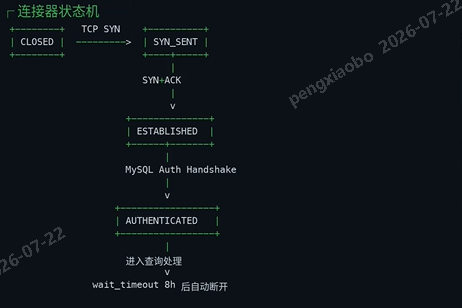
连接器内部是一个状态机。从TCP三次握手到mysql认证握手协议,最终进入已认证状态。
需要注意的是,空闲连接默认8小时后会自动断开,应用侧必须做连接有效性检测,否则你会拿到一个已经关闭的连接。
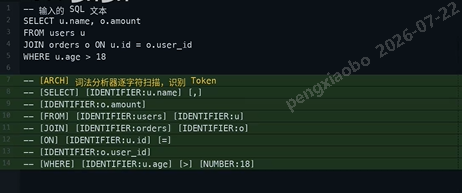
第二站是解析器,sql本质上就是一段文本字符串,解析器要把它变成计算机能处理的结构。
第一步是词法分析,逐字符扫描,把文本切割成一个个token,包括关键字,标识符,运算符和字面量。
mysql用的是flex生成的词法分析器。
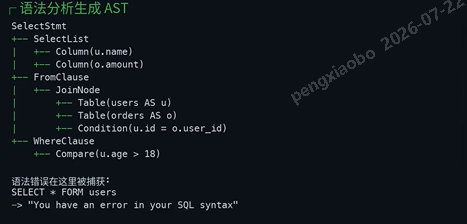
第二步是语法分析,按照BNF文法规则把token序列组装成抽象语法树,也就是ast。
mysql用的是bison生成的LALR(1)解析器。如果你的sql写错了,比如把from拼写成了form,
就是在这一步被发现并报错的。
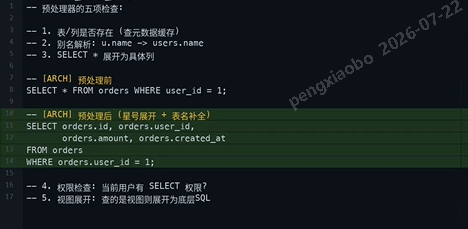
ast构建完成后交给预处理器做语义检查。它要确认你查询的表和列是不是真的存在,
把别名解析为全名,把select *展开成具体的列列表,还要验证你有没有权限查询这张表。
如果查的是视图,还会把视图展开为底层sql。
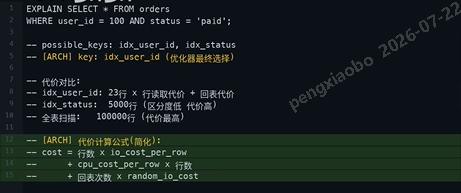
优化器是server层最复杂的组件。它基于代价模型来选择执行路径。比如这个查询有两个候选索引,
优化器会计算每个索引的扫描代价,包括IO代价,cpu代价和回表代价,然后选代价最小的那个方案。
这里idx_user_id只需要扫23行,而idx_status因为分区度低要扫5000行,所以优化器选了idx_user_id。
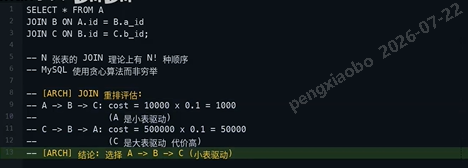
优化器的另一个重要工作是join顺序优化。三张表jion就有六种连接顺序,表再多的话排列组合会爆炸。
mysql用贪心算法来搜索,核心原则是小表驱动大表。在这个例子中,用A作为驱动表的代价远低于用C驱动,
所以优化器选择了A,B,C的顺序。
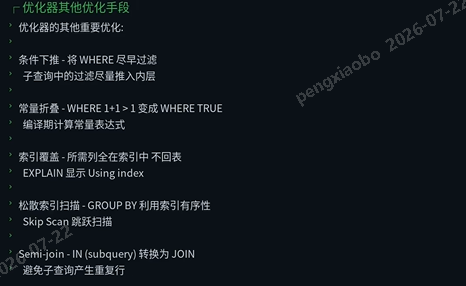
优化器还有很多其他优化手段,条件下推把过滤条件尽早执行减少数据量。
常量折叠在编译期就算好常量表达式。索引覆盖让查询只走索引不回表,这是最理想的状态。
这些优化都是自动进行的,但理解它们能帮你写出对优化器更友好的sql。
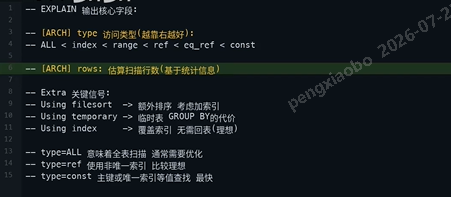
explain是我们分析查询计划最重要的工具。type字段表示访问类型,
从all全表扫描到const常量查找,越靠右越好。rows是估算的扫描行数。
extra里有三个关键信号:using filesort表示需要额外排序,using temporary 表示用到了临时表,
这两个都是性能警告。而using index表示覆盖索引不需要回表,这是最理想的状态。
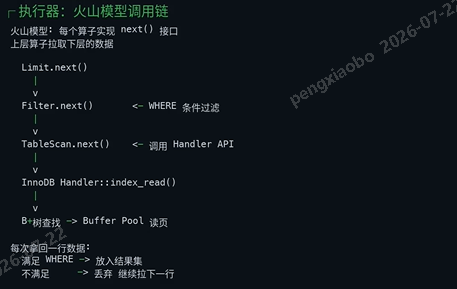
优化器输出执行计划后,交给执行器来驱动执行。mysql执行器使用火山模型,
每个算子都实现一个next接口,上层算子调用下层的next来一行一行的拉取数据。
最底层的tablescan通过handler api调用innodb存储引擎。执行器对每一行都要做where条件检查,
满足就放入结果集,不满足就丢弃继续拉下一行。
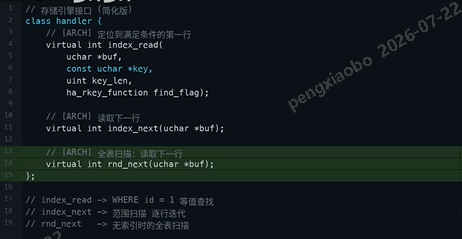
handler api是执行器和存储引擎之间的桥梁。这个接口设计的非常简洁,
核心就三个方法。index_read用来定位满足条件的第一行,index_next用来沿着索引读取下一行做范围扫描,
rnd_next则是全表扫描时逐行读取。innodb实现了这些接口,执行器不需要关心数据具体怎么存怎么读。
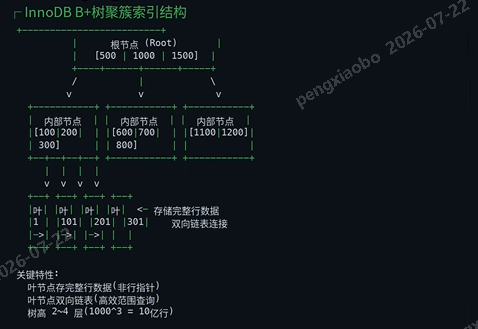
现在我们进入innodb存储引擎层。数据真正住在B+树聚簇索引里。根节点和内部节点只存储建值用于导航,
叶节点存储完整的行数据。叶节点之间通过双向链表连接,支持高效的范围查询。关键是这课树非常扁,
每个16KB的页能存大约一千个键,所以十亿行数据树高也只需要三层,三次io就能定位到任何一行。
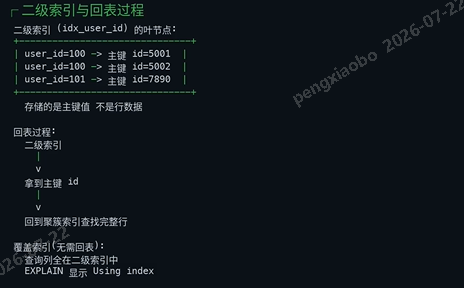
二级索引和聚簇索引有本质区别。二级索引的叶节点存的不是行数据,而是主键值。
索引通过二级索引查到数据后,还要拿着主键值回到聚簇索引再查一次,这个过程叫回表。
如果你查询的列全包含在二级索引里,就可以直接返回,不用回表,这就是覆盖索引。是最理想的状态。
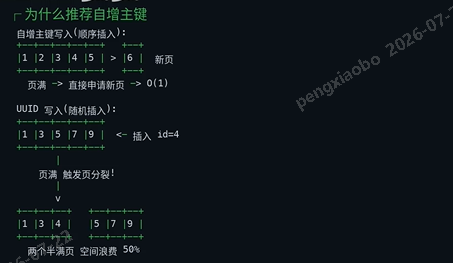
这就解释了为什么推荐用自增主键而不是uuid,自增主键保证新行永远顺序插入到叶节点末尾,
页满了直接申请新页就行。但uuid是随机的,可能需要在已满的页中间插入,
这就会触发页分裂,把一个页一分为二。页分裂不仅慢,还会导致大量碎片和空间浪费。
另外主键越短,二级索引就越小,int只占4字节,uuid要占36字节。
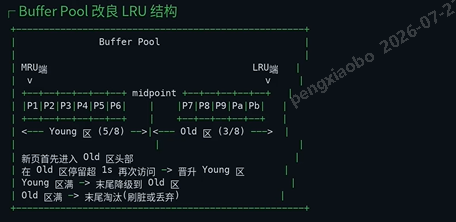
buffer pool是innodb最核心的内存结构,生产环境通常设为物理内存的60%~80%。
它不是普通的LRU,而是改良版。分成young取和old区,新读入的页先放old区,
停留超过1秒并在此被访问才能晋升到young区。这样设计的目的是防止全表扫描把热数据全部挤出去造成缓存污染。
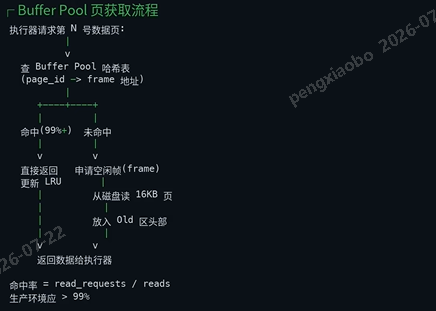
当执行器需要某个数据页时,先查找buffer pool的哈希表。命中了就直接返回内存中的数据,
更新一下LRU的位置。99%以上的情况都是命中的。如果没有命中,就要从磁盘读取16KB的数据页加载到内存。
这个命中率是一个关键监控指标,生产环境必须保证在99%以上。
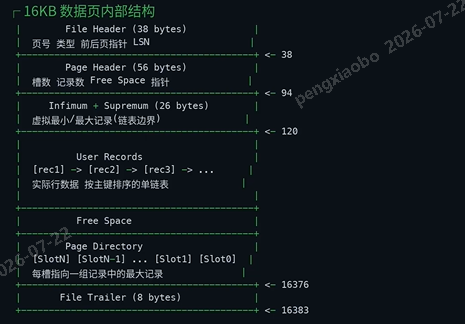
每个innodb数据页固定16kb,内部结构非常精妙。头部页号和前后页指针。
中间是按主键排序的行记录页链表。底部有一个page directory,也就是页目录,
它是把链表查找变成二分查找的关键设计。
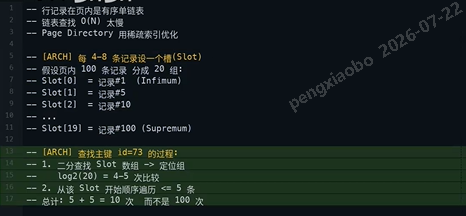
page directory是一个非常巧妙地设计。行记录在页内是按主键排序的单链表,
但链表查找是O(N)的,一百条记录要遍历1百次。page directory每隔4到8条记录设一个槽,
形成稀疏索引。查找时先对槽数组做二分查找定位到组,再在组内顺序遍历最多5条记录。
总共只需要10次操作而不是100次,这就是二分查找的威力。
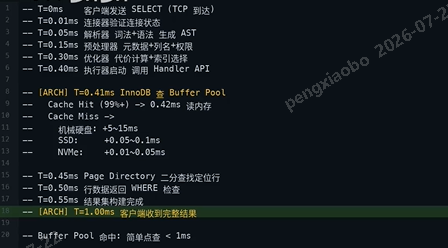
最后我们用一条时间线把整个过程串起来。从0毫米客户端发出查询,
到0.05毫米解析完成,0.03毫米优化器选好执行计划,0.04毫米执行器开始调用innodb。
如果buffer pool命中,0.42毫米就拿到了数据。经过where检查和结果集构建,
大约1毫米客户端就收到了完整结果。整个过程在缓存命中的情况下不到1毫米。
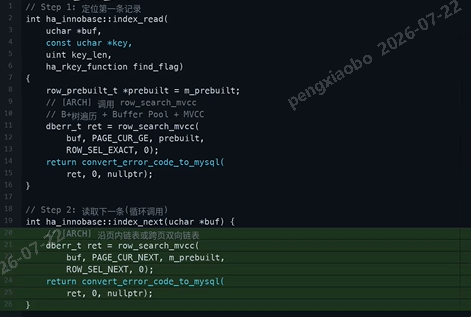
这是innodb实现handler api的核心代码。index_read定位第一条满足条件的记录,
内部调用row_search_mvcc函数,这个函数涉及B+树遍历,buffer pool访问和MVCC版本可见性判断。
index_next沿着页内链表或跨页双向链表读取下一条记录。执行器就是反复调用这两个方法来迭代获取所有满足条件的行。
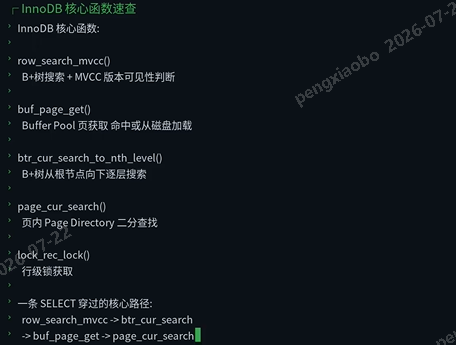
如果您想深入阅读innodb源码,这几个函数是最核心的入口。
row_search_mvcc是最顶层的搜索函数,它会调用btr_cur_search做b+树逐层搜索,
调用buf_page_get从buffer pool获取数据页,最后调用page_cur_search在页内做二分查找。
理解这条调用链路,你就掌握了innodb读取数据的核心骨架。
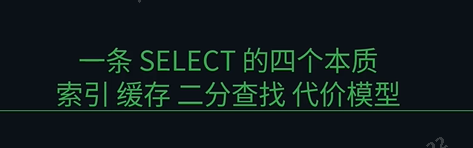
总结一下今天的核心结论。
1.索引的本质是用有序B+树替代全表扫描。
2.buffer pool的本质是用内存访问替代磁盘io。
3.page directory的本质是用二分查找替代链表遍历。
4.优化器的本质是用代价模型替代人工经验。
理解了一条select背后的完整链路,你对explain的解读,慢查询的优化,索引的设计就不再是背规则,而是真正懂原理了。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/12798004/viewspace-3176456/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 第88期 Oracle执行计划,彻底搞懂Oracle的执行计划 III
- 第87期 Oracle执行计划,彻底搞懂Oracle的执行计划 II
- 第86期 Oracle执行计划,彻底搞懂Oracle的执行计划
- 第85期 为什么直方图和绑定变量一起使用时,有时会引发性能问题
- 第84期 查询RAC之间私网的流量信息,监控 RAC 私网流量变化
- 第83期 MySQL JSON Duality View + HeatWave Vector Search for RAG
- 第82期 Oracle 19c RAC集群:如何在线迁移/替换 OCR 磁盘组
- 第81期 批量抓取数据库中耗时最高的SQL自动生成【Active HTML格式的SQL Monitor报告】
- 第80期 追踪 SQL 性能随时间变化、执行计划是否漂移、资源消耗变化
- 第79期 Oracle Buffer Busy Waits 等待事件 P3 参数详解
