从零到一spark进阶之路(二)
关于从零到一spark进阶之路(一)内容请点击下面的直通车
1.1RDD
(0)随便找个点理解以下
(1)RDD的特点
(2)RDD的好处
(3)RDD的内部属性
1.2RDD操作
1.2.1 转化操作
1.2.2 行动操作
2.如何创建RDD?
操作环境:python3.5
两种方式:①读取外部数据集② 在驱动器程序中对一个集合进行并行化
RDD可以从普通数组创建出来,也可以从文件系统或者HDFS中的文件创建出来。
from pyspark import SparkContextfrom pyspark import SparkContext as scfrom pyspark import SparkConfimport os
os.environ["PYSPARK_PYTHON"]="D:office3python\anaconda3.5\3.5envspython35\python"##任何Spark程序都是SparkContext开始的,SparkContext的初始化需要一个SparkConf对象,SparkConf包含了Spark集群配置的各种参数(比如主节点的URL)。初始化后,就可以使用SparkContext对象所包含的各种方法来创建和操作RDD和共享变量。Spark shell会自动初始化一个SparkContext(在Scala和Python下可以,但不支持Java)。#getOrCreate表明可以视情况新建session或利用已有的sessionconf=SparkConf().setAppName("miniProject").setMaster("local[*]")
sc=SparkContext.getOrCreate(conf)#(a)利用list创建一个RDD;使用sc.parallelize可以把Python list,NumPy array或者Pandas Series,Pandas DataFrame转成Spark RDD。rdd = sc.parallelize([1,2,3,4,5])123456789101112
print(rdd)#查看list被分成了几部分print(rdd.getNumPartitions())#查看分区的状态print(rdd.glom().collect())12345
ParallelCollectionRDD[0] at parallelize at PythonRDD.scala:480
3
[[1], [2, 3], [4, 5]]
下面不指定分区,执行语句
rdd = sc.parallelize([1,2,3,4,5])

print(rdd)
print(rdd.getNumPartitions())
print(rdd.glom().collect())12345
ParallelCollectionRDD[0] at parallelize at PythonRDD.scala:480
8
[[], [1], [], [2], [3], [], [4], [5]]
电脑是配置,逻辑8核。多次执行结果一样。可以看出创建了8 个executor。 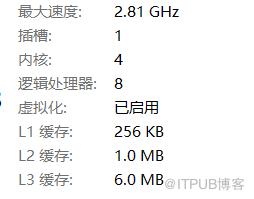
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/1064/viewspace-2803294/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
