SQL Server Architecture--PART III,基本的UPDATE处理流程
一,前言 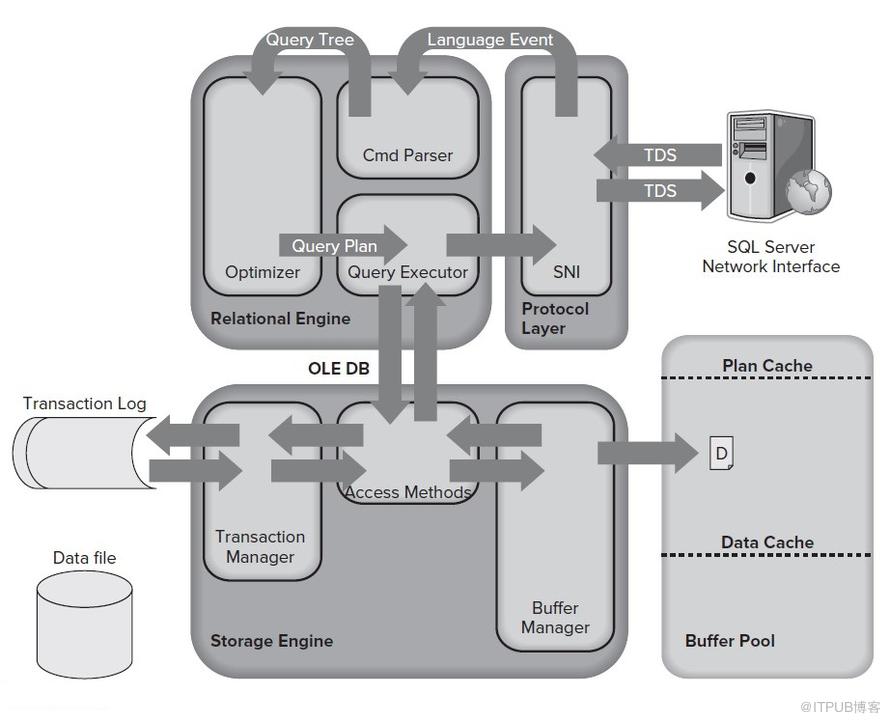
本篇介绍SQL SERVER处理基本UPDATE语句的时候的流程。
二,流程图
三,处理步骤解释
1. SQL Server客户端SNI与SQL Server服务器端SNI使用某种通信协议,比如TCP/IP,建立连接。然后,客户端基于此通信协议,在此通信协议的TDS端点上建立连接,接着,客户端将SELECT语句封装成 TDS message发往SQL Server服务器。
2. SQL Server端的SNI接收此TDS message并解包,并判断出这是个UPDATE语句,然后将此UPDATE语句与“SQL Command” 字样发送给Command Parser.Command Parser(命令解析器),主要负责对SQL语句做语法、语义分析并生成代数树。
3. Command Parser 检查计划缓存(plan cache,是 buffer pool的一部分),看在计划缓存中是否存在与此UPDATE相match的、可重用的执行计划,如果找到,则将找到的执行计划交给Query Executor,否则,Command Parser就为此UPDATE语句生成查询树并将查询树传给查询优化器以便产生查询计划。
4. 查询优化器(Query Optimizer,以下简称QO)接到需要优化的UPDATE语句后,按如下规则优化SQL:
A、首先,QO启动pre-optimization阶段,此阶段主要针对那些没有join的,非常简单的SQL语句,对于这样的语句,SQL SERVER可以在0成本的 情况下产生“zero cost” 执行计划,这种执行计划叫做trivial plans;
B,如果需要优化的SQL语句不符合产生trivial plans的条件,则SQL SERVER执行stage 2,以产生一个执行计划:
➤Phase 0 — During this phase the optimizer looks atnested loop joins and won’t consider parallel operators.
The optimizer will stop here if the cost of the plan it has found is < 0.2. A plan generated at this phase is known as a transaction processing, or TP, plan.
➤ Phase 1 — Phase 1 uses a subset of the possible optimization rules and looks for common patterns for which it already has a plan.
The optimizer will stop here if the cost of the plan it has found is < 1.0. Plans generated in this phase are calledquick plans.
➤ Phase 2 — This final phase is where the optimizer pulls out all the stops and is able to use all of its optimization rules. It also looks at parallelism and indexed views (if you’re running Enterprise Edition).
Completion of Phase 2 is a balance between the cost of the plan found versus the time spent optimizing. Plans created in this phase have an optimization level of “Full.”
注:QO在为SQL语句找寻执行计划时,不是必须要找到一个最好的执行计划,而是要找到一个足够好的计划就行。试想一下如下情况,100个
表做JOIN,本身就有N多执行计划,QO要找出最好的执行计划所耗费的资源和时间,很可能远远超过使用一个足够好的执行计划所耗费的
资源和执行时间.
5. 在执行的时候, Query Executor (QE)确定要完成查询计划,需要读取哪些数据,因此QE通过OLE DB interface(Rational Engine和Storage Engine之间的通信接口)将请求发给Storage Engine的Access Methods;
注:以上步骤与SELECT的处理流程基本完全相同
7. Buffer Manager 接到请求后,检查buffer pool的data cache,看看需要的页面是否已经cache在data cache中,如果已经在data cache,则转下一步,如果需要的页面没有在data cache中,则产生hard page Fault,从磁盘将需要的页面调入data cache中(这个时候会产生PAGEIOLATCH_*类的LATCH)
8. 接下来,Access Methods要求Transaction Manager的lock manager对需要更改的资源加锁(update语句需要更改的记录行上的行排它锁,索引键上的索引行排它锁,所属页面的IX锁,所属表或分区上的IX锁等等),如果成功获得需要的锁,则log manager会将需要做的更改写到transaction log,这个
是应ACID中的D这个特性的要求而做的。
注意,将更改写到DISK上这个动作是整个update语句执行过程中唯一需要写磁盘的地方,而且,只有在log manager成功写好transaction log后,才会
返回ACK消息给Access Methods,Access Methods才能接下来协调buffer manager干其他剩下来需要做的事情,所以,这里可以看到,如果log manager
写transaction log的性能差的话,整个UPDATE过程的性能肯定就好不了,这也就是为啥要把transaction log放在IO能力强的分区上,甚至单独划分分区来访transaction log文件的原因。
9,现在,log manager成功将需要做的变动写到了transaction log文件,于是,log manager将成功写日志的消息返回给Access Methods;
10,接下来,Access Methods请求buffer manager到buffer pool中更改相应的页面,这个操作非常快,因为数据页在buffer pool中,这是从性能的
角度着眼的。
注:所有数据都必须先从磁盘上读到内存中才能进行操作
11,buffer manager成功更改了buffer pool中的页面,接着返回消息给Access Methods,Access Methods将成功更改数据的ACK消息返回给
关系引擎,然后关系引擎通知客户端,UPDATE操作成功完成。
总结:
在这个UPDATE执行的过程中,下面这些地方可能会影响性能:
1,重用执行计划(但要注意,重用执行计划不一定是好事情,所以这里用了"可能");
2,lock manager在申请锁的时候,如果被阻塞,则会影响update的执行效率
3,log manager写实物日志的效率对UPDATE的执行性能有直接而显著的影响;
4,如果update需要更改的page驻留在buffer pool的data cache中,则不需要去disk读取相应页面,这也有助于
提高update的性能。
 update.jpg
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/101629/viewspace-762336/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
最新文章
- Tempdb latch竞争的优化
- SQL Server Architecture--PART II,基本的SELECT查询流程
- sql server 2012--集群采用多数节点的方式加Servercore
- ch16,SQL SERVER 2012中可管理性的改进--使用UI来完成到特定时间点的恢复
- ch15,Delivering a SQL Server Health Check--PART 5
- ch15,Delivering a SQL Server Health Check--PART 4
- ch15,Delivering a SQL Server Health Check--PART 3
- ch15,Delivering a SQL Server Health Check--PART 2
- ch15,Delivering a SQL Server Health Check--PART 1
- 使用窗口函数解决实际问题---虚拟数字辅助表
