基于 Agent 观测实践:开发态与运行态的统一追踪方案
You see, but you do not observe.
徒见其形,未察其微。
—— 柯南·道尔,《The Adventures of Sherlock Holmes》
假设你正用 Codex [1] 开发一个基于 Deep Agents [2] 的技术知识助手,希望它检索项目文档,回答版本配置问题。Codex 在开发过程中读取文件、修改代码、运行测试;而新助手运行起来后,又会调用模型、检索资料、组织上下文。
问题可能出现在不同地方:Codex 执行到一半停住,你想知道它卡在了哪次工具调用;新助手给出了旧版配置,你想核对检索结果怎样进入模型输入。前一个问题,要回看编程智能体的执行过程;后一个问题,要回看你所开发智能体的运行过程。
从开发到实际运行,两边都需要观测。 它们的采集入口却不一样:一边是现成应用管理的执行过程,一边是自己维护的程序。观测平台需要分别适配,再把采到的数据整理成一致的任务记录,让你用同一套轨迹视图读懂两边发生了什么。
上一篇,我们谈到让运行数据参与之后的工作。这一篇先把目光放在观测本身:怎样从不同运行入口留下记录,把它们关联起来、读懂,并在下次排查或交流时找得回来。Data In The Loop 要从这些日常动作里开始。
欢迎大家关注 OceanBase 社区公众号“老纪的技术唠嗑局”。在这里,我们会持续为大家更新与 和 #Data 相关的技术内容~
两种采集入口,一致的任务记录
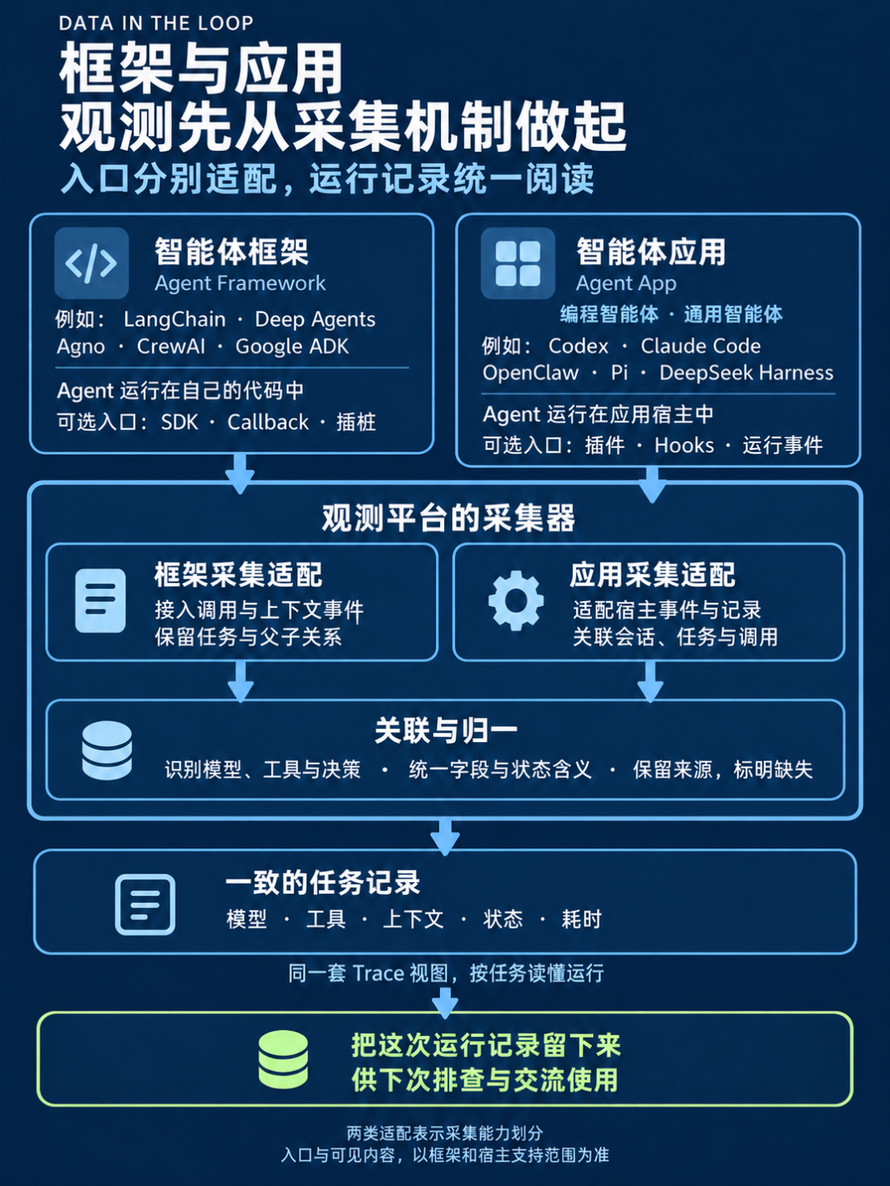
智能体框架(Agent Framework) 用于搭建自己的 Agent,例如 LangChain [3]、Deep Agents、Agno [4]、CrewAI [5]、Google ADK [6](Agent Development Kit)。你用它们把模型、工具和上下文组织成自己的 Agent。
程序在自己维护的代码里运行。你可以接入采集 SDK,利用框架的回调(callback),或在关键位置加上记录,也就是插桩,留下模型调用、工具参数与返回、上下文处理过程。采集点放在哪里,往往能结合自己的实现决定。
在这个助手里,检索工具返回了资料,你还想知道这些资料经过处理后,实际送给模型的是什么。在自己的程序里,可以把前后两个位置一起记录,再通过任务与父子调用关系接起来。新增节点或子任务以后,也要检查原来的采集是否还能跟上。
智能体应用(Agent App) 在这里主要指可以直接接收任务的编程智能体和通用智能体。它们已经把模型、工具和执行过程组织起来,你可以把任务交给它们,不必先搭建自己的 Agent。
编程智能体通常围绕代码仓库工作,例如 Codex、Claude Code [7]、Pi [8]、DeepSeek Harness [9](dsh),可以读取文件、修改代码、运行命令,再根据结果继续下一步。通用智能体面向更广的任务,例如 OpenClaw [10] 这样的个人助理,可以通过接入的工具处理日常事务。两类能力会有重叠,具体任务和可用工具取决于应用的配置。
在开篇的例子里,想看 Codex 这次开发任务的记录,就要借助应用宿主开放的采集入口,比如插件、特定运行环节触发的 hooks(钩子)或运行事件。其他应用也要按各自开放的入口接入;具体采用哪种方式、能拿到哪些信息,要按应用支持的范围确认。没有开放或没有采到的部分,也需要说明清楚。
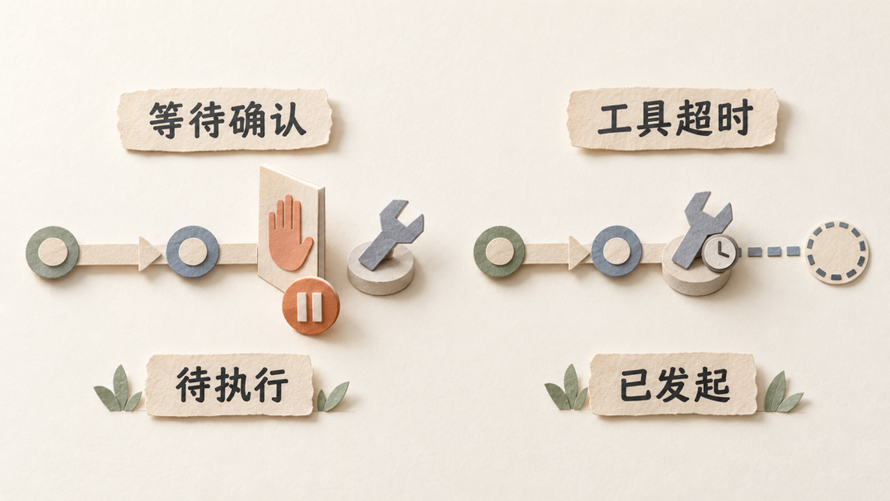
因此,观测平台需要分别适配框架和应用的采集机制。接入之后,还要读懂不同来源的字段和事件含义, 把调用关联到对应任务,保留父子关系,并标明记录的缺口。 看到一条工具记录时,要能分清它是准备执行、已经发起,还是已经返回。
两种采集入口得到的记录,可以整理成一致的任务结构。之后展开调用、查看输入与返回、核对上下文,用的是同一套运行轨迹(Trace)视图。采集适配处理来源差异,也要标明无法获得的信息,让人知道这些记录能解释到哪一步。
Data In The Loop 也从这里开始:让来自自己代码或宿主应用的数据,都能带着采集范围和运行条件留下来。之后再查这次任务时,知道记录说了什么,也知道还有什么无法确认。
开篇的 Codex 开发任务,与助手随后的一次运行,通常各有自己的轨迹。统一呈现让我们用同一套方式阅读两者;如果还想追查“这次运行对应哪版代码、哪次修改”,就要把项目、代码版本和运行标识等关联依据留下来。这样,开发时的记录和实际运行的记录,才有机会在之后的排查中接起来。
沿一项任务,读懂调用与上下文
继续看开篇那个技术知识助手。用户问新版本该怎样配置,它却给了旧版本的方法。
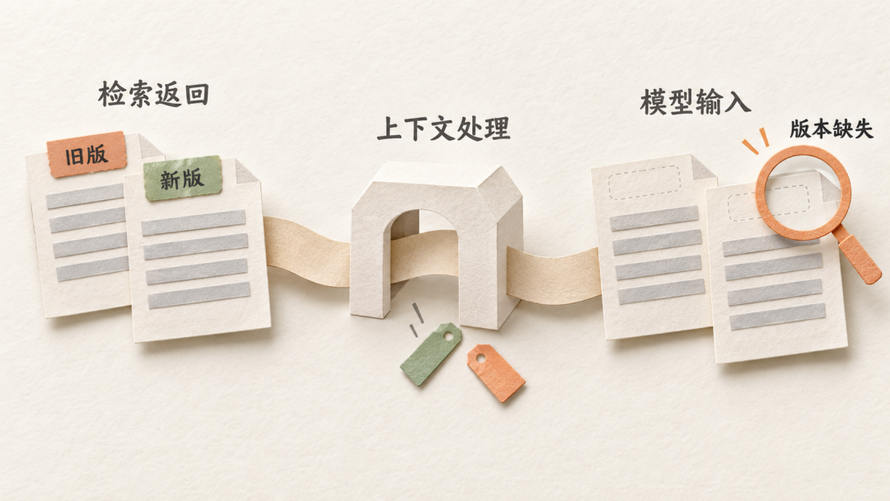
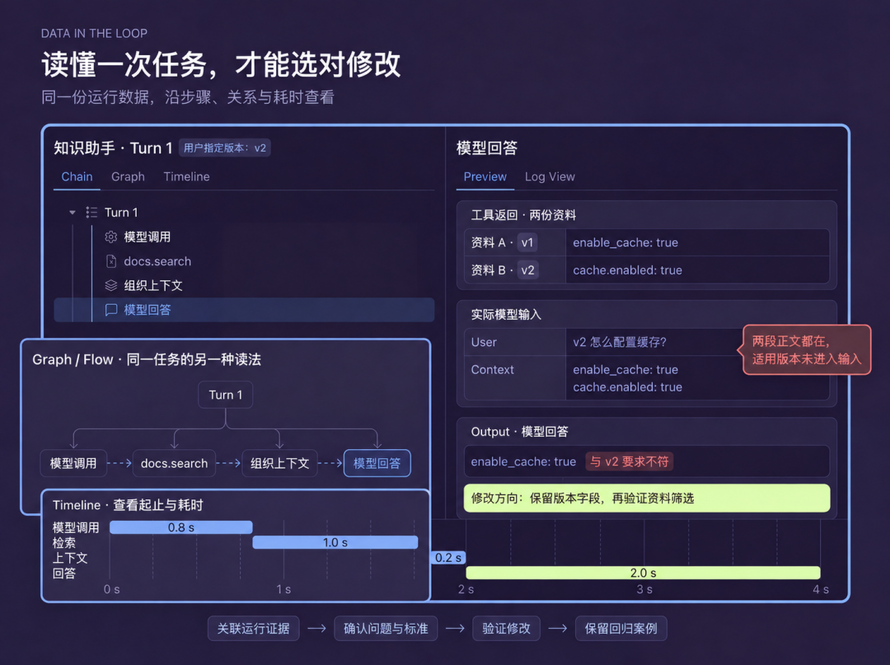
假设检索工具已经返回新旧两份资料,而且都标明了适用版本。展开模型调用后,你发现送给它的上下文只剩正文,适用版本没有传进去。原始返回与实际输入关联在一起,就有了继续追查上下文处理的线索。它能解释多少问题,还要结合其他记录判断;至少我们可以沿着这次运行,核对“检索成功”之后实际用到了什么资料。
我们在做观测界面时,会考虑同一项任务怎样从不同角度读。
-
Chain 方便沿调用层级逐步展开;
-
Graph 以流程图呈现记录中的层级关系与执行顺序;
-
Timeline 帮助检查各步骤的起止与耗时。
切换读法以后,仍要能选中同一个步骤,查看对应输入和返回。
遇到并行或嵌套调用时,调用层级帮助识别归属,时间记录帮助核对先后;图上的连接还要看它表达什么关系。 已采集的层级与顺序不等于完整的因果关系,判断某一步影响了什么,仍要回到参数、返回和上下文核对。
上下文和记忆也值得这样读。写入了什么,下一次取回了什么,其中哪些进入实际模型输入,尽可能沿记录对照。长对话中,早先提供的信息是否还在、是否经过摘要或裁剪,也要以实际记录为依据。这样,你可以核对这次输出所依赖的信息,而不只凭对话中的记忆猜测。
提供 Agent 开发与观测工具的 LangChain [11],在讨论 Agent 观测的文章 [12]中,也强调具体行为与步骤、上下文记录的联系。先能读清运行过程,后面的讨论才有共同依据。
这些记录包括已采集到的输入、输出、调用和状态,不等于模型全部的内部思考。 没采到的上下文、脱敏后的字段,要能看出缺口;证据不足以确认某个步骤是否发生时,就先保留“未知”。
工具和模型选择,怎样接回任务
Agent 通过 MCP 访问资料、文件或外部工具时,一次任务可能经过好几个服务。遇到卡顿,你往往想先找到停住的调用,再看它传了什么、收到了什么,后面怎样继续。
所以我们在考虑 MCP 观测时,会把总览和单次轨迹接起来:从 Server 找到最近调用,再回到所属任务,查看已采集的参数、返回和耗时。一个人可以从“这次为什么停住”开始;团队可以核对反复出现的超时,看看涉及哪些任务和工具版本。
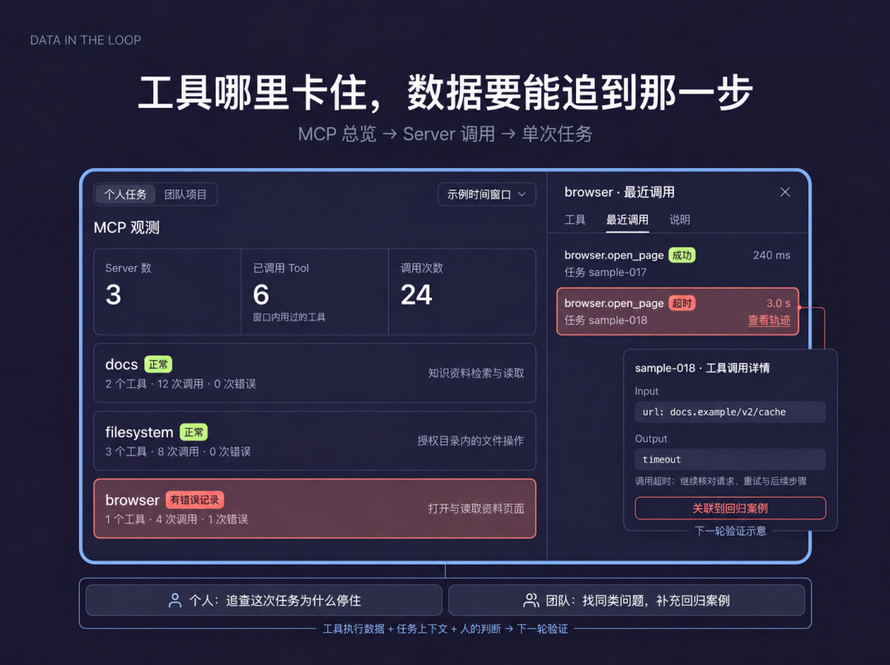
一次停顿可能落在模型响应、工具访问或确认交互上。总览帮助找到排查入口,单次调用详情交代当时发生了什么,任务视图则把它接回前后步骤。能追到哪一层,要看实际采集到了哪些记录。
正常返回也值得继续读:查到了什么,内容有没有进入后续模型输入? 调用量、错误和耗时可以帮助缩小排查范围,不能直接说明回答是否正确。 把执行记录接回任务,才知道一个状态与眼前的问题有什么关系。
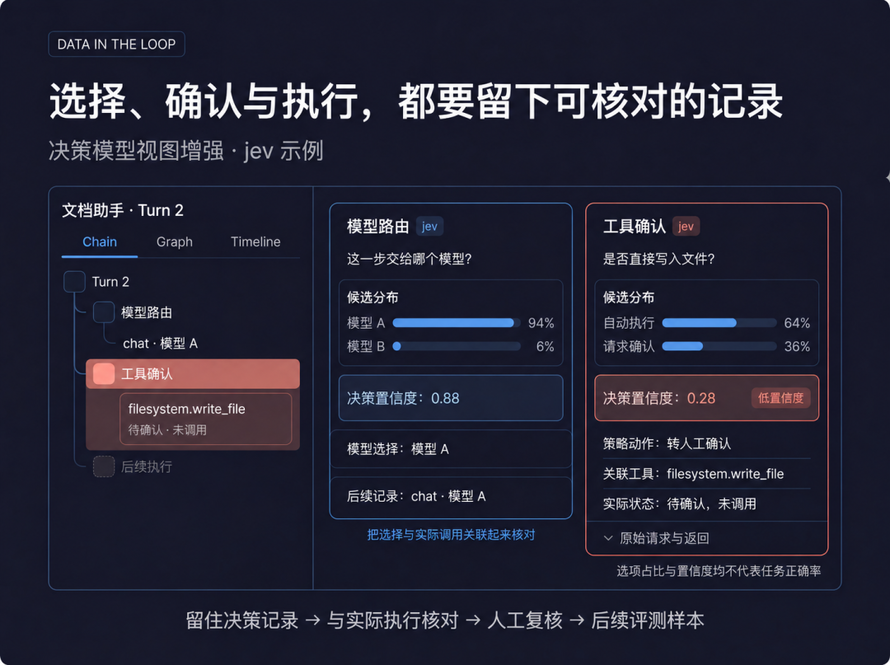
模型选择同样会改变执行路径。以图中的决策模型 jev 为例,它参与选择后续调用哪个模型。候选模型的分布、confidence(决策置信度)和后续实际调用,要分别呈现。 候选分布与置信度各有含义,都不代表任务正确率;实际调用记录则让人核对这次选择怎样落到了执行中。
工具确认是另一类要读清楚的决策。图中的模型给出自动执行的候选动作,策略因置信度不足转为请求确认。这时应能看见正在确认什么、工具是否已经调用;得到确认后,也要能找到实际执行的记录。 等待确认与工具故障要分开呈现,使用者才能知道接下来该处理什么。
把记录留给之后的自己和同事
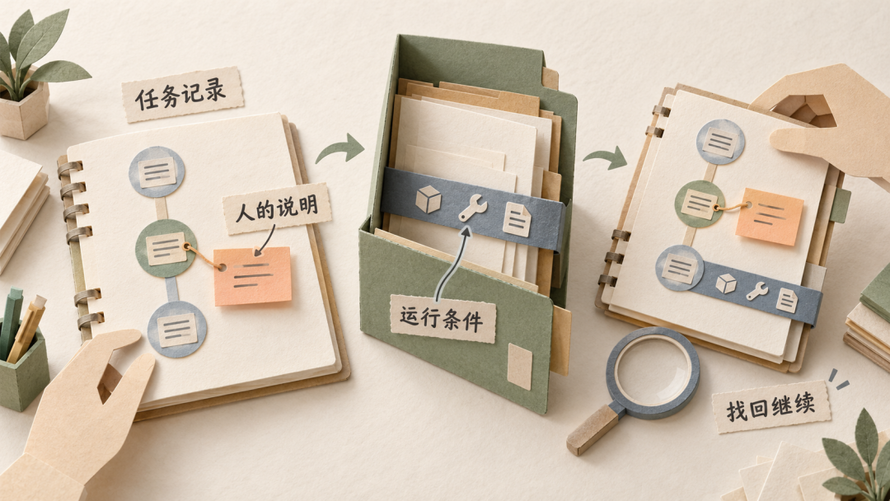
一次排查结束后,值得留下的还有人的解释:为什么怀疑这个步骤,哪些内容已经核对,哪里仍不确定。个人下次遇到相近任务时,可以找回这些线索;团队接手的人,也有机会沿同一份记录继续查。
这会影响界面怎样组织信息。任务摘要帮助人找到值得深入的地方,节点详情保留依据,关键字段说明含义。业务同事可以指出“这份资料不适用于用户的版本”,开发者继续追查处理过程,双方围绕同一处输入与返回讨论,少一些各自拿着截图重新拼经过的工作。
模型、提示词、工具和资料版本,也要与当次任务一起保留。 外部资料和工具会变化,查看旧记录时,需要分清当时运行的条件。运行耗时、调用和用量可以帮助理解消耗;按价格估算的费用与实际账单仍可能因缓存、计价方式和其他服务费用而不同。
到了第二天,查找“昨天那次任务”应当有明确入口。按任务或会话找到记录,再按需要查询相关调用、导出内容,或通过 API 交给自己的分析流程,人的说明也要保留与原步骤的关联。
个人复查需要能保存和带走有价值的材料。团队使用则要约定保存在哪里、谁能查看、哪些内容需要脱敏、留存多久。这些条件要跟着查询、导出和 API 复用一起考虑,让原始记录与人的补充说明能够在之后的工作里继续使用。
Data In The Loop 在这里很具体: 找回一项任务,读懂当时做了什么,把有依据的判断留下来,继续手上的工作。 我们正在准备一款开源的观测与评测产品,下一期会继续聊这些需求怎样落到具体实践里。
你在开发自己的 Agent,还是主要使用现成应用完成工作?
最难留下的是哪一段运行记录?
欢迎带着一个具体卡点来聊:数据接不进来、任务对不上,还是拿到了记录却看不懂?这些问题也会帮助我们继续完善采集和观测。
 参考资料[1]
Codex: https://github.com/openai/codex
[2]Deep Agents: https://docs.langchain.com/oss/python/deepagents/overview
[3]LangChain: https://docs.langchain.com/oss/python/langchain/overview
[4]Agno: https://docs.agno.com/agents/overview
[5]CrewAI: https://docs.crewai.com/introduction
[6]Google ADK: https://adk.dev/
[7]Claude Code: https://code.claude.com/docs/en/overview
[8]Pi: https://github.com/earendil-works/pi/tree/main/packages/coding-agent
[9]DeepSeek Harness: https://github.com/deepseek-ai/deepseek-harness
[10]OpenClaw: https://docs.openclaw.ai/help/faq/what-is-openclaw
[11]LangChain: https://www.langchain.com/about
[12]讨论 Agent 观测的文章: https://www.langchain.com/blog/agent-observability-powers-agent-evaluation
立即试用 OceanBase 企业版,体验国产数据库能力 立即试用
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69909943/viewspace-3186653/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PowerContext 1.4.0 发布:开发做到一半 - 企业级数据库实践
- 联通云犀平台 × OceanBase - 企业级数据库实践
- 聚势领航 - 企业级数据库实践
- 从语义层到本体 - 企业级数据库实践
- 又双叒叕一万亿银行升级 | 专访湖南农信 - 企业级数据库实践
- 构建跨会话与跨 Agent 的项目上下文底座 - 企业级数据库实践
- 服务全球 4000+ 企业:OceanBase 与 AWS 合作的全球化实践
- FAST 2027 论文:OceanBase PromTCS 时间序列存储架构解析
- 基于 3 类具身智能场景,多模态数据底座统一架构实践
- GPT-6 发布“Better prompt cache” - 企业级数据库实践
