胖头鱼的技术专栏-485 数据库把 AI 装进内核之后(20261104)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE
10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著 名社恐(社交恐怖分子)
全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭

10 月 30 日,电科金仓 2026 产品发布会暨金仓数据库开发者大会,在北京望京凯悦酒店办。主题就六个字:Hello,AI 数据库。
我上午在主会场听,下午在 DATA + AI 专场担任主持人,还做了一场主题演讲。
一天坐下来,印象最深的不是某个功能,是主会场和分会场关心的不是同一件事。
主会场的高频词是"库内":库内语义、库内计算、库内安全。分会场的高频词是"多模"“DiskANN”“PL/AI”,投影上全是 SQL 和包名。
上午讲位置,AI 的活从库外搬到库内,说的是产品长什么样。下午讲路径,怎么搬、搬完要付什么代价、哪一步会卡住。
两头拼起来,才算看全。这篇写三件事:会上听到了什么、这些能力省的是哪几笔账、哪一段它其实管不住。
数据库把 AI 装进内核,装进去的到底是什么?装完之后,哪些账真的省了,哪些只是换个地方记? 这篇就按这三个问题往下走。
一、上午听方向,下午听实现
发布会一共四个篇章:洞见航向、AI 重构、融合跃迁、熠然新生。前三个有内容,最后一个是颁奖,略过。名字起得挺齐整,内容倒不虚,我按顺序说。
两位致辞,说的是两件事
王珊老师先上台。人大信息学院教授、国内数据库学科带头人、金仓公司原董事长,这几个身份摆在一起,她讲的话就有分量了。
她的意思很清楚:人工智能正在重塑数据库的技术体系,AI 时代的数据库,既要保证数据存得准、算得对,还要为大模型理解业务提供语义支撑。
"提供语义支撑"这五个字,其实把整场发布会的主线提前说完了。 后面所有的能力,都是围着"语义"这两个字转的。
顺带还祝贺了一句:人大和金仓共建的"智能数据库系统与应用北京市重点实验室"获批了。产学研这事,国内数据库厂商这几年不少在做,能落到市级重点实验室这个层面的不多。
接着是电科太极总经理孙亭总。他讲的是"十五五"开局,数据库该往哪儿走,给了三条:内核融合、数据源头、开放生态。
这三条不是产品话术,是路线表态。 内核融合对应"库内",数据源头对应"语义从数据里长出来",开放生态对应 MCP 和 Agent Skills。 后面发布的东西,基本都能对进这三个框里。
我在台下记了一句:这种场合的致辞,客套在前,想说的在后。王珊老师落在"语义支撑"上,孙亭总三条路径里的"数据源头",说到底也是同一件事。
发布那一刻,三个痛点排在前面
电科金仓总裁杜胜总带来的分享中:他没先讲产品,先摆痛点,业务语义缺失、数据流转成本高、出库后安全失控。
然后才是三个"库内":库内语义构建、库内计算推理、库内原生安全管控。最后一句口号收尾: 数据不出库,AI 也能用。
三个痛点的排序,我觉得比产品本身更有信息量。
语义排第一,安全排第三。 换句话说,厂商自己认为最难的不是安全。安全是工程问题,一行行策略配下去总能配;让机器看懂"这个字段到底是什么意思",是认知问题,配不出来。
这个判断我认同。做过数据治理的都知道,最耗人的从来不是加密和审计,是搞清楚一张表里四十个字段各自代表什么。
三个"库内"之外还有一层:智能数据开发工具,管 60 多种多源数据的接入,里面分成特征工程、知识工程、知识图谱工程三块;再往外是 KES MCP、Agent Skills 这些对接 AI 开发工具的口子,以及 NL2SQL 智能体和运维智能体。
这一层容易被忽略,但它回答的是另一个问题:库外的数据怎么进来。库内能力再强,语料进不来也是空的。
口号换了,考卷也换了
第三篇章宣布品牌主张:从"数据库平替用金仓",换成"AI 数据库用金仓"。
同一时间还启动了全球化战略,杜胜总提到港澳市场和东南亚已经有落地实践。金兰组织也亮了一下家底:成员超过 700 家,这次联合十几家伙伴发了解决方案,覆盖金融、能源、医疗、政务、交通。
平替考的是兼容:能不能跑。AI 数据库考的是另外三样:数据可不可理解、算力放哪儿、权限怎么穿透。 口号一换,考卷也换了。
至于能不能答好,得看后面几年的项目,不是一场发布会能定的。这句我先记着。
三位伙伴上台,说的其实是同一件事
德索信息的张斌辉总讲期货核心交易系统。高并发、低延迟、高可靠,这三条是期货行业的硬指标,他给的结论是"性能不降级、业务零中断"。
东华医为的郭宝平总讲医疗,全场景联合方案,覆盖医疗核心业务链路。
ICO Limited 的 Raymond Yiu 讲香港,本地标杆项目的落地经验。
三个人三个行业,最后绕回同一个问题: 迁移这件事,客户最后问的不是"功能有没有",是"切过去那晚出不出事"。 这也解释了为什么发布会的重头戏是产品,压轴的却是案例。
三位伙伴讲完,上午的议程就结束了。方向和位置都讲到了,剩下的问题是代价,得往下拆。
二、三样东西换了位置
发布会的三条能力,翻译成技术语言,是三样东西挪了地方。
| 能力 | 原来的位置 | 现在的位置 | 挪动的实质 |
|---|---|---|---|
| 库内语义 | 应用代码注释、数据字典文档、独立语义层 | 表与字段的元数据,与数据同库 | 语义从"文档"变成"可查询的结构" |
| 库内计算推理 | 外部 Embedding 服务 + 外挂向量库 | ONNX Runtime 进库,SQL 调用 | 推理从"服务"变成"算子" |
| 库内安全 | 数据库一套权限 + 外挂库自己一套账号 | 一套身份、权限、标签、审计覆盖全部 | 权限从"两套"变成"一套" |
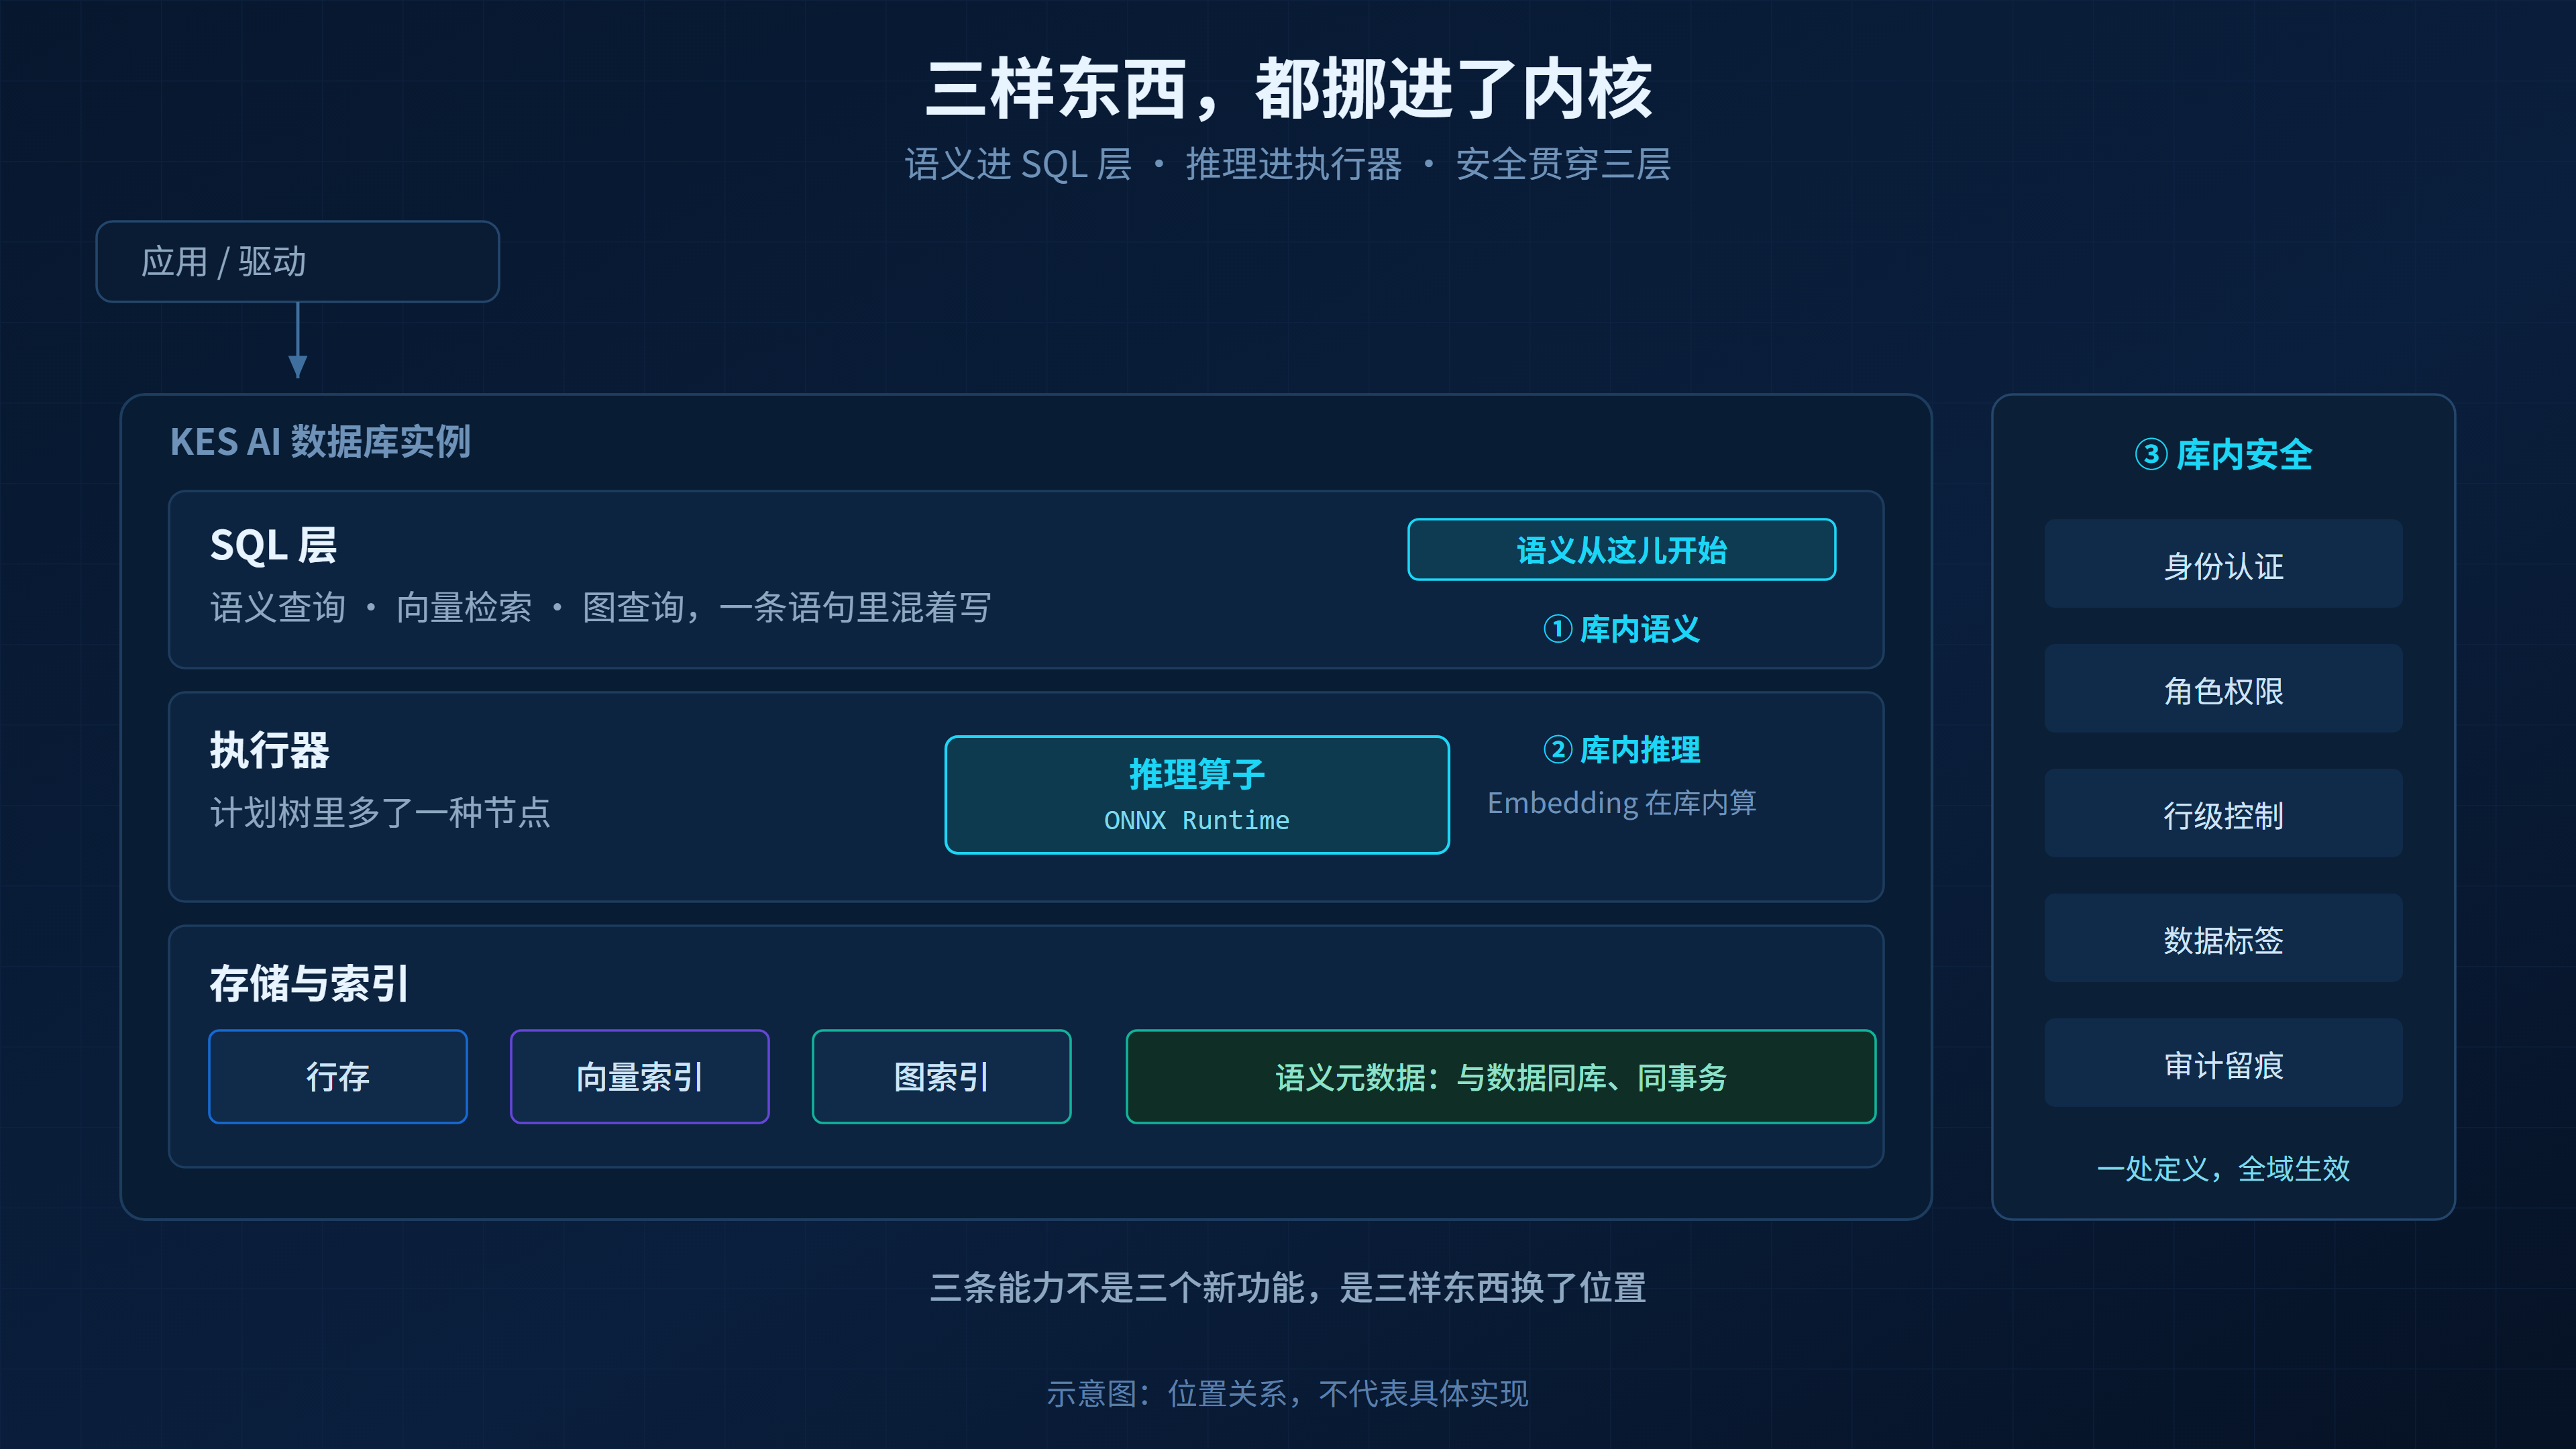
这张表看完,这次发布是什么路数就清楚了: 不是功能变多了,是位置变了。
功能变多,用户要学新东西;位置变了,用户原来那套东西的账要重算。
举个最直白的:原来数据库只负责存,检索的事交给外面的向量库,出了事两个团队一起查,谁也说不清是数据没同步还是索引没建好。现在检索进了库,责任归一处,听着是好事,可也意味着数据库出问题的时候,没人再能说"这不是我的活"。
位置一挪,账就换了。 后面几节,就是把这几笔账一笔一笔摊开。
三、模型不认识"客户"这两个字
先说语义。 这是三条能力里最不性感的一条,也是我觉得最要紧的一条。
"客户"这个词,一张表里可能指最终用户,另一张表里指签约的法人。字段名都叫
customer_id,值的格式也一样,模型分不出来。
再具体点。一张订单表,四十多个字段。
status 有七个取值:待支付、已支付、待发货、已发货、已完成、已取消、已退款。
业务方问一句:“上个月取消了多少钱?”
人一看就懂。模型看到的是:
status 这个字段里有一堆枚举值,
order_amount 和
pay_amount 两个金额字段,还有
create_time、
pay_time、
cancel_time 三个时间字段。
它不知道"取消"包不包括退款,不知道金额该用下单金额还是实付金额,不知道"上个月"该按哪个时间筛。
这不是模型笨,是没人告诉它。 而这件事,传统架构里从来没打算让机器知道。
语义散在三个地方,机器一个都拿不到
业务语义平时存在哪儿?
一是界面上的文案,"已取消"三个字写在按钮旁边;二是后台代码里的判断,
if status in (5,7) 这种;三是业务人员脑子里的口径,“取消不含退款,退款单算”。
人靠这三样拼出理解。模型一样都拿不到,它只有表名、字段名和一堆值。
所以现在做 RAG 的项目,前面都要加一层"字段说明",写在 Prompt 里或者配置文件里。项目小的时候够用,表一多就散架:改一个字段,配置文件没人更新,模型答出来的口径就是旧的。
外挂语义层的两个死法
有人会说,那搞个独立的语义层不就行了。行是行,我看过两个死法。
第一个死法:结构一变就失联。 数据库加了个字段、改了个类型,语义层不知道。它照着自己的旧副本答,答得还挺自信。
第二个死法:权限另开一套。 语义层自己有账号体系,跟数据库的行级权限对不上。等于又多一个要配、要审、要对账的地方。
还有第三种,不算死法但很常见:口径漂移。同一个"活跃用户",BI 那边一个定义,应用里一个定义,语义层里又一个定义,三个数对不上,开会先吵两小时。

库内的做法,以及我没看到的部分
金仓的做法是把这份说明书写进库里:用 SQL 给表、字段标注业务含义、相互关系、计算口径;系统先自动采集基础信息,AI 提建议,业务人员确认生效。
语义和数据同库、同事务、同权限体系,DDL 变更能被语义感知。 这一条是关键:语义不再是数据的旁注,是数据的一部分。
具体语法长什么样,这次没看到实例。等有环境了再补,这次只记它落在哪一层。
语义层的成本,九成在维护
建一套语义不难,一个肯干的实施顾问两周能标完一张核心表。 难的是三个月后它还准不准。
这事跟小区装门牌一个道理:装的时候一下午就装完了,掉了一块没人管,外卖就找不到楼。
我心里有三个问题,发布会没细讲:
第一,语义跟 DDL 怎么绑定? 改字段的时候是强制提醒,还是事后扫描发现?如果是事后,那和现在的文档没区别,只是换了个地方放。
第二,口径变更谁审? 业务口径改了,语义层跟着改,谁签字、留不留痕?没有这一层,语义层会变成第二个口径黑洞。
第三,答错了怎么发现? 用户问"取消了多少钱",答出来一个明显不对的数,这个反馈能不能反写回语义层?如果不能,语义层只会越用越旧。
这三个问题不是挑刺。语义层这东西,做得出来是一回事,养得住是另一回事。 数据治理项目死在第二件事上的,不在少数。
四、省下来的三笔账
语义说完了,说计算。"数据不出库"到底省了什么,得把账摊开算。
先把老链路摆出来:
抽取 → 清洗 → 切块 → 调外部 Embedding 服务 → 写外挂向量库 → 应用层拼装(向量召回 + 业务过滤 + 权限判断 + 回表)。
六个环节,跨好几个系统。这套链路我见过不少项目在跑, 能跑,就是每一段都要人看着。
| 账 | 老链路怎么花 | 库内怎么省 | 能不能真省 |
|---|---|---|---|
| 链路账 | 同步工具、ETL、向量库、缓存,四套东西各自监控、备份、升级 | 一套实例 | 省得最实在,组件少了运维就少 |
| 搬运账 | 每次向量化都要出库再回来,序列化、反序列化、网络往返 | 库内跑 Embedding,数据不动 | 省,但要看推理放 CPU 还是 GPU |
| 兜底账 | 业务数据改了,向量库靠 CDC 追;追不上就答昨天的数据 | 同事务,改状态即失效 | 省,前提是向量化在写入路径上,不是异步批处理 |
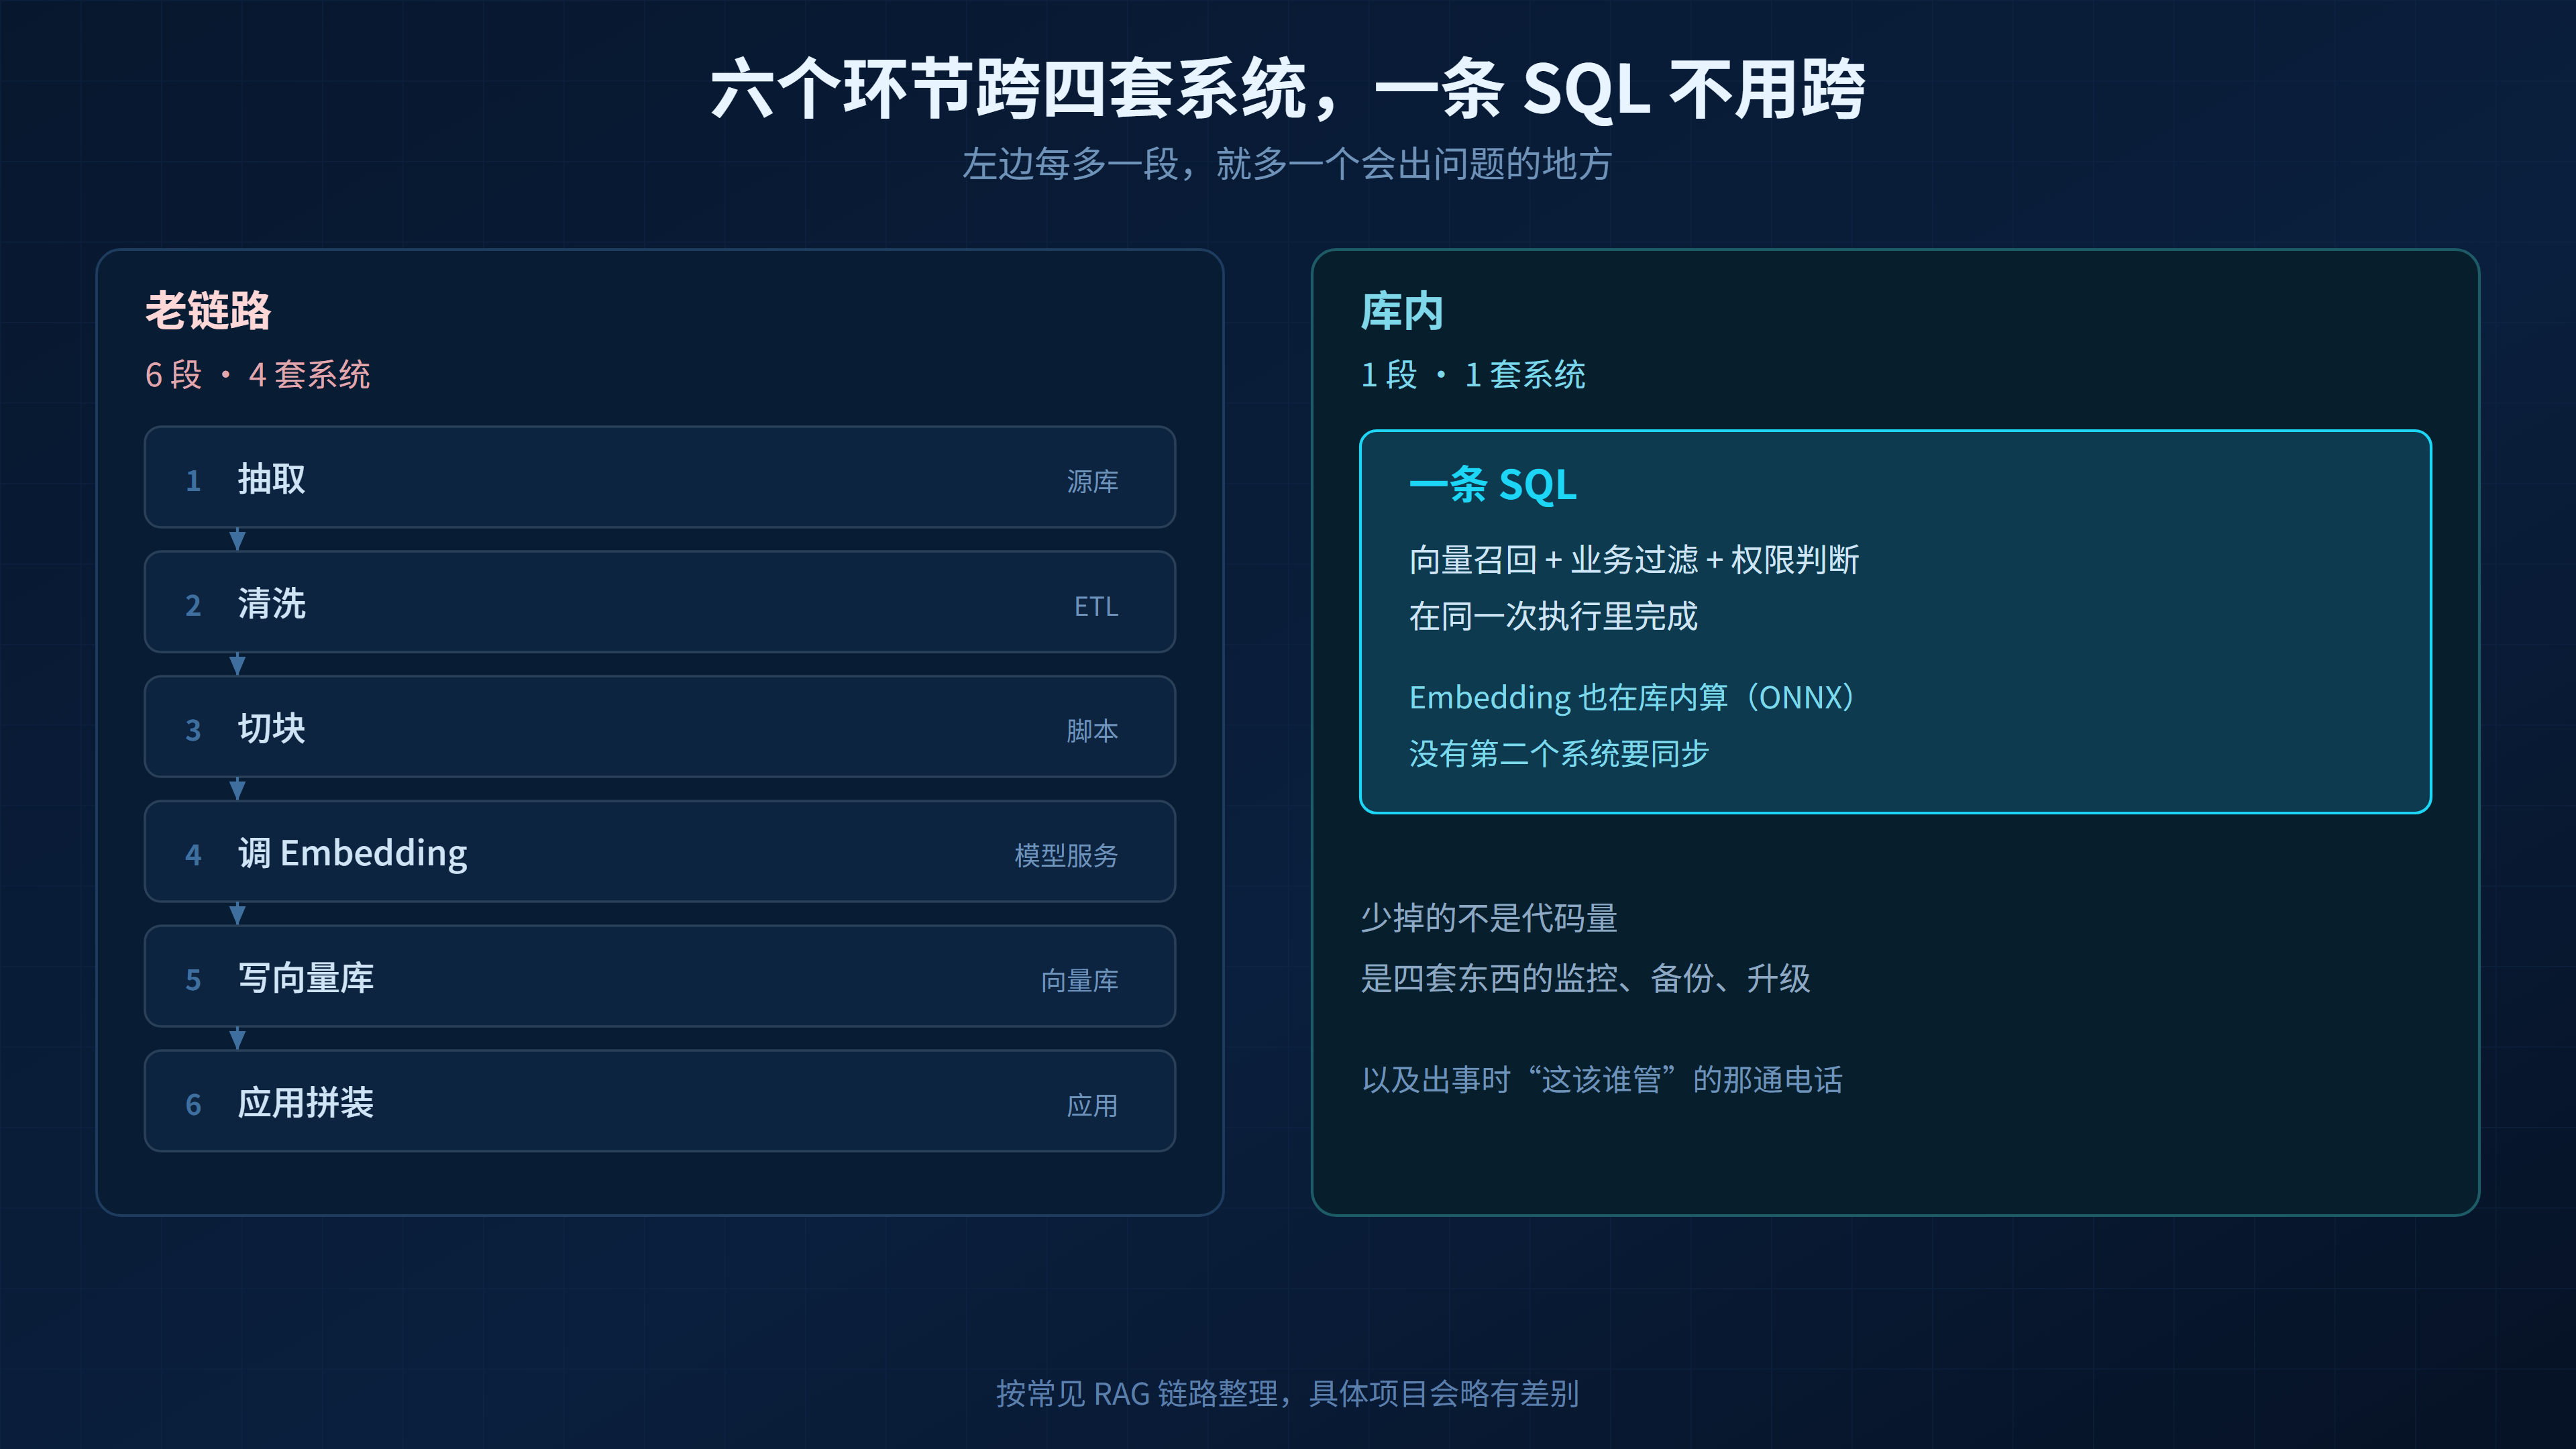
三笔账里,链路账最容易算,也最容易被低估。少一套组件, 省下的不只是服务器钱,还有"半夜报警了归谁管"这种事。
搬运账要看推理放哪儿。ONNX Runtime 进了库,Embedding 在库内算,数据确实不用出门;可要是模型跑在 GPU 上,数据还是得从共享内存搬到显存,这段路省不掉,只是不出机器。
兜底账是这三笔里最值钱的一笔,也最容易被说成"架构优雅"。
一个具体例子:文档下架
我在自己那场里举过这个例子。
知识库里一份文档要下架。老链路的动作是:业务库改
status,CDC 把变更同步到向量库,向量库删掉对应的向量。中间有几百毫秒到几分钟的窗口,在这段时间里,检索还能召回这份已经下架的文件。
用户看到的是什么?一份明确通知下架的制度文件,AI 还在拿它当依据回答问题。
库内的做法就一句话:
WHERE status='VALID' 和向量排序在同一条 SQL 里。没有窗口,因为压根没有第二个系统。
这跟性能没什么关系,问题出在一致性上。而一致性这件事,跨系统解决起来,成本比看上去高得多。
五、一亿条向量,三百个 G
发布会给了四个数字:1 亿条 768 维向量、98% 召回率、峰值内存开销降低 95.4%、查询延迟降低 80%。
数字挺唬人,但不说清怎么来的,就只是数字。 我把内存这笔账摆开算一遍。
先算裸向量
1 亿条 × 768 维 × 4 字节(float32)= 307 GB。
这还只是裸向量,没算任何索引结构。
HNSW 要在每个节点上存邻居表。M 取 16,第 0 层每个节点最多 32 条边,一条边 4 字节,1 亿条就是 12.8 GB;加上上层的边,实际还要再多一些。
也就是说, 光把数据放进去,一台 512G 内存的机器就去了一大半,索引还没建。
想在这个量级上用内存型索引,常规路子就一条:分片,堆机器。
DiskANN 换了个思路
DiskANN 这条路的做法是两段式:
向量先压成很短的定长码放内存,查询的时候用这层码粗筛出候选;再拿着候选去 SSD 上取原始向量精排。
说白了就是: 内存放索引,磁盘放数据,用 SSD 的随机读换内存容量。
内存占用掉一个数量级不奇怪。值得琢磨的是延迟为什么还降了:因为每次查询要去磁盘上读的页数是定向的,不是全量扫。 定向读和全量扫,在 SSD 上是两码事。

四个前提,缺一个数字就不成立
这组数字我一条条对着看,觉得有四条得跟着一起说:
第一,比的是内存,不是综合性能。 95.4% 指峰值内存开销,80% 指同一组条件下的查询延迟。两个数不能加起来当"性能提升一倍多",那是两回事。
第二,98% 召回是前提。 召回率往下放,任何索引都会更快,这个不用怀疑。条件必须跟着数字走,不能单独拎出来说。
第三,对比基线没公开。 发布会上说的是"较业界",没说是哪套索引、什么硬件、什么参数配置。没有基线的百分比,只能当方向看。
第四,SSD 是硬成本。 省了内存,换来的是对存储的要求:随机读 IOPS、容量、寿命。这笔账要单算,不能只看内存省了多少。
这组数我没在机器上复现过,条件就照原样摆在这儿。 把条件写清楚,比记住百分比有用。
六、这条线只画到检索
第三条能力是安全。这块最容易在传播里被简化成一句话。
出库那一刻,断的是四样东西
数据从数据库搬到外挂向量库,丢的不是"安全"这么一个笼统的东西,是四样具体的:
权限主体断了。 向量库里只有
doc_id 和向量,没有"谁在看"。同一个问题,A 部门的人问和 B 部门的人问,检索结果一样。
行级、列级规则断了。 数据库里配的 RLS 策略,外挂库不认,得在应用层重新写一遍。
脱敏断了。 字段级脱敏是在库内定义的,出了库就是明文。
审计断了。 查了哪条、谁查的、什么时候查的,两个系统各记一半,出了事拼不起来。
这四样,做过等保的人应该都熟。 只要数据出库,它们就一定会断,没得商量。
库内怎么接上
金仓的说法是:语义查询、向量检索、图访问,都算"对本库数据的访问",所以走同一套身份认证、角色权限、行级控制、数据标签、SQL 防火墙、操作审计。
一套规则,一处定义,全域生效,日志集中在一处。
这个道理是通的:只要检索发生在库内,它就是一次数据库访问,权限体系天然覆盖得到。
但这条线,只画到检索为止
把这条链路画出来就很清楚:
[库内] 原文存储 → 向量化 → 索引 → 检索 + 权限过滤 + 脱敏
        ↓(这一步之后,数据以"上下文"的形式离开数据库)
[库外] 拼 prompt → 调大模型 → 生成回答
检索结果拼进 prompt、发给外部模型的那一刻,数据还是出去了,只是换了个形态:从"表里的行",变成"上下文里的几句话"。

所以"数据不出库"管住的是"取数"这一段,管不住"用数"这一段。
这不是挑刺,是把话说完。库内安全解决的是"谁能在库里看到什么",不解决"什么可以被发给模型"。 两件事都做完,才算把这件事做完。
要补的那一层
想把这件事做圆,还得再加一层策略: 哪些字段允许进 prompt,哪些必须脱敏后进,哪些根本不进。
这一层现在得应用侧自己定。数据库能提供标签、能提供脱敏视图、能提供审计,但"允许带出去什么"是业务决策,不是数据库能替人拍的板。
我见过有项目在这上面栽跟头:库内权限配得很细,检索结果一进 prompt 全带上, 前面做的功夫白搭。
私域数据那笔账
通稿里有句话,说大部分企业的私域数据从来没被分析过。具体比例我没找到原始出处,就不引了。
但这个判断本身,做过项目的人应该有体会:一家企业十几套系统,同一份客户信息在三套表里长得不一样, 连自己都没盘清楚,更别说让模型用。
语义这件事的价值,一半在"让模型看懂",另一半在"逼企业把自己的账先理一遍"。 后面这一半,通常没人提。
七、分会场里听到的几个词
上午讲位置,下午讲实现。实现这部分,是我觉得整场会最值的。
多模检索,落到操作上是四种组合
分会场的投影上,多模检索被拆成几种具体组合:
- 文搜文:问题转向量,跟文档向量比
- 图搜图:以图搜图,走的是图像向量
- 文搜图:文字描述找图
- 向量 + 全文一起参与排序
主会场说"多模",到底怎么用,分会场给了答案:四种组合,每种都能落成一条查询。
这四种组合,恰好是外挂向量库最难拼的四种。 每多一种模态,应用层就多一次跨库拼装,多一个 ID 对不上的风险。放在一个库里,就是多一个字段的事。
DiskANN 也现场演示了,大规模向量下的构建和检索,数据量给得不小。
PL/AI:AI 从"接口"变成"SQL 函数"
笔记记得最多的是这块,因为它跟 DBA 的日常直接相关。
演示里出现的包,能看出路子:
pkg_ai_agent 管 Agent 相关的过程,比如
agent_resolve_case 这类;
pkg_htap_analyzer 管分析,形如
ai.predict(sales_trend)。
真正的变化是调用位置:从接口层挪到了 SQL 层。
原来是:写个 Python 服务,连 SDK,调模型,拿结果回写数据库。中间隔着一层应用,权限、事务、审计都在这一层断一次。
现在是:一条 SQL,跟事务、权限、执行计划在同一层。
对 DBA 的影响很具体:
以后的执行计划里会出现推理算子。 你看
EXPLAIN,除了 Seq Scan、Hash Join、Sort,还得多认几个节点。这几个节点慢,是索引没建好,还是模型加载慢,得分开判断。

这个变化不算小。 以前 DBA 调优,调的是数据怎么读;以后可能要调"模型在哪加载、推理批多大"。
我在自己那场里列的一个必答题
换 embedding 模型,索引怎么办?
这是我在准备自己那场 PPT 时卡住的问题,后来干脆把它列进了"一线问答"那一页。
原因很简单: 维度变了,语义空间也变了,旧索引没用了,只能重建。1 亿条重建要多久、期间业务怎么降级、能不能双写过渡,这一串问题全得答。
分会场给的思路是:模型版本进元数据,索引跟模型版本绑定。 思路对,但没给重建耗时的数字。
这个数字很关键。几十万条重建是分钟级,一亿条可能就是小时级,中间业务怎么撑,是另一套方案。等有环境了,这个我打算自己测一遍。
八、客户不会为一个架构买单
前面讲的都是能力,最后说点实际的: 客户凭什么买单。
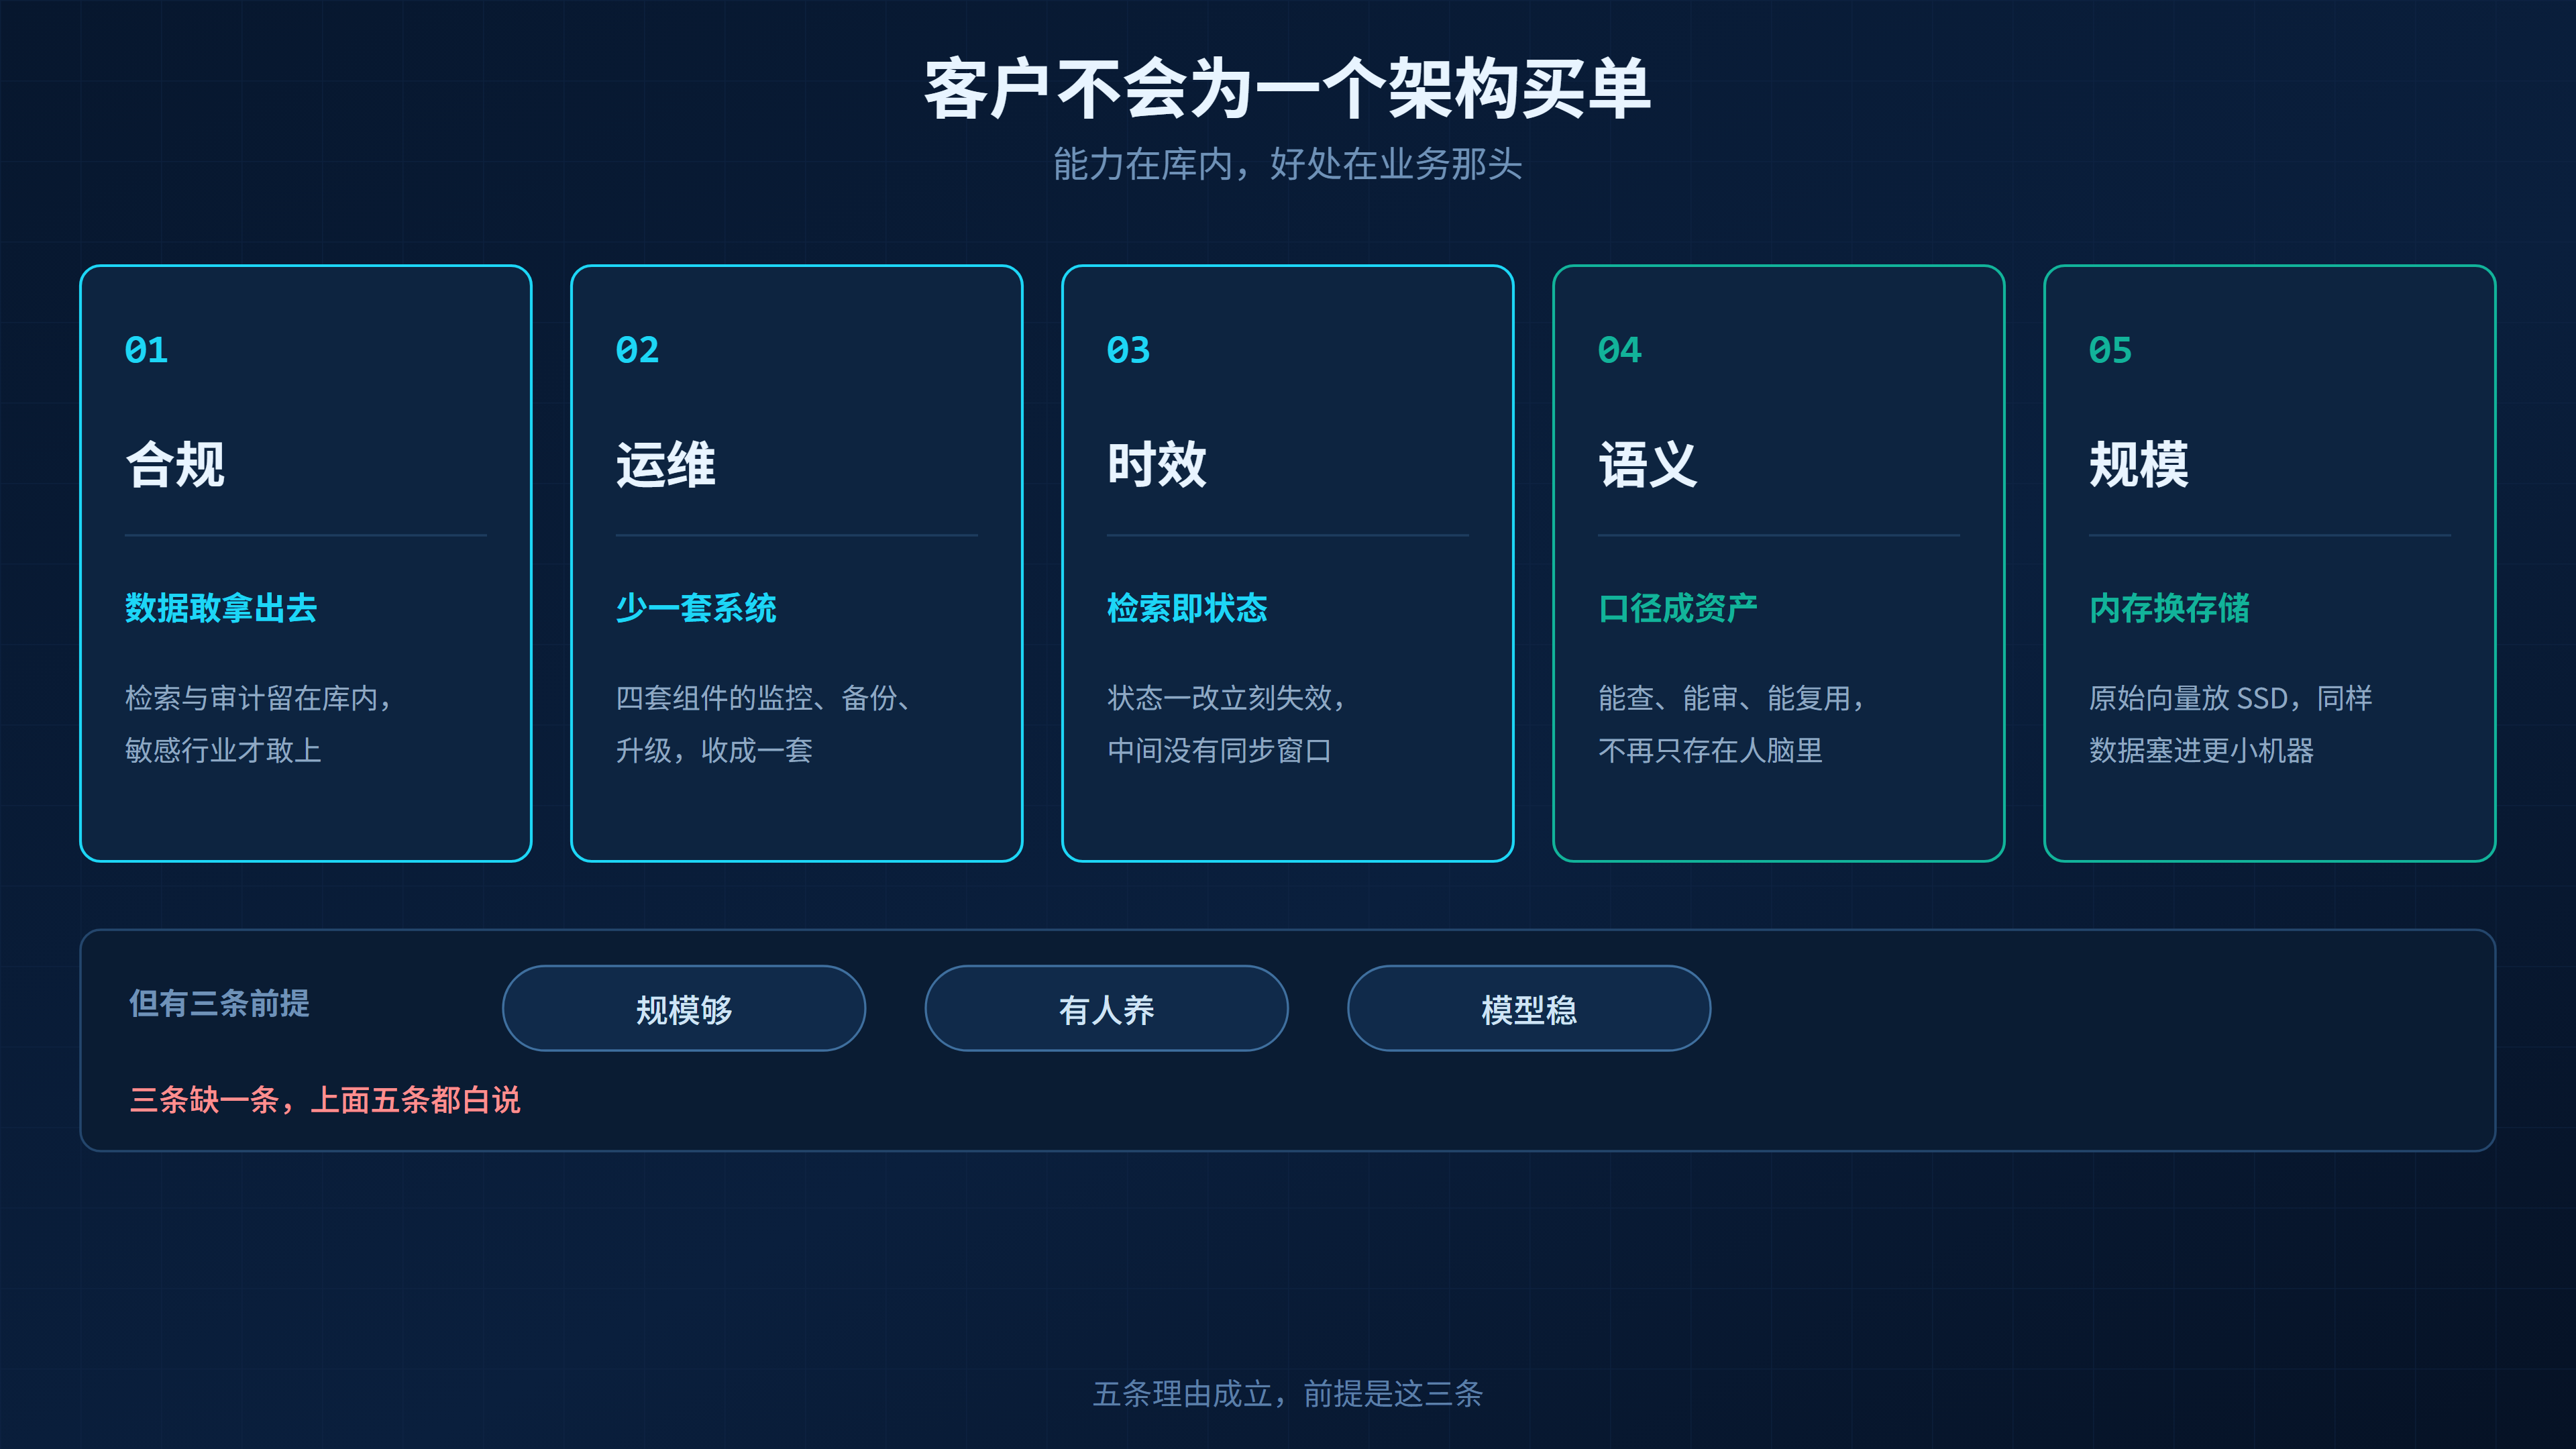
先过合规这道门
金融核心、医疗、政务这三类客户,AI 应用的卡点从来不是模型够不够聪明,是数据敢不敢拿出去。
检索、向量化、图构建都在库内完成,权限体系天然覆盖得到,审计日志留在一处。等保要的那些留痕,不用为一个外挂向量库再补一套。这一条对敏感行业是入场券,谈不上加分。
少一套系统,少一件事
原来那套系统里,同步工具、ETL、向量库、缓存,四样东西各有各的监控、备份、升级窗口。少一套,省的不只是机器钱。
更实际的是责任:出了问题只有一处要查,不用挨个部门问,是同步没到位还是索引没建好。
别让检索慢半拍
制度文件下架、价格政策作废、权限收回,这类"说变就变"的内容,最怕检索慢半拍。
库内做的好处是状态一改,检索立刻失效,中间没有窗口。用户不会拿到一份已经作废的文件,被 AI 当成依据继续答。
口径总得有个地方放
语义这条最容易被低估,因为它不产出任何性能数字。
语义写进库、跟数据同库维护,好处是它能被查、被审、被复用。新人接手不用先请老 DBA 吃饭问口径,模型也不用每次在 Prompt 里塞一份字段说明。
前提是有人管。没人管,三个月后它就是一份过期文档,只是换了个地方放。
内存的钱,换成存储的钱
1 亿条 768 维这个量级,内存型索引的路是堆机器。DiskANN 把原始向量放 SSD,内存只留压缩码,同一批数据能塞进更小的机器。
内存省下来是真金白银,代价是 SSD 的随机读和容量要求。这笔账划不划算,得看检索量和硬件报价,没有统一答案。
这三条站不住,五条都要打折扣
规模不够。 向量就几十万条、只有检索一个负载,独立向量库更简单,多养一套反而是负担。
没人养。 库内融合意味着数据库要扛推理,出了问题还是 DBA 背。团队没有 KES 运维经验、也不打算学,这个责任转移得提前说清楚。
模型不稳。 换 embedding 模型,维度和语义空间全变,索引只能重建。模型还在频繁试的阶段,先把模型定下来,再谈落地。
说到独立向量库,我不是说它不能用。 向量到了千万级、检索是唯一负载、有专人维护,这种场景它依然合适。 我的意思是别默认,先看手里这套撑不撑得住。
总结
回到发布会那句话:数据不出库,AI 也能用。
我想补半句: 前提是库内那套东西真的管得住,也养得起。
管得住,说的是语义层别三个月就过期、权限真的穿透到人、检索结果进 prompt 之前有人把关。养得起,说的是 SSD 的钱、算力的钱、把语义标一遍又一遍的人力,都得算进预算。
这次发布会把 AI 的活从库外搬到了库内,位置挪得挺果断。接下来要看的不是还能搬什么进来,而是搬进来之后,谁负责把它养好。
老规矩,知道写了些啥。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31466763/viewspace-3187472/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 胖头鱼的技术专栏-484 一个数据库大版本,凭什么要熬七年?(20261029)
- 胖头鱼的技术专栏-483 索引里也掺了水分(20261028)
- 胖头鱼的技术专栏-482 Oracle AI DB 23.26.4新特性一览(20261027)
- 胖头鱼的技术专栏-481 MySQL 替代怎么选?聊聊 OceanBase 集中式的五个优势
- 胖头鱼的技术专栏-480 交付和运维不是低价值岗位,离客户最近的人才懂业务
- 胖头鱼的技术专栏-479 如何高效地将喂给 AI 的数据搬过去(20261015)
- 胖头鱼的技术专栏-478 Agent 成了新用户,数据库要接住它的下一步(20261014)
- 胖头鱼的技术专栏-477 26ai新特性实战:表达式分区(20261013)
- 胖头鱼的技术专栏-476 26ai新特性实战:聚合过滤(20261012)
- 胖头鱼的技术专栏-475 蹭到最后,就没人摆摊了(20261010)
