导读:Apache Doris 5.0 多模湖仓预告(8)|技术解析篇:本文介绍了 Apache Doris 与 Lance 结合实现的关键优化——延迟物化(Lazy Materialization,两阶段读取)。该技术将仅用于最终输出的宽列推迟到 TopN 筛选之后按需读取,大幅减少落选候选的读取、解码与传输开销。实测表明,在亿级向量检索场景下,两阶段读取可带来 6 倍以上的端到端查询加速。
关联阅读: |
作者|李文强,SelectDB 多模湖仓负责人
已介绍过, Apache Doris 与 Lance 的结合,已经在大规模检索场景中展现出突出的性能。在此前的智能驾驶数据测试中,面对 10 亿规模数据上的向量检索与四条件过滤,Doris + Lance 用时 2.32 秒,Ray + pylance 用时 25.228 秒,耗时比约为 10.87 倍 。在同一规模下,Doris + Lance 的纯向量检索耗时为 0.43 秒,叠加时间过滤后为 0.73 秒。
Doris × Lance 的性能优势,来自查询规划、并行检索、提前过滤、按需读列和缓存等多项能力的协同。
本文聚焦其中一个重要的性能优化点: 延迟物化(Lazy Materialization),也称两阶段读取 。它将仅用于最终输出的列推迟到 TopN 之后读取,让大量落选候选不必承担完整的内容读取和传输成本。下面从一条检索 SQL 出发,看看这项优化如何贯穿查询规划、分布式执行和 Lance 数据回读。
为什么要晚一点读
假设 Lance 中有一张知识库表,包含 id、title、body 和 embedding。下面的 SQL 返回最相关的 20 条文档:
SELECT id
, title
, body
, _distance


FROM vector_search
(


"table"
=
"lance_catalog.demo.documents"
,


"column"
=
"embedding"
,


"query_vector"
=
"[0.1, 0.2, 0.3, 0.4]"
,


"metric"
=
"l2"
,


"top_k"
=
"20"


)


ORDER
BY _distance
ASC
;
这条查询最终需要返回文档 ID、标题、正文和距离,但这些信息的使用时机并不相同。
_distance 用于排序,需要在确定结果之前产生;title、body 在这个例子中仅用于展示,可以等结果选定后再读取。业务 id 是否需要提前读取,同样取决于它是否参与排序、过滤或其他计算,不能与检索距离一概而论。
如果在候选阶段就读取完整正文,大量最终落选的文档也会产生读取、解码和传输开销。分布式执行还会进一步放大这种成本:多个检索任务(split)分别产生本地候选,再由 Doris 合并为全局 TopN。每个 split 返回的候选,并不都会进入最终结果,但提前读出的正文已经随它们经过了 Arrow 转换、Block 传递和排序过程。
延迟物化改变了这个执行顺序: 先用必要的信息选出结果,再为选中的行补齐内容 。对于长正文、丰富属性等宽列,这意味着可以省去大量与最终结果无关的工作。
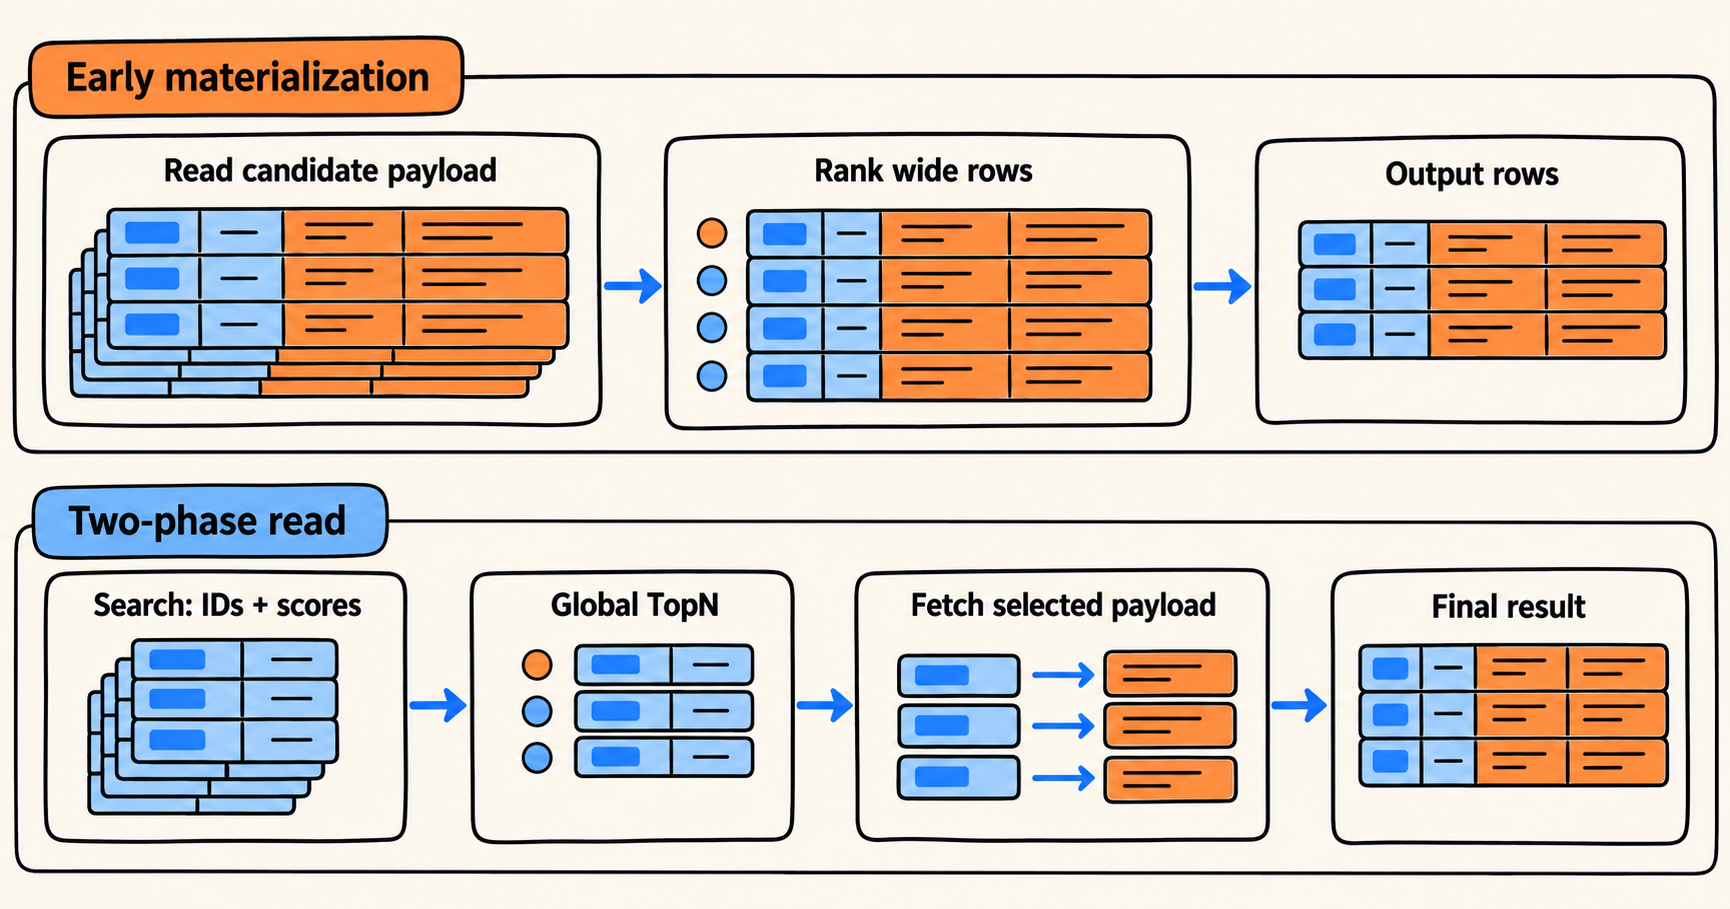
两阶段如何协作
两阶段读取由 Doris 的查询优化器、分布式执行框架和 Lance 的行级读取能力共同完成。
FE 负责识别可以延迟的输出列,并在物理计划中加入物化节点;BE 按照计划完成检索、过滤与 TopN,再根据保留下来的行定位信息,批量回读结果所需的列。
| 阶段 | 主要工作 | 携带的数据 |
|---|---|---|
| 第一阶段:筛选结果 | 生成候选,完成必要的过滤与排序 | 必须提前读取的列、距离或分数、隐藏行定位信息 |
| 第二阶段:补齐内容 | 按行 ID 批量回读,恢复结果顺序 | 选中行的可延迟输出列 |
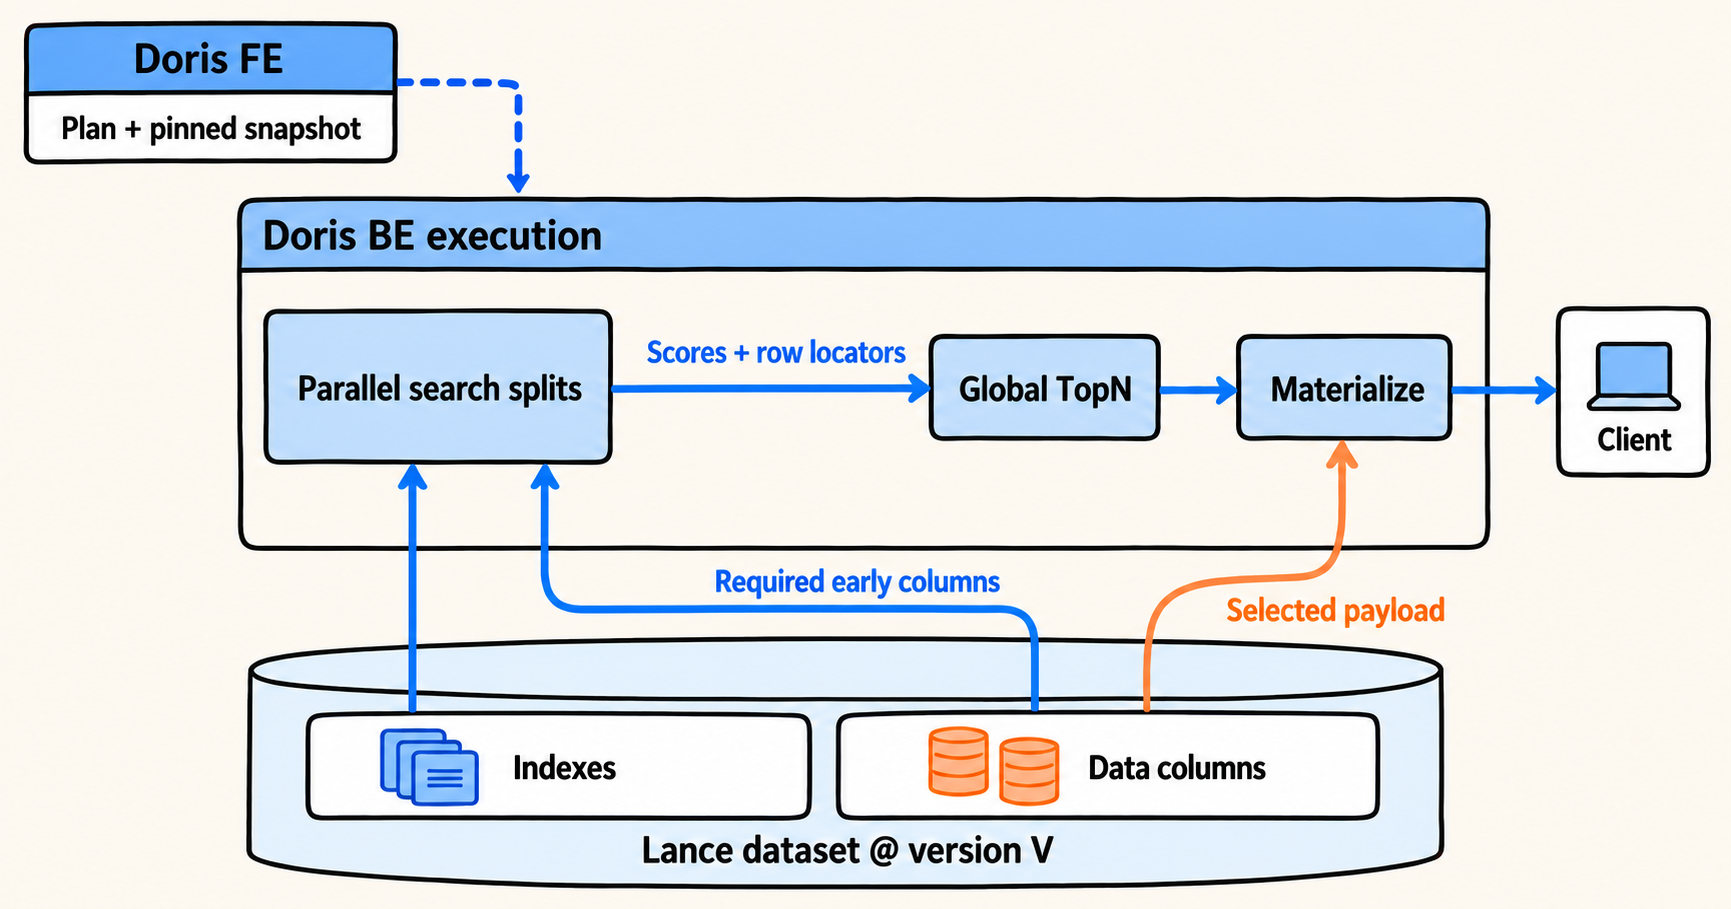
对于适用的查询,数据流可以概括为:
Lance search splits


  → required early columns + score/distance + hidden row locator


  → Doris filtering / local TopN / exchange / global TopN


  → Materialize: batch row-ID fetch


  → restore result order and assemble output
具体的 TopN、Exchange、Project 和 Filter 位置由执行计划决定。优化的关键是: 可延迟列不再随候选流转,而是在被优化的 TopN 完成筛选后,由物化节点补齐 。
这也引出了实现中的两个核心问题:哪些列可以延迟,以及选定结果后如何准确地读回这些列。
第一阶段:只读必需列
判断列的依赖
一列能否延迟读取,取决于它在执行计划中的用途。正文即使很大,只要参与了提前过滤或排序,也必须在相应算子执行前提供真实值。
在 Nereids 的物理计划后处理阶段,LazyMaterializeTopN 从 TopN 的输出列出发,追踪每一列的数据来源。MaterializeProbeVisitor 沿计划向下检查:该列是否被排序、过滤或其他算子提前使用,以及它能否追溯到支持回读的原始列。
参与 TopN 排序的列需要在排序前提供值;参与 Doris 侧残余过滤的列需要在过滤前提供值;Project 中需要提前求值的表达式,也会限制相关输入列的延迟。优化器还会处理别名与原始列之间的依赖,确保裁剪某一输出时,不会移除其他输出仍然需要的输入列。
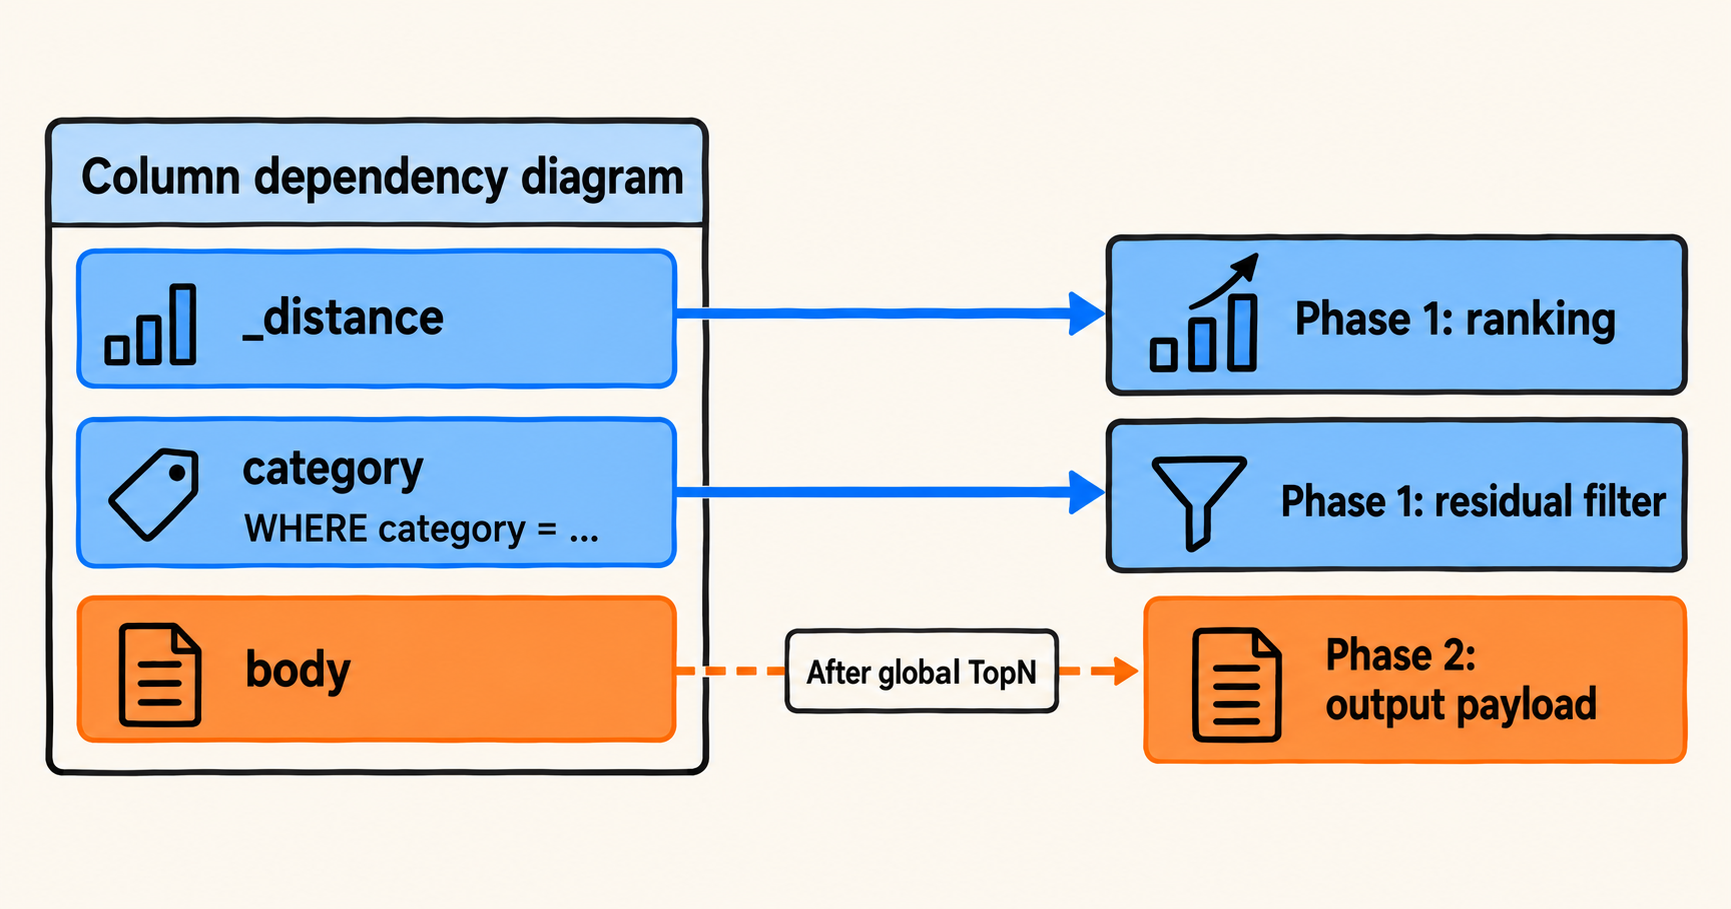
| 列的用途 | 处理方式 | 原因 |
|---|---|---|
| 向量检索的 _distance、全文检索的 _score | 保留在检索与排序阶段 | 它们是检索生成的结果值,不能作为普通数据列回读 |
| Doris 侧排序键、残余过滤所需列 | 提前读取 | 相关算子需要真实值才能筛选候选 |
| 需要提前求值的表达式输入列 | 按表达式依赖保留 | 表达式计算依赖这些列 |
| 仅用于输出的 title、body 等顶层列 | 满足条件时延迟读取 | 可以在结果选定后,从原始数据集按行 ID 回读 |
裁剪投影,保留定位
确定可延迟列后,LazySlotPruning 会调整扫描及上层计划的输出,将这些列从前面的数据流中移除,同时加入隐藏的全局行定位列。随后,优化器构造 PhysicalLazyMaterialize,记录需要回读的列、列所属的关系,以及各关系对应的行定位列。
BE 侧的 LanceTableReader 根据裁剪后的投影创建 scanner。需要支持后续回读时,通过 lance_scanner_with_row_id ( scanner, true) 请求 Lance 返回原生行 ID。转换器再将原生行 ID 封装为 Doris 内部的定位信息,使其能够跨算子、跨 BE 传递。
这样,候选行即使暂时没有携带正文,Doris 仍然知道它来自哪里,以及后续应该如何取回完整内容。
第二阶段:按需补齐结果
TopN 完成筛选后,第二阶段开始为选中的行回读输出列。这个过程需要同时保证读取效率、快照一致性和结果顺序。
固定快照,准确定位
Lance 返回原生 uint64 行 ID。Doris 使用带版本标识的内部定位结构,携带来源 BE、查询内的映射 ID,以及 Lance 行 ID。
其中,映射 ID 用于找到保存的扫描上下文,不等同于物理文件名;Lance 行 ID 也不能直接理解为 Parquet 或 ORC 文件中的行序号。
扫描上下文保存了数据集 URI、固定版本和存储访问选项。第二阶段通过映射恢复这些信息,打开与第一阶段相同的数据集快照。快照版本属于回读上下文,无需在每个行定位值中重复保存。
两阶段必须基于同一个快照解释行 ID 。第一阶段从版本 V 选出的行,第二阶段就应从版本 V 回读,不能临时打开 latest 后解释。为此,LanceTableReader::read_by_row_ids 要求使用固定版本,并通过共享的 LanceSessionManager 打开对应数据集。
分组路由,批量回读
Materialization 算子解码隐藏行定位列后,按来源 BE 组织 multiget_data_v2 请求。接收请求的 BE 根据映射找到原扫描上下文,再对同一映射内的行 ID 排序、去重,形成批量读取请求。
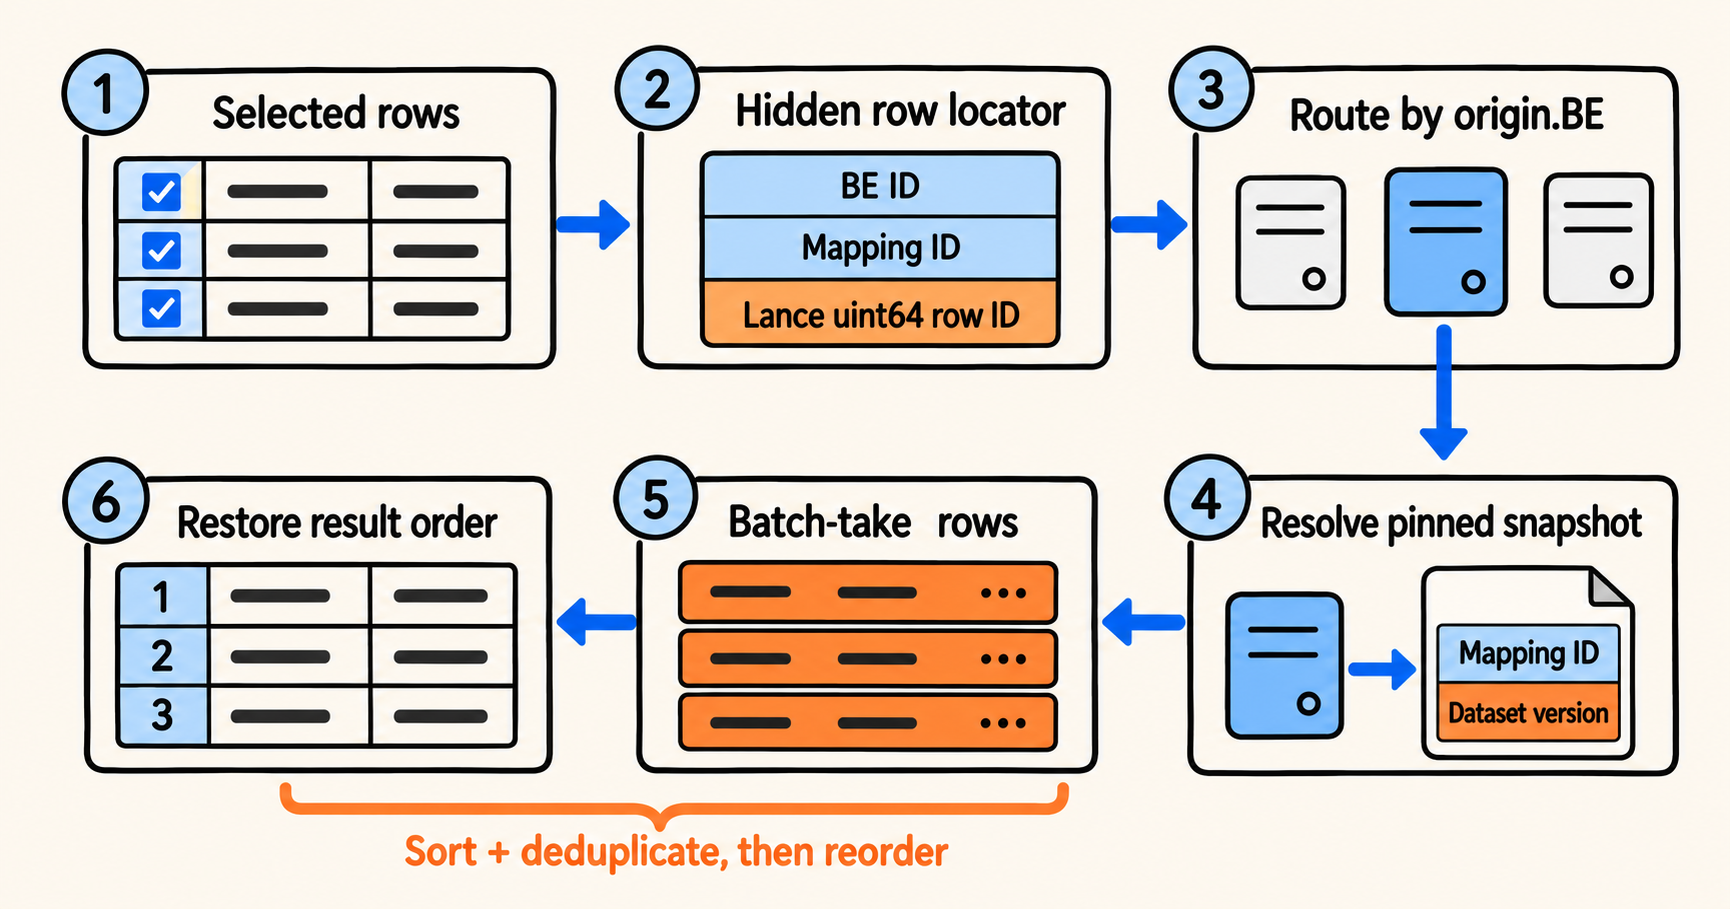
进入 Lance 专用分支后,RowIdStorageReader 通过 LanceTableReader::read_by_row_ids 调用数据集级接口,按行 ID 获取所需列,无需重新创建普通 FileScanner 扫描产生候选的 fragment:
lance_dataset_take_rows(


dataset,


row_ids.
data(),


row_ids.
size(),


projected_columns,


&
arrow_stream


);
这里的 projected_columns 只包含第二阶段需要补齐的列。SDK 返回 ArrowArrayStream,Doris 将其导入 RecordBatchReader,逐批消费并转换为 Doris Block。
Lance 的部分读取可能在消费 Arrow 流时才真正执行,因此测量回读耗时时,需要同时覆盖接口调用和后续 ReadNext。共享 Session 可以复用相应的元数据与数据缓存,第二阶段仍需承担数据集打开、行 ID 请求、存储读取、解码和格式转换等成本。
恢复顺序,组装输出
行 ID 排序、去重能够优化回读组织方式,但会改变存储读取顺序;不同 BE 的响应也可能先后到达。
Doris 因此维护输出行与回读位置、来源 BE 之间的映射,将返回的数据重新组装为 TopN 原本的输出顺序。同一个回读分组内的重复行 ID 可以只读取一次,再映射到多个输出位置。
实现还会检查回读行数与请求行数是否一致、各输出列的行数是否一致,并校验多 BE 响应中的行数,确保补回的列值始终与行身份、数据快照和排序结果对应。
性能收益来自哪里
延迟物化的直接收益,是减少落选候选的宽列读取,并让这些宽列更晚进入执行链路。
可以用一个简化模型理解它的作用。假设多个 split 共生成 C 条需要携带输出列的候选,最终选中 K 行,每行可延迟输出列的逻辑大小为 W:
Early payload volume ≈ C × W


Deferred payload volume ≈ K × W


Avoided payload volume ≈ (C − K) × W
这个模型只描述可延迟输出列的逻辑数据量,不包含索引和向量精排读取,也不等同于对象存储实际下载量。页或块的读放大、压缩、缓存、行定位信息和回读 RPC 等因素,都会影响真实执行成本。
例如,16 个 split 各自产生 20 个候选,全局最终保留 20 行,每行正文为 4 KiB:
| 读取方式 | 正文逻辑数据量 |
|---|---|
| 为 320 条候选提前读取正文 | 320 × 4 KiB = 1 . 25 MiB |
| 只为最终 20 行回读正文 | 20 × 4 KiB = 80 KiB |
在这个示例中,需要物化的正文逻辑量降至原来的 1/16 。这是说明原理的模型,并非性能实测;它不能直接换算为查询加速倍数或对象存储下载量。
在实际执行中,减少数据量会作用于多个环节:
-
读取与解码 :落选候选的可延迟输出列无需提前读取和解码。
-
传输与搬运 :中间 Block 更小,跨节点传输和内存搬运的数据更少。
-
排序过程 :宽列无需随大量候选经过 TopN,降低中间数据处理开销。
因此,当候选数明显多于最终结果数,且输出包含长正文、丰富属性等宽列时,延迟物化更有机会带来明显收益。
| 更容易受益的场景 | 收益可能有限的场景 |
|---|---|
| 输出列较宽,最终 Top-K 较小 | 只输出距离、分数或少量窄列 |
| 多个 split 产生大量候选 | 候选数已接近最终结果数 |
| 输出列仅用于最终展示 | 多数列需要提前参与过滤、排序或计算 |
| 读取、解码或传输开销较高 | 主要瓶颈在 ANN 计算、精排、Prefilter 或排队 |
对于带 OFFSET 的查询,每个搜索 split 可能需要提供 top_k + offset 个候选,而最终只输出 top _ k 行。延迟物化也可以减少被跳过行的输出列读取,但候选生成、排序与跳过操作仍然存在。
实际收益由省下的读取、解码和传输成本,以及新增的回读、RPC 和结果重组成本共同决定。
两阶段读取的实测收益
将输出列的读取推迟到 TopN 之后,能够明显减少候选阶段的无效工作。在我们内部性能测试环境中,我们进行了开关两阶段读取的对照实验, 纯向量检索、向量加时间过滤、向量加时间与传感器数组过滤这三组查询,都从数十秒降到了数秒,直观展示了两阶段读取的优化效果 。
亿级数据上的开关对照
测试基于
doris-4.1.5-release-c7f95adaaa
,包含
104,343,874 行数据(约 1.04 亿行)
。集群由 1 FE、2 BE 组成,每个 BE 配置 32 核 CPU、128 GB 内存和 1 TB 存储;标量与向量索引均包含 15 个 index segment。
三组查询均使用
vector_search
,按 L2 距离排序,设置
nprobes = 128
、
use_index = true
、
top_k = 20000
,并返回全部列,包括向量列。其中,带传感器条件的查询使用 Pandar128 数组过滤。
测试分别关闭和开启
enable_lance_lazy_materialization
,每组开始前重启集群,每条 SQL 连续执行三次。下面分别比较首 次执行耗时(cold)与三次执行的最小耗时(min),加速倍数按“关闭耗时 ÷ 开启耗时”计算。
从数十秒降至数秒
首 次查询:加速 4.74~6.29 倍
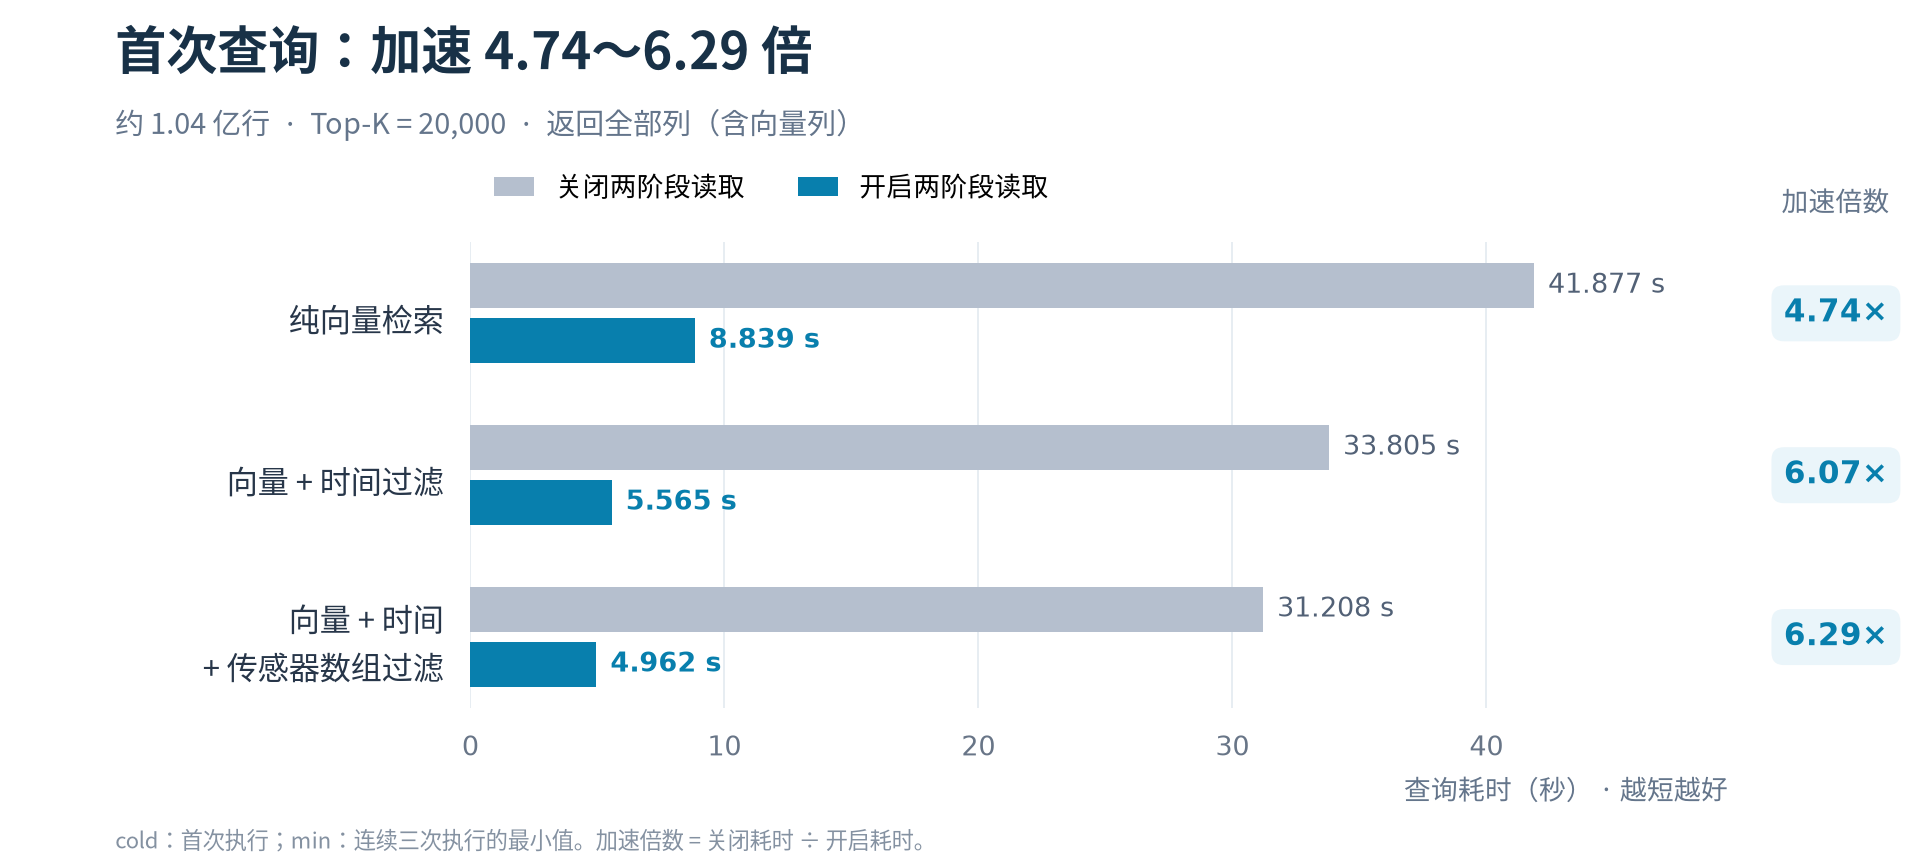
纯向量检索的首 次耗时从 41.88 秒降至 8.84 秒; 加入时间过滤后,从 33.81 秒降至 5.57 秒 ;再叠加传感器数组过滤,则从 31.21 秒降至 4.96 秒 。三组查询的耗时降幅达到 78.9%~84.1% ,过滤与两阶段读取结合的场景同样获得了明显收益。
三次执行的最小耗时:加速 6.49~6.64 倍
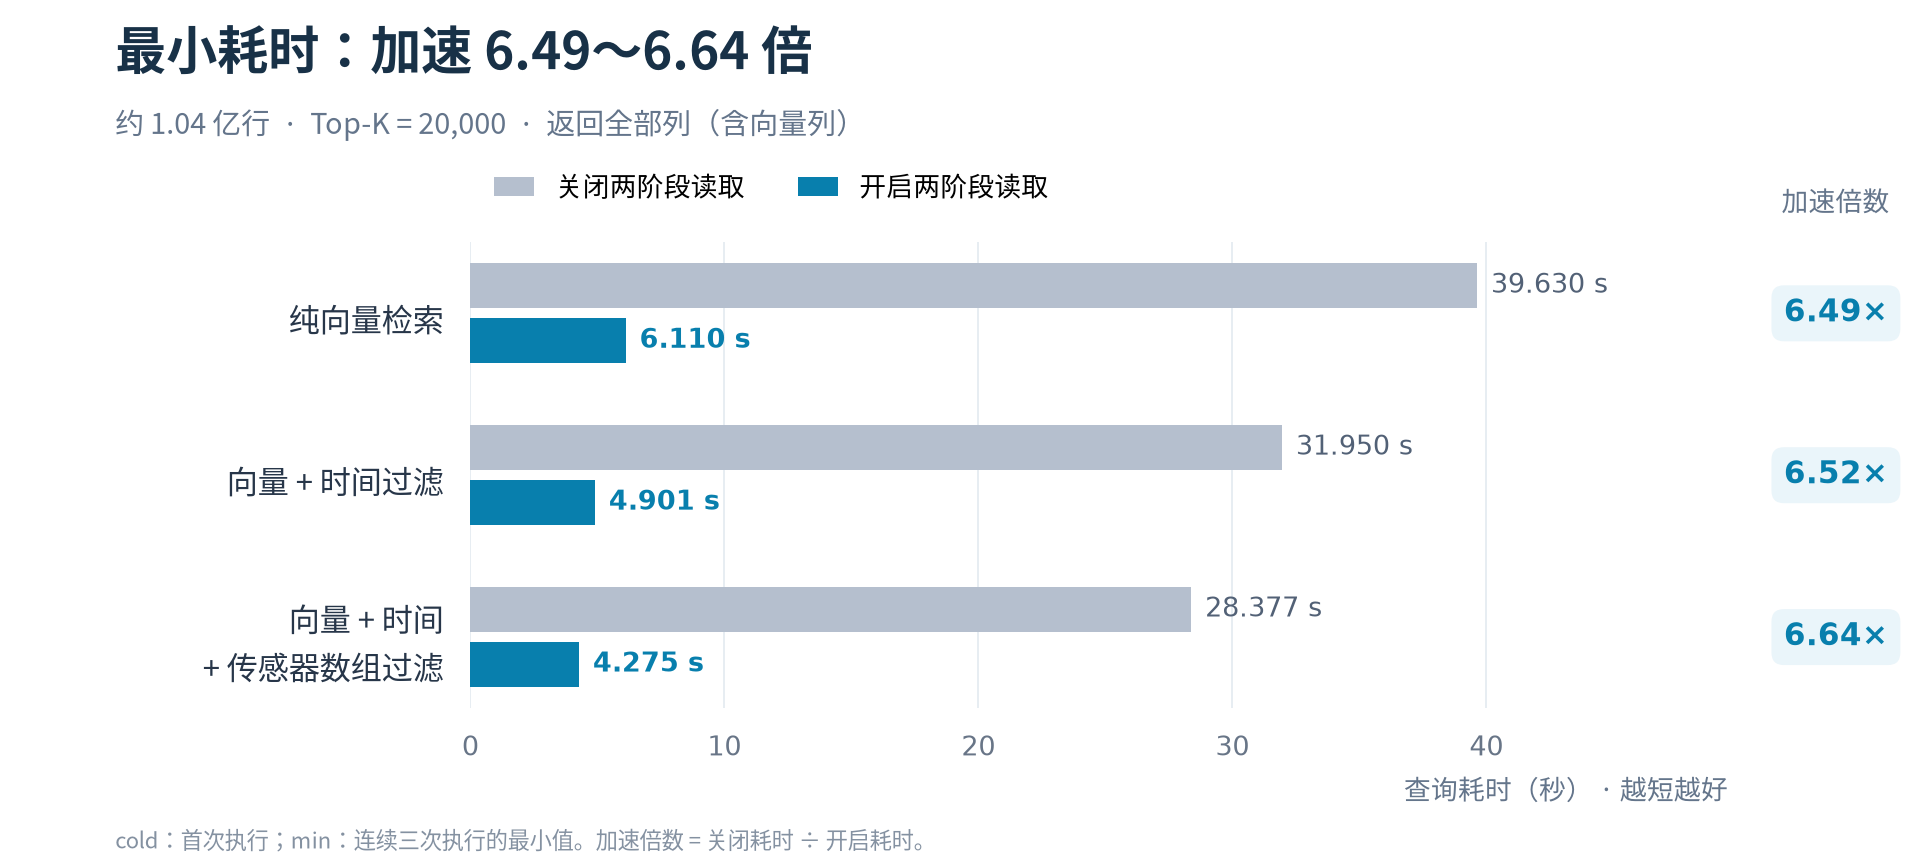
重复执行后,三组查询仍保持了相近的加速幅度:最小耗时分别从 39.63 秒、31.95 秒、28.38 秒 ,降至 6.11 秒、4.90 秒、4.28 秒 ,耗时降低 84.6%~84.9% 。两阶段读取的收益在首 次执行和重复执行中都得到了体现。
收益来自减少候选阶段的无效工作
这三组查询既要检索和排序,也要返回包含向量列在内的完整结果。多个检索任务产生的候选需要经过合并与筛选,其中只有一部分能够进入最终 Top-K。如果过早读取仅用于输出的列,落选候选也会承担相应的读取、解码和传输成本。
两阶段读取把这部分工作推迟到结果选定之后:第一阶段携带检索、过滤和排序所需的信息,以及用于回读的行定位;第二阶段再为选中的行补齐可延迟输出列。这样,完整输出列的处理规模就更接近最终结果,而不是中间候选规模。
上述对照展示了这一执行方式在实际查询中的价值: 即使 Top-K 设为 20,000,返回全部列的向量检索仍能获得显著加速 。对于既要求检索速度、又需要交付丰富结果内容的应用,延迟物化让快速筛选与按需读取衔接得更加紧密。
总结
Apache Doris × Lance 的高性能,建立在整条查询链路对无效工作的持续削减之上:并行检索充分利用计算资源,提前过滤缩小搜索范围,按需读列减少数据访问,缓存降低重复读取成本。
延迟物化进一步将这种优化推进到列的读取时机:Doris 优化器识别可以延后的输出列,分布式执行框架携带稳定的行定位信息,Lance 再基于固定快照和原生行 ID 批量补齐内容。三者协同,让宽列读取更贴近最终结果规模,减少落选候选带来的额外开销。
对于需要返回正文、属性等丰富内容的检索应用,这项能力连接了快速筛选与完整结果交付。 先筛选,再补齐,让每一次读取尽可能服务于最终结果——这正是延迟物化为 Doris × Lance 带来的性能价值 。 该功能预计在即将发布的 Apache Doris 4.2 版本中提供体验,敬请关注后续
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70017904/viewspace-3186963/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Apache Doris Summit 2026 盛大落幕,开启 Agentic AI 时代数据新范式
- 从实时入库到实时可用:Apache Doris 5.0 增量计算场景与实践
- Apache Doris 基于 Lance 的向量检索深度解析
- Apache Doris x Fluss:面向湖流一体的统一查询与分析
- Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
- StarRocks 迁移至 Apache Doris 完整指南:三步完成结构、数据与业务平滑切换
- 快手基于 Apache Doris 千亿多模态检索的实践
- 某头部保险公司基于 SelectDB 的统一 OLAP 架构实践
- Doris 直查 Paimon 索引:快手湖上向量检索的共建与落地
- Apache Doris+ Paimon 2.0:构建 Agentic AI 数据闭环
