把 seekdb 接入 Agent - 企业级数据库实践
今天我分享的是 seekdb 的一些理解,以及我自己的智能体项目 Agent-Hub 的落地实践。我会按三个视角来讲:用户关心什么,企业如何看待这些技术,以及我把 seekdb 接进 Agent-Hub 后遇到了哪些实际问题。大家好,我是周鹏,也是「老周聊架构」的主理人。目前我在一家物流科技企业从事研发和架构相关工作,有十多年的研发经验,平时也经常参与社区交流。取这个名字,是希望自己到了四十岁、五十岁,仍然热爱技术,愿意出来和大家分享。
一、从用户视角看定位、接入与部署
今天,我们先从基础的定位讲起。
用户接触 seekdb [1] 时,通常会先关心它和 OceanBase 的关系。OceanBase 是企业级分布式数据库,具备 HTAP 能力,能够同时支持事务处理和分析处理;seekdb 更侧重 AI 原生、轻量化,以及智能体应用的数据需求。我在做智能体时,会比较关注它把关系数据、向量检索和全文检索放在一起的能力。
另一个直接影响接入成本的因素是协议兼容。seekdb 对 MySQL 协议和常用开发方式的兼容,让已有 MySQL 使用经验的团队更容易接入。现场也聊到了未来扩展 PG 协议接入的想法。对企业而言,引入一个数据库,除了看功能,还要看现有驱动、工具和开发经验能否继续使用。如果每个环节都要重新学习、重新适配,采用成本就会增加。
OceanBase 的分布式部署要处理多个节点之间的数据一致性,需要用 Paxos 协议保障多副本协同。这也是企业级分布式数据库需要承担的工作。像 Paxos、Raft 这些大家熟悉的分布式一致性协议,解决的就是这类问题。
seekdb 走的是更轻量的路线,运行形态包括嵌入式和服务器模式。至于生产环境的高可用,我这里讨论的是主备部署的设计思路:主节点承载业务,备节点保留数据副本,故障检测、流量切换和恢复流程由部署侧配套。实际采用前,还要确认所用版本、复制方案和切换工具的能力。
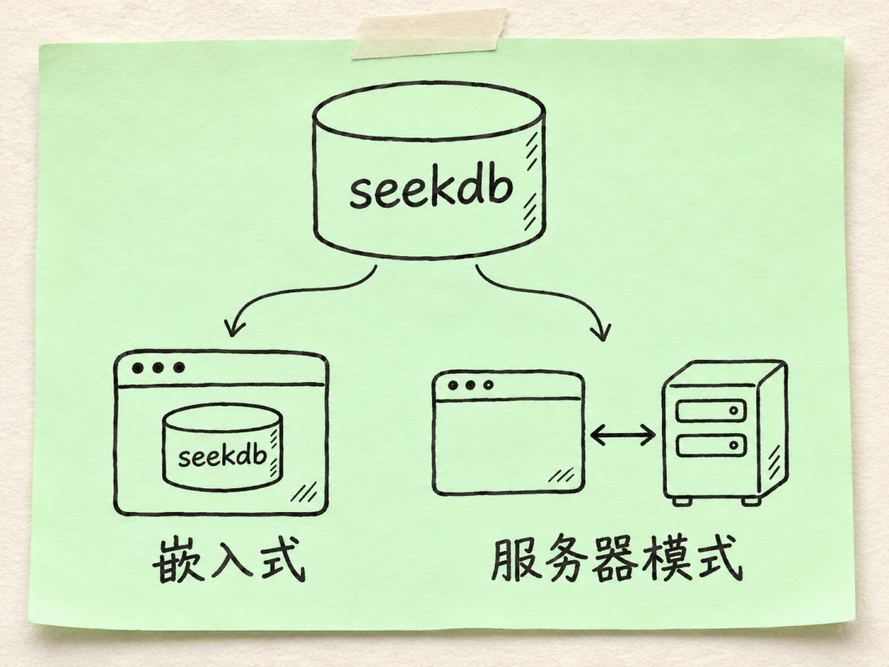
在接入层,我建议通过 VIP、DNS 或 Proxy 提供相对稳定的入口,避免把某台机器的 IP 地址直接写死在应用里。如果团队熟悉云原生,可以考虑用 Kubernetes Operator 等方式编排;在云上,也可以结合相应的云服务。比如健康探针发现某个节点故障,部署系统再按预定流程处理节点切换和流量接入。这里需要把检测、切换和客户端重连一起考虑,才能尽量减少业务受影响的时间。
我想强调,轻量化仍然可以保留面向 AI 应用的数据能力。和 SQLite、DuckDB 这些大家熟悉的轻量数据库相比,我关注 seekdb 的原因,是它的向量检索、全文检索、AI 函数,以及与 MySQL 开发习惯的衔接。嵌入式形态也给了我们把这些能力随应用交付的选择。具体用哪一种,还是要结合应用需要,不能只比较一个安装包的大小。
二、边写边读,要一起看性能和索引可见性
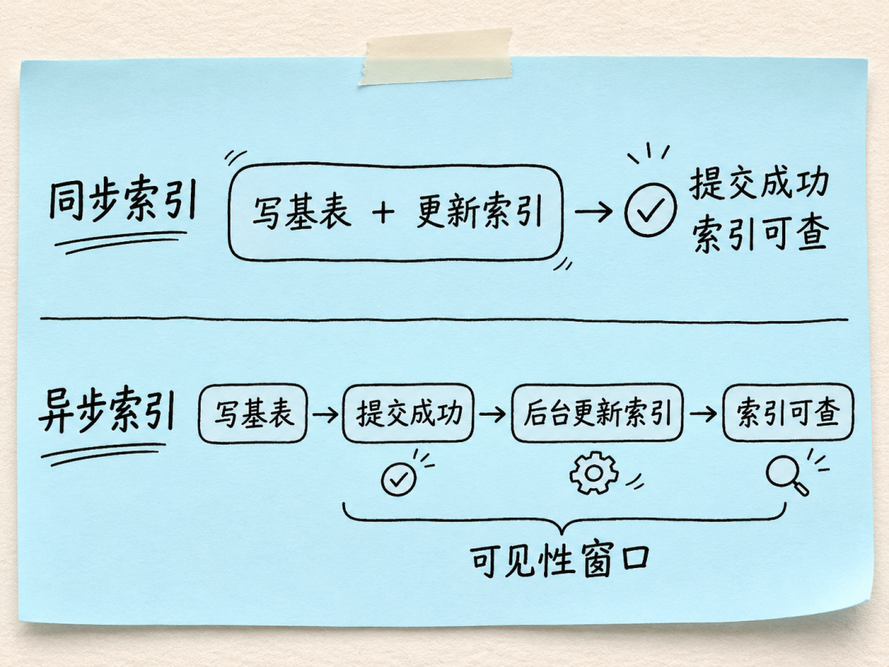
接下来,我想说一下异步向量索引。智能体的数据会不断写入,业务又希望及时检索到这些数据,因此索引维护会直接影响写入和查询的表现。
同步索引会把对应的索引维护纳入写入提交路径,提交后可以检索相应的更新。异步索引则让基表先提交,再通过变更流更新索引,以减轻索引维护对写入路径的影响。它带来的一个要求是:我们必须区分基表已经提交和向量索引已经可查这两个时点。异步路径存在索引追平的窗口,业务是否接受这个窗口,要提前说清楚。
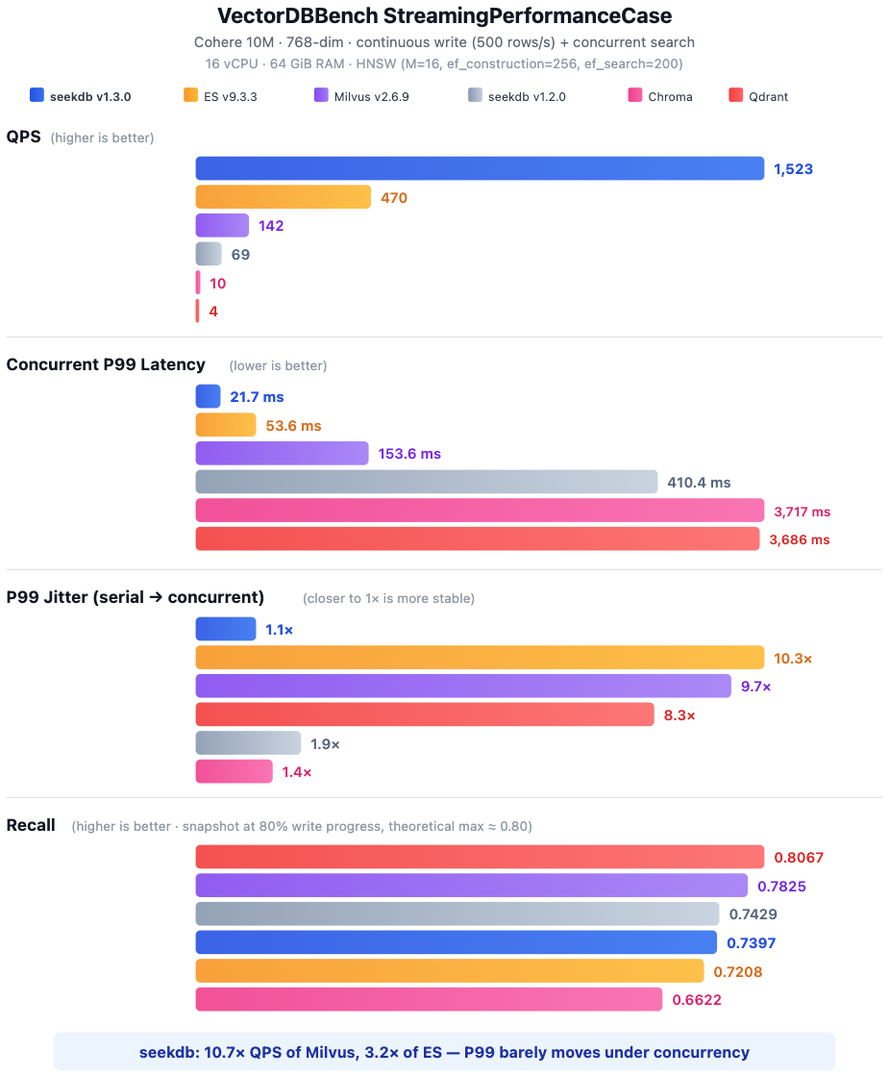
我这里引用了一张官方公开测试图。在它给定的千万级数据规模和持续写入条件下,查询 QPS 仍然有一千多,P99 延迟的变化也比较小,召回率大约是 0.73。看这种图时,不能只看吞吐,还要同时看尾延迟和召回率,并且保留测试的数据集、资源和写入条件。后面我还会拿它与自己的压测做一个说明。
从应用场景看,Agent 长期记忆、知识库等需求,可以复用同一套数据和检索能力。向量召回、关键词检索、结果排序,以及数据试验中的沙箱机制,都能在智能体开发中派上用场。我后面会结合自己的项目,讲这些能力具体是怎么用起来的。
三、企业视角:从数据底座到可观测
第二部分,我想从社区产品布局和技术趋势来谈。按我个人理解,可以把 OceanBase 开源产品的相关能力分成三层:底层是 seekdb,中间是 PowerContext [2] 这样的上下文连接与管理能力,上层是可观测与评估。
今天的 Meetup 里,很多分享都提到了可观测和可评估。我觉得随着智能体越来越多地进入实际业务,这部分会更加重要。没有相应的观测手段,我们很难知道工具调用的失败率,也不清楚一次端到端响应究竟花了多少时间。智能体即使能够返回结果,内部执行过程仍然可能难以解释。把调用、耗时和失败情况展示出来,开发者才有条件定位问题、评估效果。
再看 seekdb 本身的架构,它支持嵌入式和服务器两种运行形态。对于 PDF、Word 等文档,应用侧需要先完成相应的内容提取和数据组织,再将需要的内容写入数据库,并配置向量、全文等索引。这样,后续查询才能利用同一个内核中的多种检索能力。这里说的是一条应用数据处理链路,不能理解为数据库会自动完成所有原始文件的解析和索引配置。
关系数据、向量、文本和 JSON,都是我做智能体时会接触到的数据类型。GIS 这部分我自己的项目还没有用到,它更多涉及地图中的地理对象、距离和空间关系,需要使用相应的空间类型与函数。它和语义向量的相似度检索,处理的是不同的问题。
在这些数据能力之上,还有 AI Function、ACID 事务和混合搜索,再通过统一的接入方式交给应用使用。兼容、AI 原生、轻量、跨平台,以及多种运行形态,是我理解 seekdb 时会关注的几个特征。
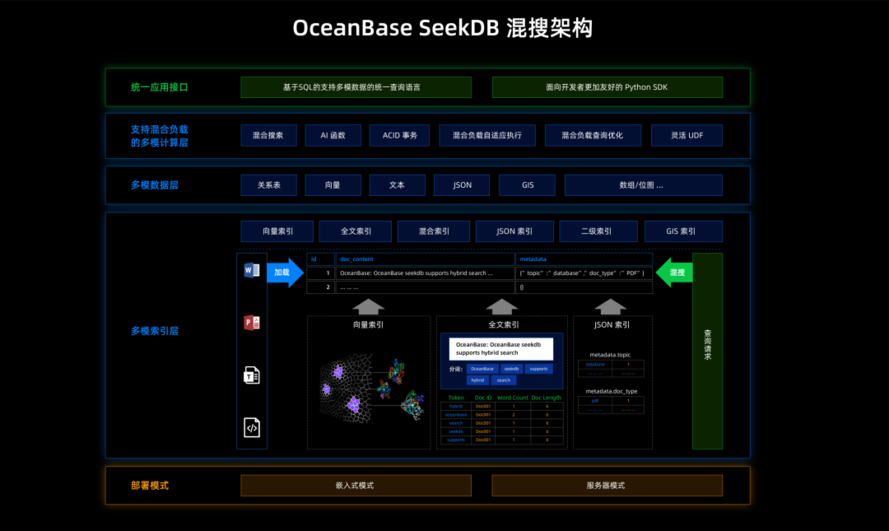
不同开发者的使用入口也会有差别。传统业务研发可能先从 SQL 开始,AI 工程师更关心检索和模型调用,Agent 工程师还会关心数据试写与结果采纳。这些工作可以建立在同一个内核上,减少为了不同任务重复搭建数据链路的工作。
四、理解内核:写入、后台整理与快照读取
底层机制里,我想简单说一下 LSM-Tree 和 MVCC。做架构时间久了,会发现很多系统处理数据的思路是相通的,可以从前台写入、后台整理和快照读取三个过程来看。
数据写入时,会先进入内存中的缓冲结构,同时结合 Redo Log 保证持久化和故障恢复。如果进程或机器异常退出,部分已经提交的数据还没有转存成磁盘上的数据文件,在日志仍然完好的前提下,可以通过日志恢复。这里的日志恢复有前提,不能把它理解成硬盘损坏后仍然一定能找回数据;备份和副本仍然需要单独设计。
后台会根据相应的阈值触发冻结和转存,把内存中的数据整理成磁盘上的增量数据,并继续做后续的合并整理。前台的写入和后台的整理各有自己的工作路径,不需要把所有处理都集中在一次前台请求中。
快照读取则要按照事务所能看到的版本,给出一致的数据视图。需要的数据可能还在内存里,也可能已经在磁盘上;内核需要从相关存储层读取并归并这些数据,按版本规则选出这次读取应该看到的结果。MVCC 的作用,就体现在这种多版本的可见性控制上。
在应用层,我们希望关系数据、向量、JSON、文本和 GIS 等数据,能够通过一套 SQL 表达查询。比如在向量检索中计算距离,同时加上业务上的标量过滤条件,再取 Top-K,这些条件可以放在同一条查询里。
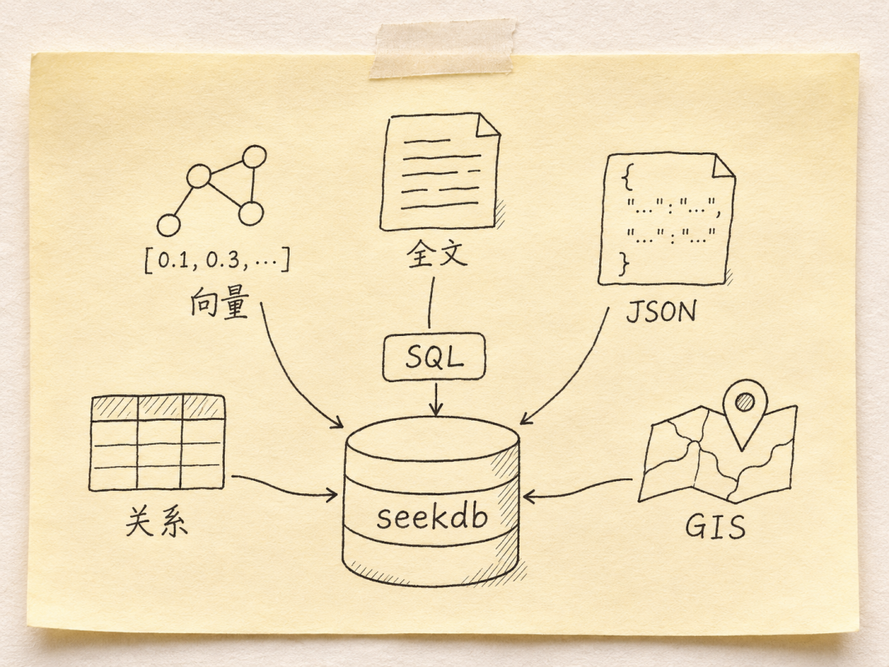
过去,我们可能会分别接入关系数据库、MongoDB、Elasticsearch、Milvus 等系统,处理各自擅长的数据和检索任务。seekdb 将多种数据与检索能力放进同一个内核,我看重的是它能减少应用在多个系统之间组织和拼接查询的工作。具体能替代多少已有组件,仍然要根据业务使用的功能来判断。
五、混合检索、AI 函数与数据沙箱
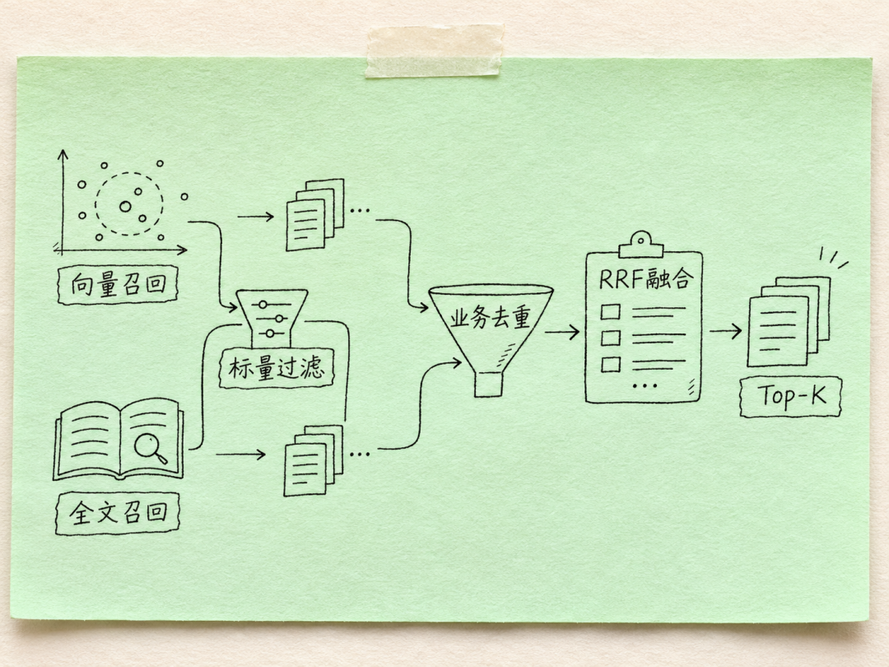
混合检索的链路,做过搜索或推荐系统的朋友应该比较熟悉:一边做语义召回,一边做关键词召回,再对候选结果融合,按需要进行后续重排,最终返回 Top-K。
不同支路的分数,往往不在同一个尺度上。比如向量距离可能是零点几,全文相关性分数可能是几十,直接把原始值相加,排序就容易被某一支路主导。采用分数加权时,需要先处理分数尺度,再根据业务需要设置权重。也可以使用 RRF,根据各支路的排名做融合,不直接比较原始分数。
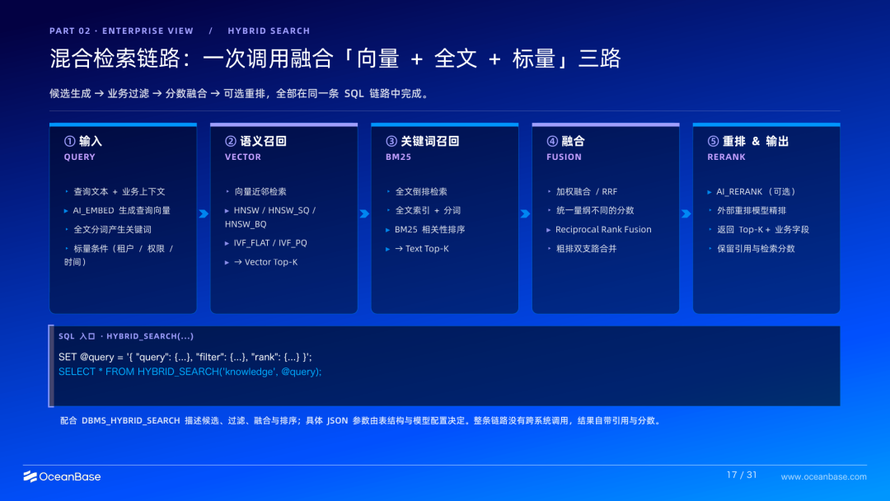
在 seekdb 的查询表达中,可以把 Query、Filter 和 Rank 这些环节组织起来。我比较认可这种把检索条件和业务过滤放在一起的方式,能够让查询本身更完整地表达业务要求。
另一个我觉得有意思的能力是 AI Function。这里主要有 AI_EMBED、AI_RERANK 和 AI_COMPLETE:分别用于调用嵌入模型生成向量、调用模型重排候选结果,以及调用生成模型完成生成或判断等任务。
这里的「数据库内 AI」描述的是数据库提供调用和管理入口,模型服务通常仍然来自配置的外部端点,并不代表模型都在数据库进程里运行。模型定义和服务端点可以通过 DBMS_AI_SERVICE 管理。在模型类型、输入输出和调用约定兼容的情况下,调整服务提供方时,可以通过修改模型或端点配置,让上层 SQL 调用保持相对稳定。
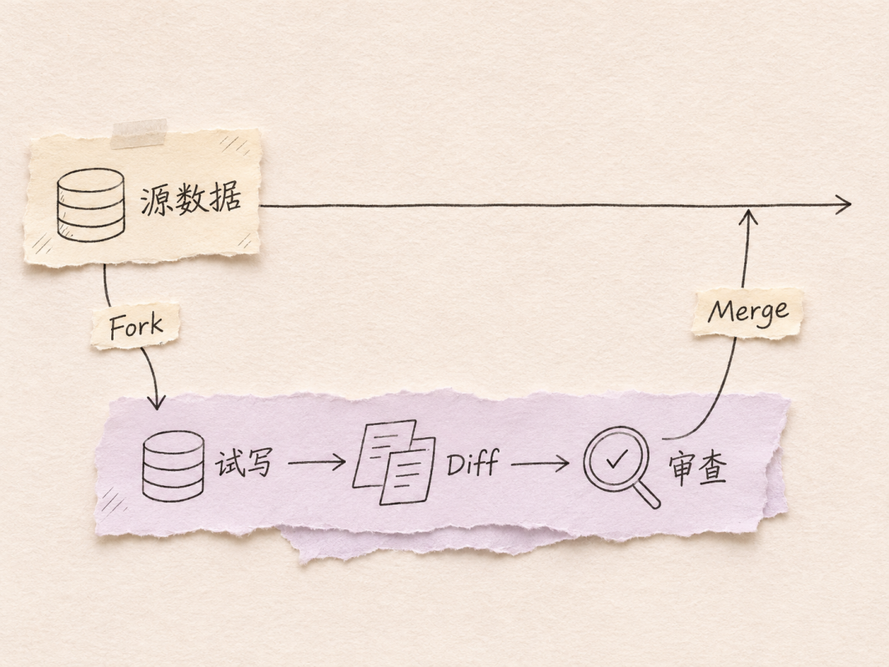
seekdb 还有一类面向 Agent 的数据沙箱能力。Agent 生成代码和执行操作越来越容易,但在正式采纳它的修改前,我们需要有一个独立试验、检查结果的过程。这里涉及的 Fork、Diff、Merge,处理的是数据分支和数据变化。
我可以先创建数据沙箱,在里面试写和验证,再检查与原数据的差异,最后决定是否采纳。这个流程和 Git 中创建分支、检查差异、合入变更的思路比较接近,但它提供的是数据层面的隔离,不是代码运行沙箱。代码和工具执行本身的隔离,还需要另外安排。
我自己的智能体也用到了这部分能力。对我来说,先试验、再检查、最后采纳,比让 Agent 直接改正式数据更容易控制,也方便把每次修改与具体任务关联起来。
六、版本变化与压测数据要分开看
分享中我介绍到的版本是 V1.4.0。这一版围绕轻量化做了不少工作,安装包大小、稳态内存和稳态 CPU 占用都有下降。这些变化让我比较关注它在嵌入式应用和跨平台交付中的使用体验。
版本升级也需要看清楚路径。这里的「嵌入式形态升级」说的是实现和交付方式的变化,不能据此理解为旧版本可以直接原地升级。实际迁移时,要根据对应版本的升级说明处理数据和应用兼容性。
再来看前面提到的官方公开压测。这个历史测试使用千万级、768 维的数据集,机器资源是 16 核、64 GiB,并不是 16 个数据库节点。在该项工作负载中,seekdb 的 QPS 是一千五百多,Elasticsearch 是四百多,Milvus 是一百多。
我更关注边写边读时 P99 的变化。在这组结果里,seekdb 的尾延迟变化比较小,另外两套系统的变化幅度比较大。不过,对比仍然要结合各系统的召回率、查询参数和测试时点一起看。图里的 seekdb 召回率大约是 0.73,不能只拿 QPS 就给出所有场景下的结论。这也是历史公开测试,不能直接作为 V1.4.0 的性能排名。
这组指标是在写入进度约 80% 时采集的,图中给出的理论最大 Recall 约为 0.80。原图也列出了其他系统的召回率,需要放在相同的测量条件下一起比较。
右边还有一张我自己做的压测图。我是在自己的智能体环境里测试,Docker 容器使用的机器大约是 8 核、16 GB,测到七百多 QPS。我的资源、数据和测试条件与官方测试有差别,这两个数字不能当作同一条件下的直接对照,也不能把差异都归到硬件上。
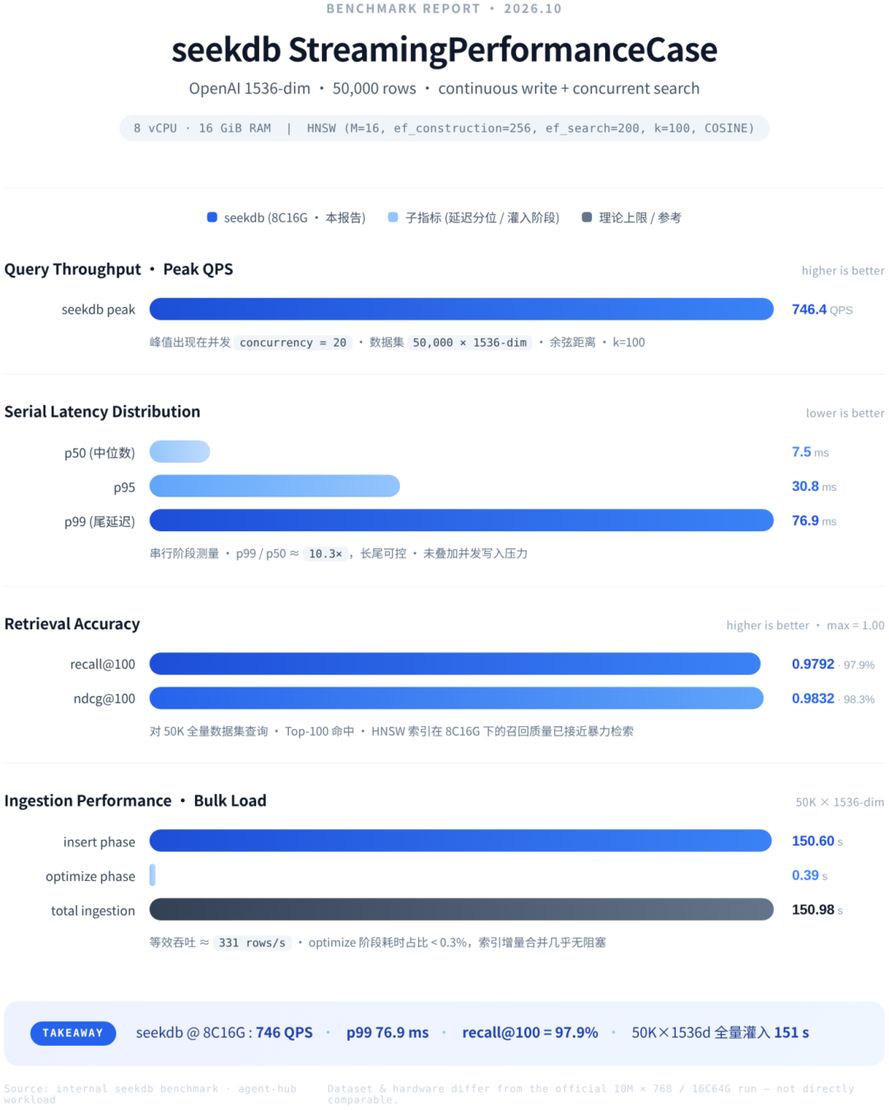
如果大家准备把 seekdb 用到业务里,我建议用自己的数据和请求方式压测。尤其是有持续写入时,要把吞吐、延迟、召回率和最新数据的可见性一起测,才知道它是否满足自己的要求。
七、把 seekdb 接入 Agent-Hub
第三部分,我介绍一下自己的智能体实践,以及接入过程中踩到的坑。
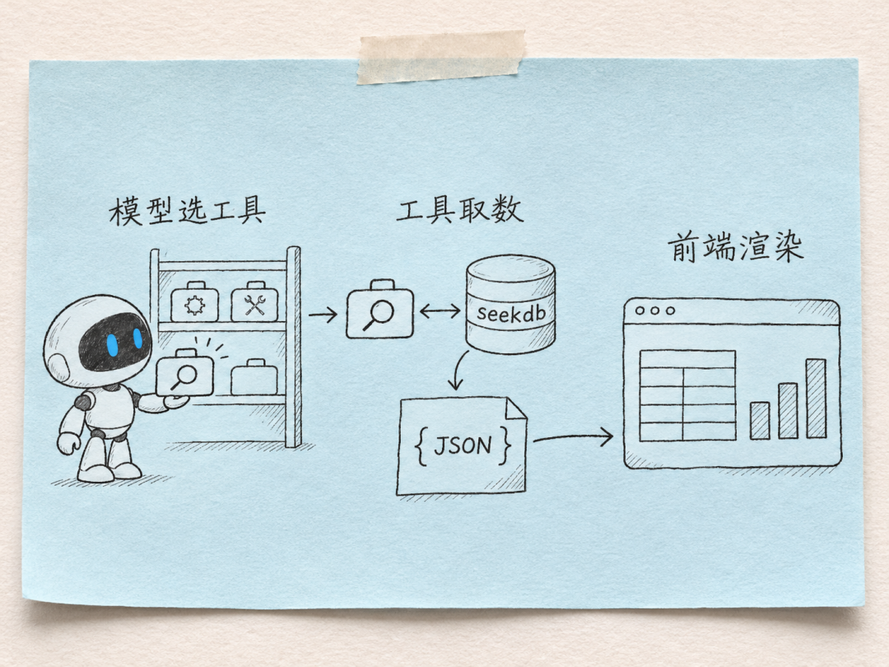
Agent-Hub 是我一个人做的智能体项目,也在尝试搭建自己的 Harness,组织模型调用、工具执行和上下文管理。整体采用 DDD 架构,seekdb 位于基础设施适配的位置。这样,上层编排可以使用相应的数据能力,底层也保留接入其他数据库的空间。
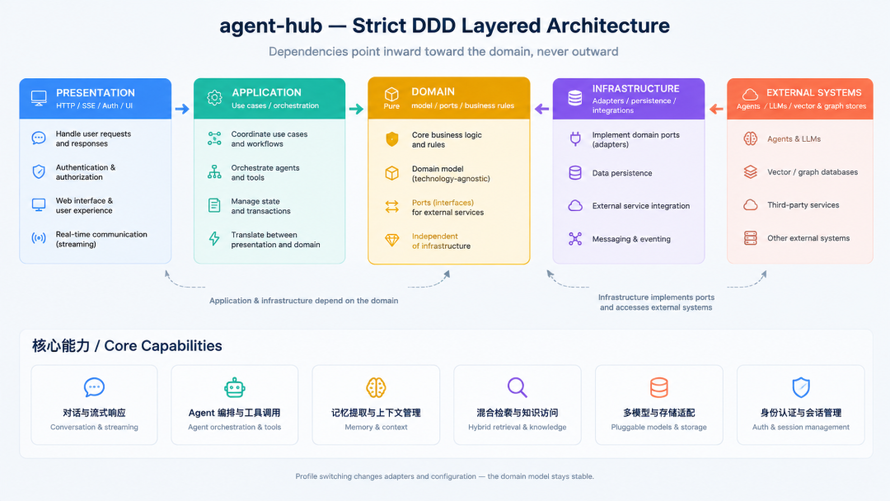
项目里涉及记忆与上下文管理、混合检索、多模型存储适配,以及身份认证和会话管理。seekdb 主要是在这些业务能力需要读写数据、检索信息时参与进来,再由编排层把工具和上下文组织成完整的任务过程。
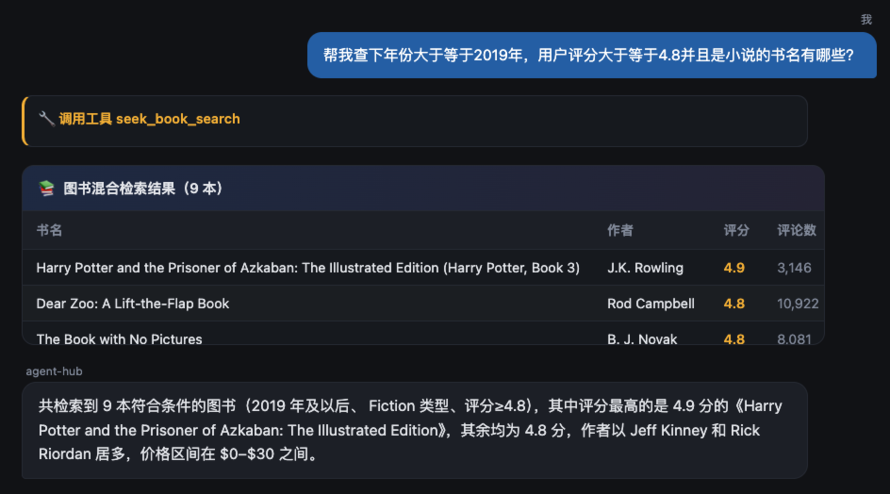
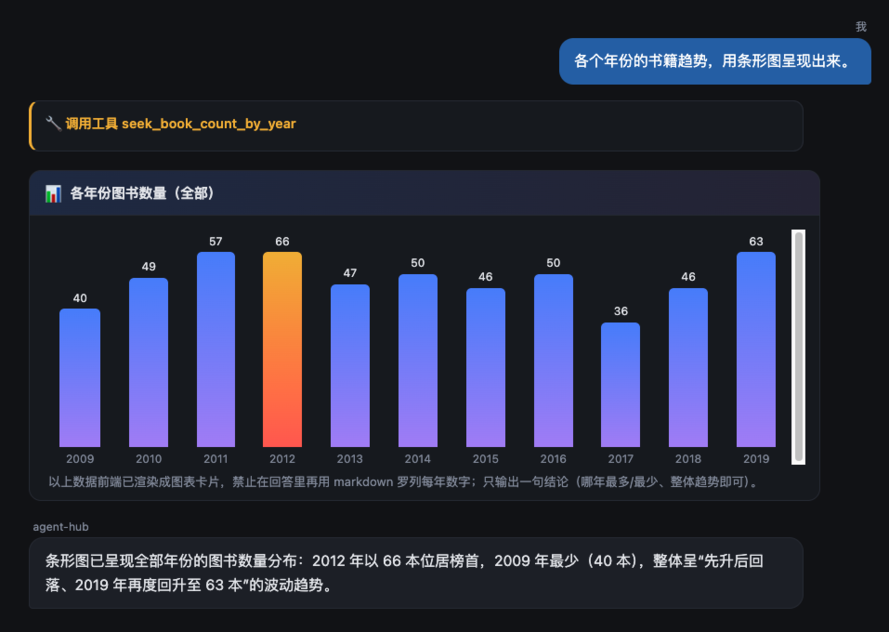
演示时,我让智能体帮忙查书,它通过接入 seekdb 的检索能力返回结果,再在页面上展示。我拿展示结果和数据库中的数据做了对照,结果能够对应起来。
我还加入了 A2UI 相关能力,让同一批数据可以按需要呈现成图表。比如我要求它使用条形图展示,前端就能够把相应的结果画出来。对用户来说,查到数据之后能直接看到适合阅读的呈现方式,整个使用过程会更顺畅。
混合检索的代码逻辑也不复杂:先走向量和全文两条召回支路,对两路候选做去重,再用 RRF 做排名融合,返回最终结果。做过推荐或搜索系统的朋友,对这个流程会比较容易理解。这里的 RRF 是融合算法,我在讲解中把后面的排序过程简称为「精排」,它并不意味着这里又调用了一个独立的重排模型。
八、三个实际问题:零向量、SQL 拼接和异步索引
接下来是我在项目开发过程中的“踩坑”部分,我会挑几个印象比较深的来聊聊。
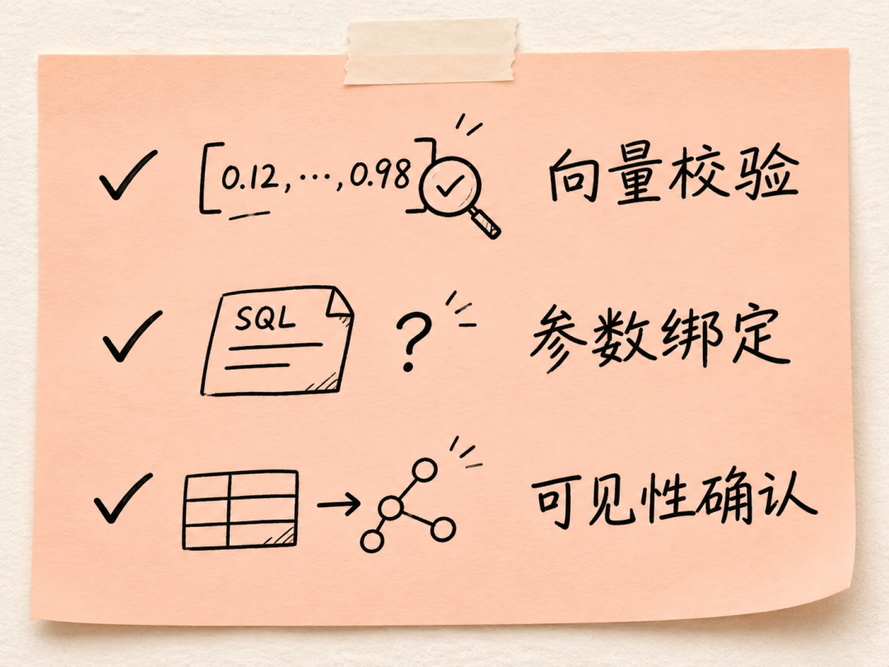
第一个问题是 Embedding 返回全零向量,检索结果出现了大量不相关内容。这主要是我工程上的失败处理没有做好。我也在结合 AI 写代码,但最初生成的代码没有把超时、鉴权失败等情况处理清楚,遇到这些错误时,静默返回了一个零向量。
从页面看,请求没有报错,仍然能查出一些数据;但向量支路已经不能提供正常的语义相关性,返回结果自然就不准确。系统「有结果」和检索「有质量」,在这里是两回事。后来我针对失败处理做了优化,不让模型调用失败悄悄变成一份看似合法的向量继续参与检索。
另一个是 SQL 拼接,这是一个老问题,但在 AI 辅助开发里仍然很容易遇到。Java 开发里,像 MyBatis 这样的框架支持通过参数绑定来处理查询条件;我最初拿到的部分代码却直接拼接字符串。这样既容易遇到引号、类型等问题,也会带来 SQL 注入风险,影响数据安全。
因此,这类数据库访问代码要检查参数是否真正通过占位符绑定。即使代码是 AI 生成的,也不能因为查询暂时能跑通,就省掉这部分检查。
还有一个问题和前面的异步向量索引直接相关。我在智能体里插入新数据,马上做向量检索,刚写进去的记录搜不到;过几秒再查,又能搜到了。
原因是基表事务提交之后,异步向量索引还需要时间追平。基表提交成功,不等于这条数据已经在向量索引中可见。如果业务要求写入后立即通过向量检索查到,就要据此选择同步索引,或者在异步路径上显式触发索引刷新,并确认刷新完成后再查询。
这里讨论的是检索可见性的业务要求,需要和事务本身的一致性区分开。业务能否接受索引稍晚可查,决定了应该如何选择索引维护方式。不能靠程序里随意等几秒,来假定数据已经进入可检索状态。
九、落地前先明确部署、可见性和采纳规则
落地之前,我建议先把几个问题说清楚。
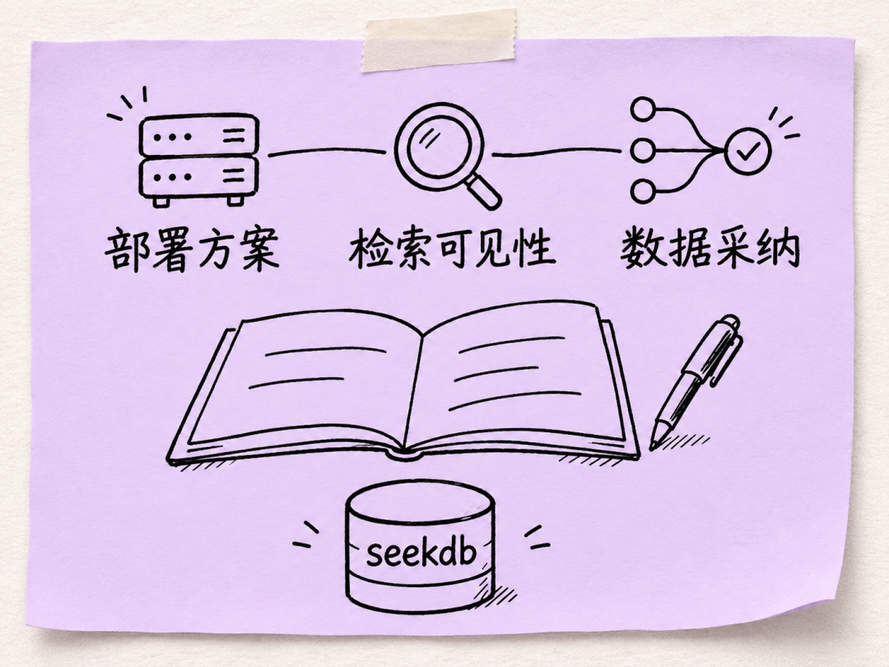
部署上,要知道产品是在端侧还是云端运行,数据量大致有多大,再选择相应的数据库产品。如果数据规模很大,又有企业级分布式可靠性要求,我会优先考虑 OceanBase;如果是 AI 应用,初期数据规模还比较适中,希望快速使用混合检索或者嵌入式 SDK,就可以考虑 seekdb。这是我的选型思路,具体还要结合负载、资源和运维要求验证。
可见性上,要明确数据写入后是否必须马上回查出来。这个业务语义决定了同步索引和异步索引怎样选择,也决定了刷新索引的动作应该放在哪里。
数据采纳上,要规定 Agent 可以在哪些表、哪些数据范围里试写,如何利用 Fork 等机制隔离试验,检查差异之后又由谁决定采纳。前面提到的数据沙箱,最终也需要和应用里的操作规则配合起来。
最后,Agent-Hub [3] 已经开源,感兴趣的朋友可以看看项目,也欢迎一起交流和共建~
参考资料[1] seekdb: https://github.com/oceanbase/seekdb[2] PowerContext: https://github.com/oceanbase/powercontext
[3] Agent-Hub: https://github.com/RiemannChow/agent-hub
立即试用 OceanBase 企业版,体验国产数据库能力 立即试用
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69909943/viewspace-3189035/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- OceanBase 发布「星火扬帆计划」 - 企业级数据库实践
- 无需安装,让 AI 数据库在你的浏览器本地运行 - 企业级数据库实践
- 基于上海人社 60TB 核心库迁移
- 从蚂蚁阿福谈起 - 企业级数据库实践
- 把 Agent 的「黑盒」拆开 - 企业级数据库实践
- 超级干货分享 - 企业级数据库实践
- 把 seekdb 塞进 iOS App:让混合检索嵌入手机 - 企业级数据库实践
- Kimi 支持百万级上下文,Agent 还差哪一口气? - 企业级数据库实践
- 省级农商行核心系统升级:OceanBase 分布式架构的 4 条选型逻辑
- 再+1OceanBase 联合高校攻克并发查询预测难题 - 企业级数据库实践
