把 Agent 的「黑盒」拆开 - 企业级数据库实践
10 月 31 日,由 OceanBase 主办的「你的 Agent 出错时,你看得见吗?」技术专场在深圳举办。专场以「运行轨迹 → 问题定位 → 智能体观测演进」为主线,汇聚 vivo、New API 等团队的一线技术专家。
Agent 原生时代,可观测性要穿透推理过程、工具调用与长程记忆,把每一次运行轨迹完整记录下来,并给出可评测、可归因的结论。这场专场,就是对这条链路的一次完整拆解。
开场:从「开源开放」到「数据即 AI 资产」
OceanBase 开源团队负责人封仲淹回顾了项目开源五年的路径——坚持「开源开放,生态共赢」,与上下游共同开拓场景。
他给出一个判断: OceanBase 仍是数据库公司,但在 AI 时代,数据已成为 AI 的核心资产。因此公司正深度向 AI 转型,目标是打造面向 AI 的数据管理平台,让 Agent 与数据处理深度融合。
这个判断奠定了全场底色:Agent 的每次运行都会留下数据,而这些数据能否被采集、存储、检索、评测与复用,决定了 Agent 能否真正走向生产。
可观测性是评测的源头
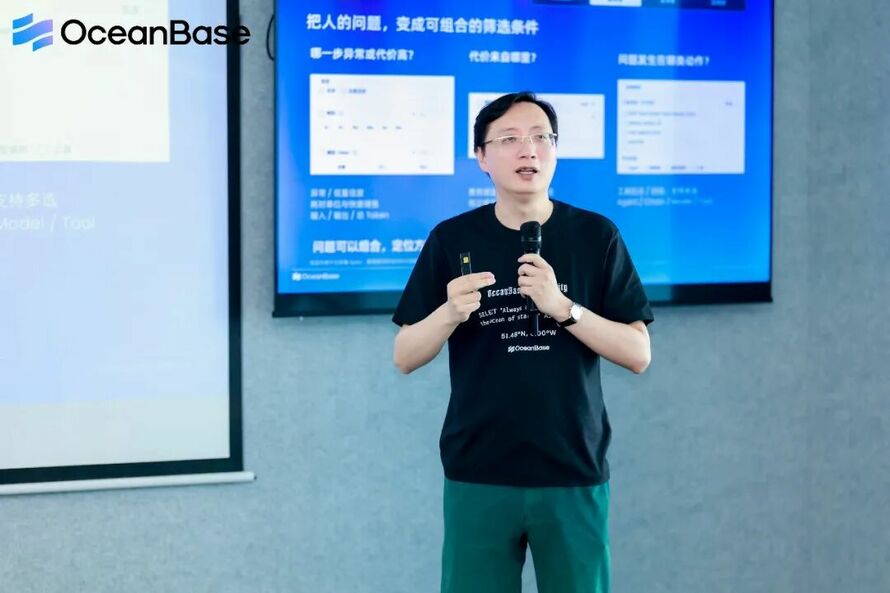
LangChain / OceanBase Ambassador 张海立用一组数据开场:LangChain 社区 2024 年末的调研中, 89% 的受访者已在不同层面使用可观测能力;2025 年 5 月的全球开发者大会上, 近 20 场演讲约 80% 在讨论评测。
观测是评测的基础。团队从「观测」走向「评测」,意味着智能体正从「能跑」进入「能被优化」的阶段。
但他也点出一个尴尬的现实:自 2023 年 1 月 LangSmith 发布以来近四年,业界主流的可观测界面 几乎没变——依然是一棵巨大的树状调用图。开发者打开一条耗时一小时的 trace,面对成百上千个节点,只能「先关掉、深呼吸、泡杯茶」。
为此,他与 OceanBase 社区提出三个改进方向:
-
看得清:只留高价值节点——异常步骤、长耗时步骤、高 token 消耗、昂贵工具调用,把「大树」剪成「小树」,筛选组合可保存复用;
-
读得懂:直接晾出覆盖 80% 问题的要素——对话结构、MCP、记忆、Skill、决策;同时把 token 换算成钱,让个人和团队都算得清这笔账;
-
改的好:以「诊断」承接观测,做轻量在线评测——机器在你休息时采样,发现关键问题再叫你,而不是跳过观测让 AI 给一个「不一定保熟」的分数。
他特别提醒: AI 的 trace 与传统微服务的 trace 已完全不同。微服务秒级响应,Agent 可能要一小时;但「请求—响应」的内核没变,只是内部装进了大量工具调用、流式输出与中间状态。
采集侧则有两类入口: 自建 Agent 依赖框架内置的采集与导出能力; 现成 Agent 应用(Claude Code、Codex 等)通过 hooks 或本地写文件采集。两类场景在企业中大量并存,这也是后续各家工具的接入基础。
沿着上述链路,OceanBase 团队即将推出面向生产级 Agent 的即将开源的观测项目——「读懂每一步,让 Agent 更进一步」——为 Agent 应用与框架提供数据采集、增强视图与在线评测,帮助发现问题、验证改进。
支撑这条链路的核心,是数据底座——观测与评测本质是多数据融合问题,底座能力直接决定上限:- 企业级场景:OceanBase 分布式数据库,承接企业规模与多负载融合;
- 个人与轻量场景:seekdb 嵌入式数据库,轻量开源、面向端侧;
- 更强底座:未来的 Lakebase,作为行业级支撑。
三者按场景分层承接观测数据,让多模态数据的融合观测有处可落。
为什么可观测在 Agent 时代更难
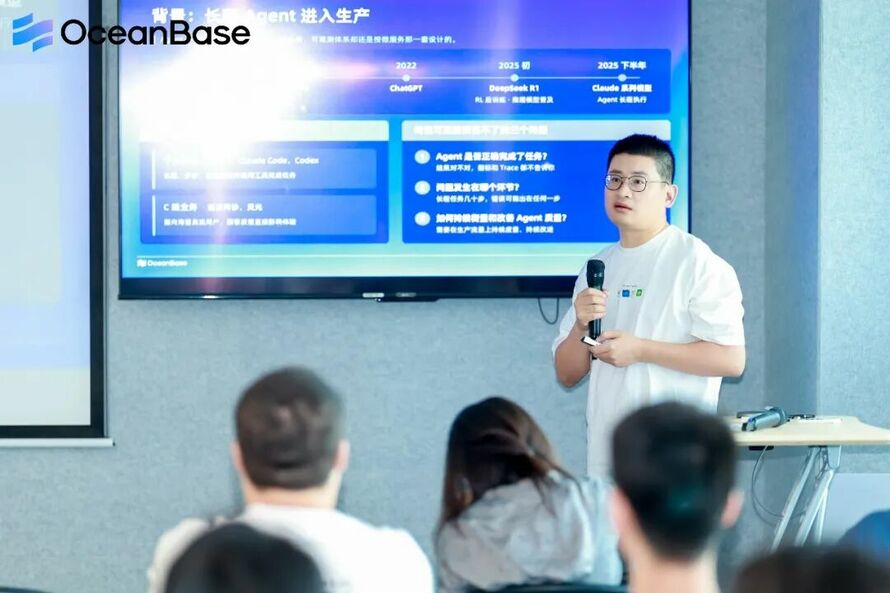
OceanBase 资深技术专家张易把问题讲得很直白:传统可观测处理的是 确定性系统——CPU 高了就是异常,grep 错误码就能定位。而 Agent 以模型为中心,基于 token 概率分布输出, 本质上不可枚举。
由此产生三个连锁难题:
- bad case 说不清:App 里点个踩容易采,但「爆粗口表达不满」这类强信号很难结构化捕捉,而这恰恰是最关键的样本;
- 问题出在哪一环难定位:长程任务里工具、模型、MCP 一轮轮 loop,哪一步跑偏需要跨系统归因;
- 线下 QA 覆盖不了:Agent 无法像传统应用靠测试覆盖度保证质量,只能在生产流量上持续打磨。
他给出一组真实规模数据:蚂蚁最大的生产级 Agent 应用, 单日 trace 约 10 TB,一年约 3–6 PB;其中 超过 97% 是文本,仅约 3% 是结构化数据。绝大多数价值藏在非结构化内容里——这正是多模态数据治理必须解决的问题。
用「标量优先」把成本打下来
海量 trace 面前,评估成本是第一道墙。张易的经验是逐级收敛:
能用标量解决的不用模型,能用小模型的不用大模型,筛到极小数据集后再上大模型。
评估器试过三种形态: 二分类决策模型(轻量便宜,模棱两可时无解)、 三分类 + 概率(成本略高,对模糊场景更稳)、 决策树式多模型路由(最精确,但成本最高且依赖专家规则)。
这套「标量 → 小模型 → 大模型」的漏斗,最终落在 OceanBase 的混合检索上:向量、全文、标量、规则多路并用,先把大结果集缩小,再交模型精细判断。
冷热分离:三天决定 90% 的价值
在某企业的实践中,trace 数据的价值有明显热度衰减: 90% 的 bad case 在 3 天内处理完毕,差一些的 7 天内完成;超过 3–7 天的数据写入几乎为零,查询也极不频繁。
于是冷热分离成了降本关键:热数据留在高性能存储支撑快速复现,冷数据下沉承接离线加工与数据挖掘。张易强调,bad case 复现高度依赖 当时的上下文,「留下证据」本身就是可观测的一部分。
五分钟拉起评测环境
在线评测要跑 A/B 分组,瓶颈往往不是算力,而是 数据环境。蚂蚁的基础设施给出硬指标:端到端评测环境搭建 不超过 5 分钟,留给数据库的 不超过 1 分钟。
OceanBase 的数据克隆正好对应: 千张表级别的 fork 毫秒级至秒级完成,TB 级数据同样秒级。评测可多线并行拉起沙箱、跑完即删,把「环境准备」从数天压到分钟。
vivo:三年规模化,从边缘业务到平台化运维
vivo 互联网数据库工程师杜霆介绍,vivo 自 2023 年启动分布式关系数据库选型并选择OceanBase,路径是「 先边缘、后核心」:先用归档等边缘业务验证能力,再迁移大规模数据业务与分析型业务。
集群规模扩大后,OCP 单点管理与公司内部标准流程出现缝隙——元数据管理、业务归属、资源调度、变更与监控都需要统一。vivo 因此做了平台化建设,明确三类角色边界:
-
业务研发:提交需求、确认窗口、验证业务结果;
-
DBA:变更执行、技术方案审核、异常处理;
-
平台建设与维护者:能力建设、维护规则与运行记录。
迁移选择「 表结构零改动、一对一迁移」,以业务无感为前提,完整走完「方案设计 →一致性与业务全量校验 →切换 →反向同步保回滚 →持续观察」闭环。校验用 MySQL 自身能力做 SQL 录制与回放,确保查询与变更都能在 OceanBase 上复现。
落地收益相当可观:
|
指标 |
结果 |
|
数据规模 |
700+ TB、数十个集群 |
|
整体存储成本 |
节省 60% 以上 |
|
服务器成本 |
减少 40% |
|
大表变更效率 |
提升 上百倍 |
|
核心库响应时间 |
提升约 30% |
|
业务运行 |
十余个业务、 零故障零丢失 |
下一步,vivo 将完善知识审计与分类分级,探索 AI 运维(知识检索、诊断辅助、评估与建议采纳),并测试向量能力与实时分析业务,验证 OceanBase 承接效果。
数据库视角:seekdb 为什么不是「阉割版」
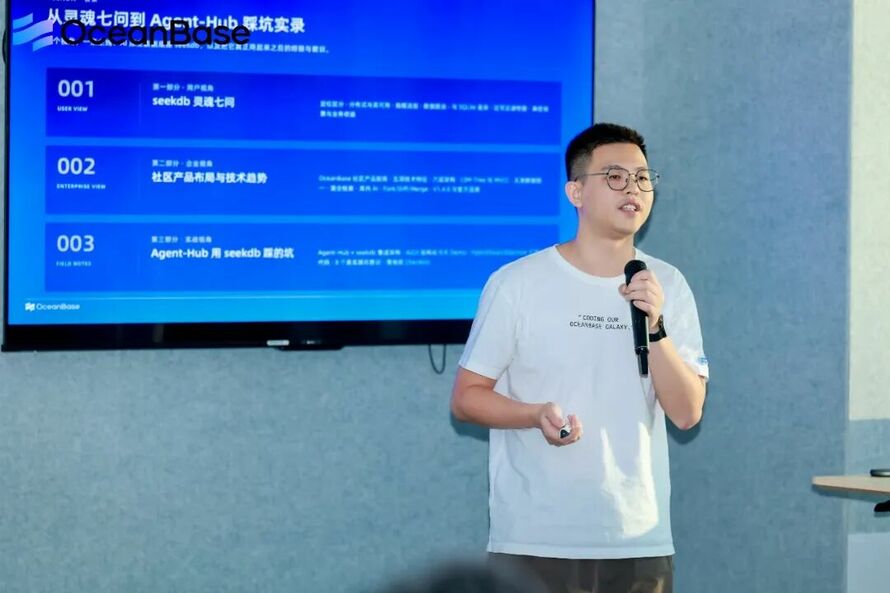
「老周聊架构」公众号主理人周鹏从使用者视角拆解 seekdb 的定位。他先划清边界: OceanBase 是 HTAP 企业级数据库,seekdb 是 AI Native 数据库,更贴近智能体应用。
三个常见疑问,他逐一回应:
- 为什么不用分布式?seekdb 以主备同步保障高可用,比分布式更轻,但并非阉割版——关键能力齐备;
- 企业怎么接?MySQL 兼容性好,接入成本低;通过 MySQL 协议与 VIP/DNS/Proxy 接入,云原生机制支持节点故障无缝切换;
-
异步向量索引怎么工作?写入时基表实时提交,索引变更经
change stream异步更新,解决了「同步建索引必须等构建完成才能读」的实时性问题。
内核层面,seekdb 融合 LSM-Tree 与 MVCC:前台写入先进缓冲区,结合日志保证持久化与故障恢复,后台定期整理、触阈值冻结并转存磁盘增量,同时支持快照读取与多版本控制。关系、向量、键值、文本统一由 SQL表达——向量距离查询、Top-K 检索不必再为不同数据库分别优化。
检索链路上,语义召回与关键词召回的结果会做 分数归一化(归一到 0–1 区间)后加权融合,再重排取 Top-K。
他也坦率分享了两条踩坑经验:
- 零向量与 SQL 注入:检索结果全是噪声,根因多在工程实现不够细致、未正确处理 SQL 注入风险;
- 异步索引的一致性窗口:事务提交不等于向量索引可见。强一致业务必须改用同步索引或配套刷新机制。
- 选型建议因此很朴素:
看部署形态(端侧还是云端)、看数据量、看对可见性的要求——三者决定了同步还是异步、嵌入式还是服务器模式。
New API:网关是 Agent 基建的「横向入口」
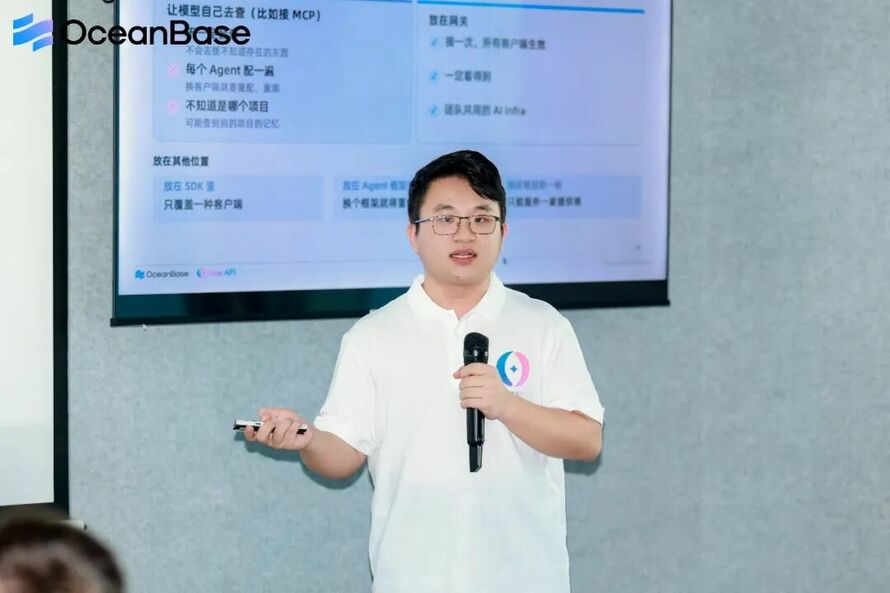
New API 团队 Principal SA 喻佳阳开场引用了一句海报上的话,引发了不少共鸣: 做 Agent 最贵的不是 token,而是不知道他为什么错。
他介绍了三层产品拼图: New API(开源在线网关,GitHub 已获 5 万 star,把多家模型提供商聚合成统一入口)、 AstraLink(开源本地网关,运行在用户本机,主打安全与隐私,请求出网前先做隐私过滤)。再往下,由 PowerContext负责记忆治理, seekdb负责端侧状态存储。
完整链路是:个人 Agent → 本地网关 → 横向扩展插件(记忆、RAG 知识库、Skill/MCP 分发)→ 记忆服务落到 PowerContext → 最终存储在 seekdb 嵌入式引擎。
一条请求在网关里的旅程是:识别客户端与会话轮次 → 隐私改写脱敏(并注入说明,让模型知道哪些内容需原样保留)→ 插件注入(如记忆)→ 路由(按质量、可达性、会话粘性选上游,兼顾前缀缓存命中率)→ 统计耗时开销 → 还原占位符返回。
接入 PowerContext 的过程迭代了多版。最初拿用户原始请求直接检索记忆,很快撞上三个问题:
- 太长:贴进来的代码或日志动辄上千字,超出可检索范围,召回内容信息熵极低;
- 太短:一句「继续」或「说中文」,根本没有检索的必要;
- 上下文依赖:「按之前聊的 UI 规范美化一下」——关键信息在前文,单句检索不出来。
更现实的约束是耗时: PowerContext 有一次检索达到 24 秒,端侧不可接受;而关键词检索只需 0.2–0.3 秒,稳定得多。
调整后的方案把记忆 分层放置:会话开始时注入项目画像与约 20 条主题目录(控制预算,避免挤占可用窗口),其余能力经网关暴露给 Agent 按需查询;写入侧默认只存 用户原话,因为模型生成内容可能含幻觉,不适合作为可靠记忆。
两个工程细节值得一提。 其一,前缀缓存:项目画像常驻系统提示词,每次改动都会让缓存失效,而缓存命中通常只按 10% 计费,所以只在缓存本就该失效的时机(30 分钟过期、上下文压缩、用户主动刷新)才更新。 其二,注入位置:系统提示词放长期规划(项目画像、主题),用户消息开头放本轮检索结果,工具结果里放 Agent 循环内的按需召回。
压测数据上,喻佳阳给了客观对照:官方压测 QPS 可达一千多,他自己的 Agent 实践场景约七百多—— 差异主要来自召回率口径与场景配置,选型应以自己的压测为准。另一个实用发现是: seekdb 更适合检索类负载,团队正基于它做内置知识库插件。
从「一对多」到「一对一」,Agent 的成本问题本质是观测问题
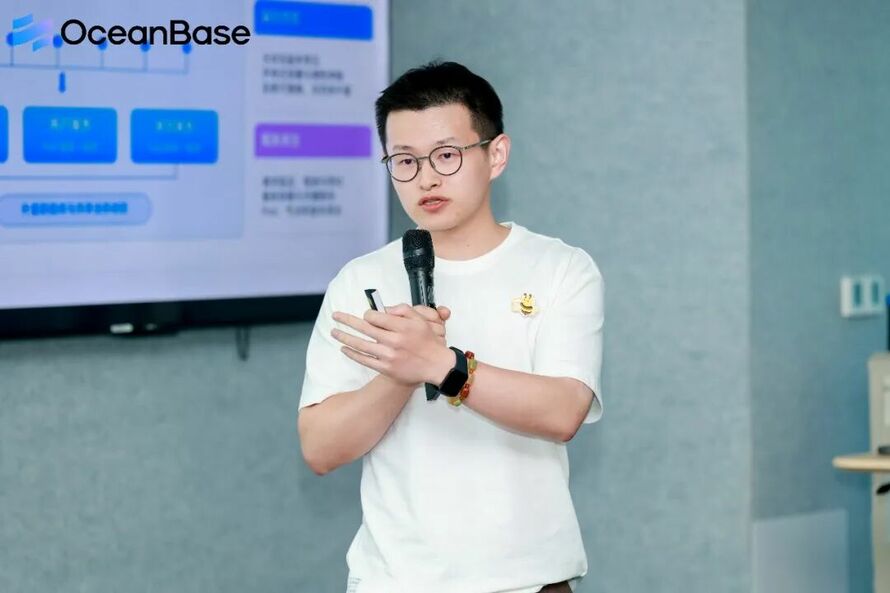
腾讯云高级技术产品专家、CNCF Ambassador 周鹏飞把 Agent 可观测讲成了一个成本问题。
Agent Infra 主要面向三类客群: 大模型厂商关注模型迭代效率,Agent 服务商关注单客成本,而科技与行业企业则关注员工的 AI 转型与提效。
客群需求不同,但都面临同一个变化:架构变了,观测对象也要变。云原生架构下,多个 Pod 共享底层 VM 与数据库,主要围绕延迟、错误率和吞吐量,通过指标、日志、Trace 进行观测。到了 Agent 时代,一个会话至少对应一台 Agent 云电脑,用户与会话之间严格隔离;大量开源 Harness 又以单体架构在本地运行,数据也留在本地,资源成本与观测难度随之上升。
沙箱正是承载这类会话的基础设施,可以理解为一台会休眠、能快速启动的 Agent 云电脑。与 7×24 小时常驻的虚拟机或传统云桌面不同,它需要在任务到来时毫秒级启动、空闲时休眠,同时支持多操作系统与持久化工作区。主流 Harness 采用“大脑 + 手”的分离架构:无状态的 Brain 负责理解意图,有状态的 Hands(沙箱)负责编译与执行。沙箱由此成为执行产物与链路数据的主要沉淀位置,也为可观测提供了数据原料。
Agent 的三类运行特性, 决定了成本优化的空间:运行间歇、计算稀疏、数据访问局部。
Agent 经常等待人工介入,有任务时才集中消耗 CPU 与内存,历史会话中的音视频则可能长期不再访问,却持续占用存储。对应的优化方式也很明确:算力按需供给、空闲即回收;文件按冷热分层,冷数据下沉至兼容 S3 协议的低成本对象存储,需要实时预览的数据保留在文件或块存储中。
Agent 的后端资源需要精细调度,任务执行过程也需要分层观测:安全团队关注行为,包括调用了哪些工具、是否越权;算法团队关注执行效果;SRE 关注链路健康;业务方关注成本。同一套轨迹数据,需要支撑这四类视角。
腾讯云开源的 CubeSandbox 与 OceanBase 的即将开源的观测项目 (以下简称观测项目)联合开源方案展示了这套能力如何落地。CubeSandbox 最快可在 60 毫秒内启动, 支持每分钟 60 万实例并发,并提供硬件级隔离:每个沙箱独享 Linux 内核,以规避容器逃逸风险,同时支持快照、暂停恢复与克隆。
在一次测试中,通过 DeepSeek Harness 查询了微软公开镜像仓库中的约 3,700 个镜像。执行结束后,会话数、请求数、Token 输入输出占比、缓存命中率等数据回流至观测项目总览页。遇到工具调用报错时,可以直接下钻,最终定位到 DeepSeek API 鉴权 Token 过期。测试者认为,相比 LangSmith,观测项目在易用性与开箱排错方面更友好。
但链路数据的价值不止于排错,还在于反哺后训练与评测。在强化学习场景中,模型可以通过大规模并行沙箱,从 GitHub 拉取代码、修复 Bug,轨迹数据则用于监测执行效果与 Token 消耗。
最终,这些能力指向同一个目标: 构建 Agent 自动化飞轮。 执行轨迹持续沉淀为后训练与评测的输入,Skill 与 Tool 通过版本化迭代不断优化,推动 Agent 自进化。
而这,又回到了开场那句话:
Agent 的能力在进化,观测它的能力也必须跟上。从「跑得起来」,到「看得清楚、测得准确、改得明白」——这一步,是 Agent 走向生产的关键一跃。
立即试用 OceanBase 企业版,体验国产数据库能力 立即试用
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69909943/viewspace-3188173/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 超级干货分享 - 企业级数据库实践
- 把 seekdb 塞进 iOS App:让混合检索嵌入手机 - 企业级数据库实践
- Kimi 支持百万级上下文,Agent 还差哪一口气? - 企业级数据库实践
- 省级农商行核心系统升级:OceanBase 分布式架构的 4 条选型逻辑
- 再+1OceanBase 联合高校攻克并发查询预测难题 - 企业级数据库实践
- ZCode × PowerContext:跨会话的记忆接入实践 - 企业级数据库实践
- 基于 Agent 观测实践:开发态与运行态的统一追踪方案
- PowerContext 1.4.0 发布:开发做到一半 - 企业级数据库实践
- 联通云犀平台 × OceanBase - 企业级数据库实践
- 聚势领航 - 企业级数据库实践
