Kimi 支持百万级上下文,Agent 还差哪一口气? - 企业级数据库实践
“To think is to forget a difference, to generalize, to abstract.”
思者,略其异,统其类,取其理也。
—— 博尔赫斯,《博闻强记的富内斯》 [1]
楔子(其一):一本小说
前两天,兹拉坦读了一部超短篇小说 ——《博闻强记的富内斯》。
小说的主角富内斯是一位乌拉圭青年,一次坠马让他瘫痪在床,却也让他获得了过目不忘的本领:看过的云、树叶的形状,都能分毫不差地留在记忆里。
他甚至还试过完整地重温一天的经历,但是每次重温,也得花掉整整一天。然后,富内斯发现这份天赋渐渐变得可怕,因为他能够记住惊人的细节,却很难从细节中进行归纳,并抽离出一些概念和经验。
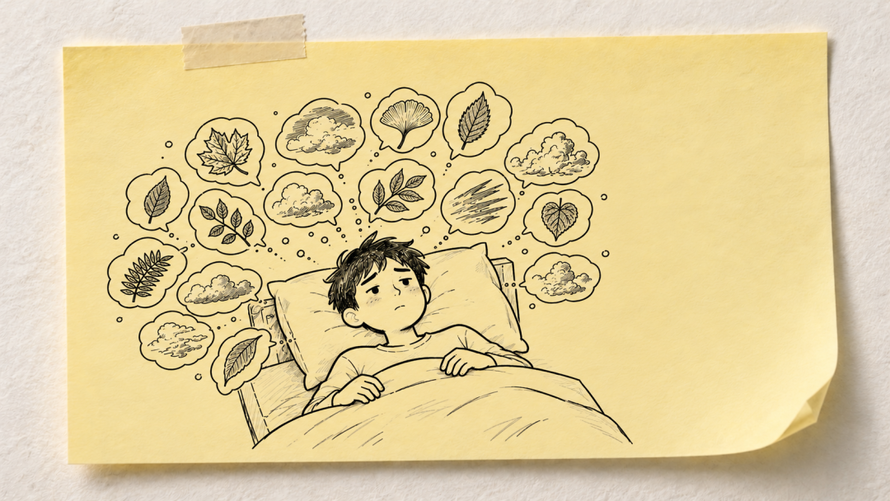
这本小说的厉害之处,是把“无限记忆”这种在我学生时期最希望获得的超能力,写出了令人窒息的感觉。因为过量的记忆,严重影响了富内斯的“思考”和生活。
最后,小说还对“思考”这种的动作,下了个定义 —— 放下细节,归纳共性,作出抽象(总结经验)。
楔子(其二):两则新闻
-
前几天,Kimi K3.1 Pro 发布 [2],支持把模型的上下文窗口开到 100 万 Token。

-
依然是前几天,业界的学者提出了一个“大模型原生记忆”的概念。简单来说,就是通过你和模型的对话记录,实时更新你正在使用的模型,而非依赖外部记忆检索。

百万上下文 == Agent 无需记忆 & 检索?
最近,Humanize MLE Agents 的研究者们 [3]在机器学习工程任务里发现,让一个 Agent 在单个会话里进行多个实验,越往后的实验,成绩就会越差。这是一个值得玩味的结论。
然后,这群研究者们就开始去研究了一个新课题 —— 如果把在一个 Agent 中进行的长程任务拆分成多个步骤,然后在多个 Agent 中进行接力,效果会变的更好还是更差?
他们让两个 Agent 共用一个工作区,每段会话最多完成 5 个实验,随后交接。新会话重置上下文,已经写下的代码、训练出的模型和实验结果继续保留。最后还留出 15 分钟,复核此前的候选方案,选择最终结果。
研究用 75 项 MLE-bench 任务做了测试,每项限时六小时,各配置重复三次。最好的交替配置平均有 78.2% 的实验任务的结果达到标准门槛,最强单 Agent 只有 72.4%。
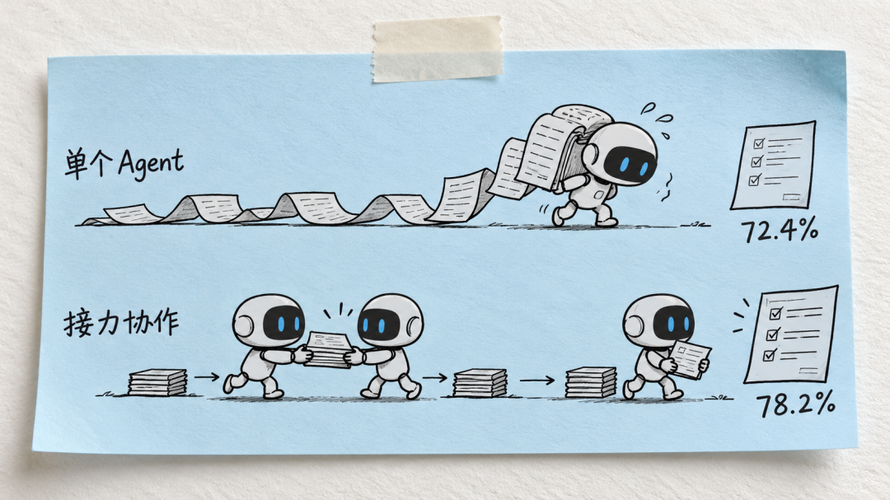
这是一个极其有意思的结果。长程任务因而也多了一种值得尝试的安排:一个会话完成一段可以检查的工作,留下成果之后,再让下一段会话接着做。
其实,更常见的场景是,即使没有主动排班,做到一半,某种 Coding Agent 的订阅额度被提前耗尽,不得不临时改用另一个 Agent 接手,继续完成被撂挑子的工作。
总之,之前人与人之间的工作交接,现在会逐步演变成会话间或者 Agent 间的工作交接。只要有交接,就依然需要所谓的“交接文档”,单个 Agent 的百万上下文解决不了这个绕不开的问题。
因此,跨会话 / 跨 Agent 的上下文管理(和交接),值得更精细的设计。
比如:代码和测试产物需要留下来,当前目标与有效约束也得有人维护。除此以外,前任 Agent 已经碰过的壁,也得要交代清楚。一个办法为什么没走通,在哪个环境里失败,有什么结果支持这个判断,都会影响下一轮探索。只存“方案不可行”几个字,下一位 Agent 依旧很难完全绕开它。
交出去的材料还要有轻重。新会话先拿到当前目标、已验证的进展和待查的问题,足够开始工作;需要追根究底时,再沿着引用查回原始讨论、日志与测试结果。这样留下来的成果,才有机会跨过一次会话的结束,成为下一次工作的起点。
上下文容量扩张本身,不能替 Agent 完成这些上下文管理和交接的职责。 当长窗口让 Agent 接手更长、更多人参与的长程任务时,状态变更和交接的次数也必然会增加,这时,管理上下文的价值也就变的更大了。
百万上下文时代,仍要按需检索?
斯威夫特写道,小人国的皇帝能看出钟表分针的走动;而富内斯能连续不断地看到朽坏、腐烂和疲劳那静悄悄的进程。他能记下死亡和受潮的演变推进。他是世界的旁观者,孤独而清醒无比;世界在他眼中形态万千,每一瞬间都一览无余,精确明晰得几乎难以忍受。
—— 《博闻强记的富内斯》
在论文 《Retrieval Augmented Generation or Long-Context LLMs? 》 [4]的比较研究中,在资源极其充足时,长上下文在所测模型与任务上的平均表现会高于朴素 RAG, 然而后者,则有着明显的成本优势和更高的检索效率。
可 Agent 面对的,常常是上千份工单、多个版本的设计文档,以及每天新增的执行记录。比如:查支付服务 2.0 的超时问题,相关的可能只是这个版本的几份工单和测试结果。即使上下文什么都装得下,也没必要浪费 token 去每轮都从头读一遍完全无关的东西。
最佳实践,自然是把这些资料存入数据库,每轮根据任务取用:先按项目、版本等条件做结构化过滤,对错误码、函数名和配置项做精确匹配或全文检索,再用向量检索补充那些换了说法、却在讨论相近问题的记录。模型拿到相关原文后,仍可以用长上下文做综合分析,需要时继续查找。
对要反复查资料、持续接收新记录的 Agent 而言,按需检索仍是兼顾效率和费用的重要办法。
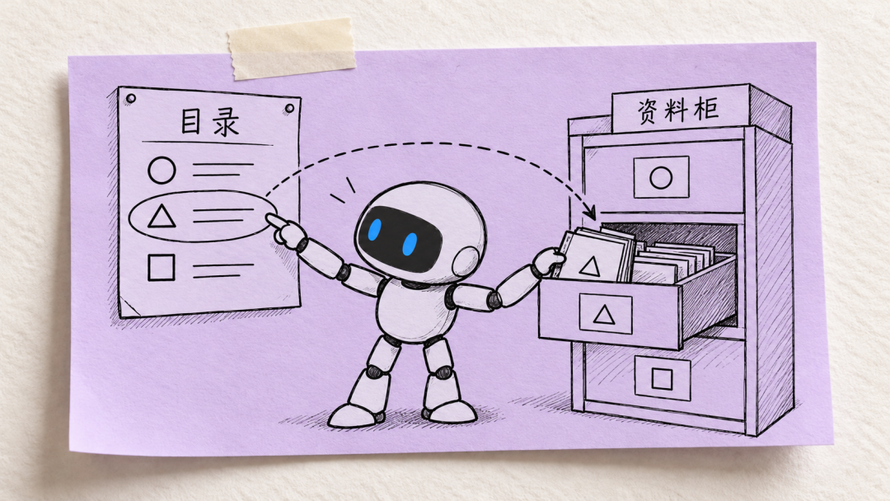
支持结构化过滤、全文和向量检索的 AI 原生数据库(AI Native Database),也就有了具体的用武之地:在同一套查询体系里,把适用版本、报错原文和语义线索结合起来,为 Agent 找到相关资料,并保留回查原文的入口。Agent 接手的任务越依赖外部信息,这套数据存取能力就越重要。
大模型原生记忆?这又是啥玩意儿?
前文简单提了一句“大模型原生记忆”的新闻。
如果说长上下文让模型同时看见更多材料,原生记忆就在探索另一种办法:让先前的信息,成为模型后续计算可以直接利用的内部状态。
MemTensor 推出的 MemT-1.0 [5]大概就是这么一条路线 —— 它把交互信息写入可更新的数值记忆状态,生成时通过记忆机制读取。在线写入依靠前向计算更新状态,训练好的读写参数保持固定。论文MemT 论文的编码实验 [6]展示了这条路线的可行性。但在实验里,有不少场景下,相比原生记忆,反倒是外部结构化存储经验的表现更好。
这里还是多解释 MemT-1.0 这种特定模型的技术路线和常见外部记忆的区别吧:
-
常见外部记忆:把信息存成结构化或者非结构化的记录,需要时检索出来,再交给模型阅读。
-
MemT 的原生记忆:把信息写进模型内部可更新的数字状态,后续计算直接使用,不必一直携带历史原文。
个人觉得,在一定程度上,“大模型原生记忆”甚至还有些类似于“每聊一句,就把整个模型重新训练一遍”。所以,“大模型原生记忆”依然存在很多局限。
比如,一个 Agent 解决了某个报错,记住了处理方法。后来项目升级,这个方法只适用于旧版本。此时我们需要查:当时遇到了什么问题,依据是什么?方法在哪个版本验证过?等等等等,才能继续推进工作,但 模型能利用内部记忆,并不能直接回答这些项目记录如何维护的问题。依然需要一个上下文管理工具,保存项目决策、依据、进展和交接信息。
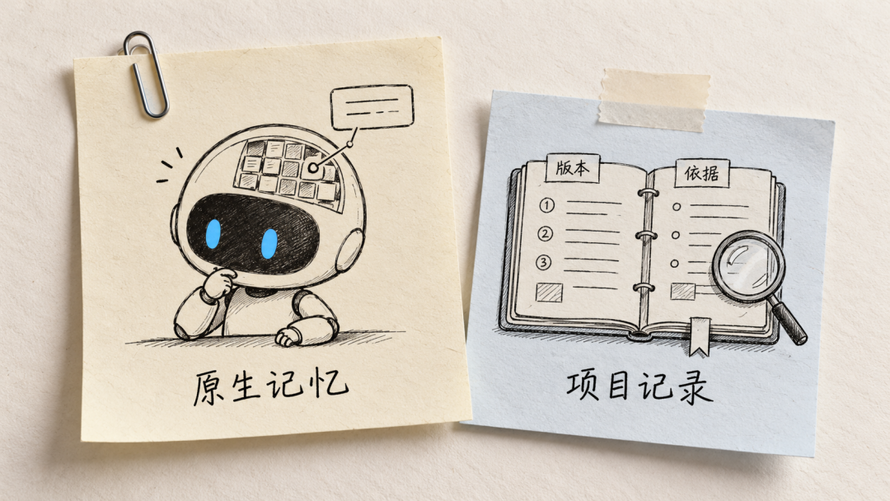
相比所谓的“大模型原生记忆”,独立项目记录的价值,还在于使用者能逐条检查、修改、追溯,并让不同 Session 和 Agent 继续利用。
即使未来经验进入模型的方式真的变了,上下文管理依然 不可或缺。
主角登场
如果要请富内斯来当你的同事,我们大概很快就会产生一种愿望:希望他少回忆一会儿,赶紧特么给我把事儿办了。
可他记得的每一件事都确实发生过,凭什么跳过这一件,先做那一件?
这个问题比“还能记多少”麻烦得多,也重要得多。
Agent 在进行回忆时,还得说清楚怎样才算完,否则,它很可能像富内斯一样,尽职尽责地把昨天再过一遍。
PowerContext
我们通过上下文管理工具来留下记录,只是想让明天少走些昨天走过的弯路。
PowerContext [7] 是一款面向人和 Agent 协作的上下文管理工具,当前最新正式版为 1.4.1 [8]。
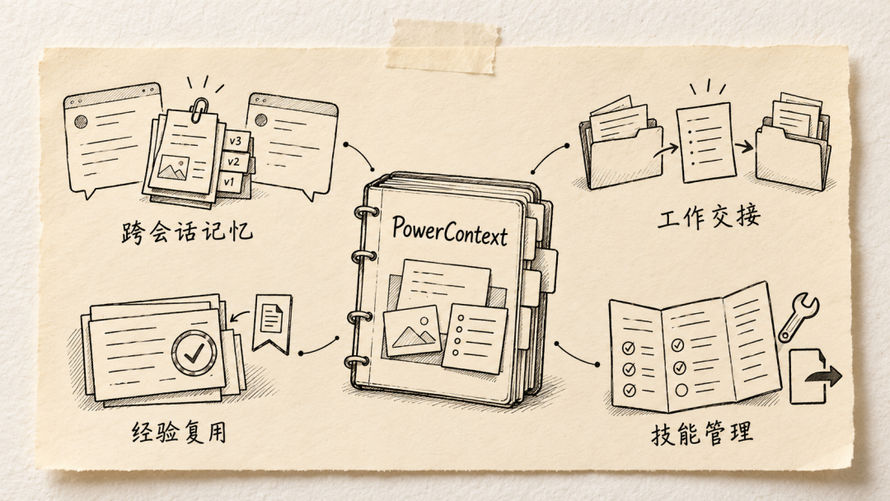
它保存原始资料与证据,维护可复用的项目决策和约束,并用交接记录写清目标、已验证的进展、阻塞和下一步。换会话、换 Agent 时,接手者可以先读当前进度,再沿引用核对依据。
它还支持从任务证据中生成可复用的经验 [9],经审阅批准后参与召回,后续修订保留历史版本;也能从证据或已批准经验中生成 Skill 候选 [10],经审阅批准后显式导出,供 Codex 等通用 Agent 使用。
做过一次的工作,由此可以留下供后续任务查阅的办法与依据。
每轮工作前,PowerContext 可以按当前问题和预算准备相关上下文。1.4.1 进一步减少检索与记忆写入中的重复操作,并新增可移植归档,让选定项目的数据连同历史版本、证据与交接记录一起导出、检查和恢复,方便保存与转移。
seekdb
seekdb [11] 是一款面向 Agent 和 AI 应用的轻量级 AI 原生数据库,当前最新正式版为 1.4.0 [12]。
它把结构化数据、文本和向量统一管理,支持在一条 SQL 中结合字段过滤、全文与向量检索。工单、文档、日志和任务记录可以放在同一个数据库里,按项目、版本和当前问题查找,减少多套存储与搜索系统之间的数据同步和结果拼接。
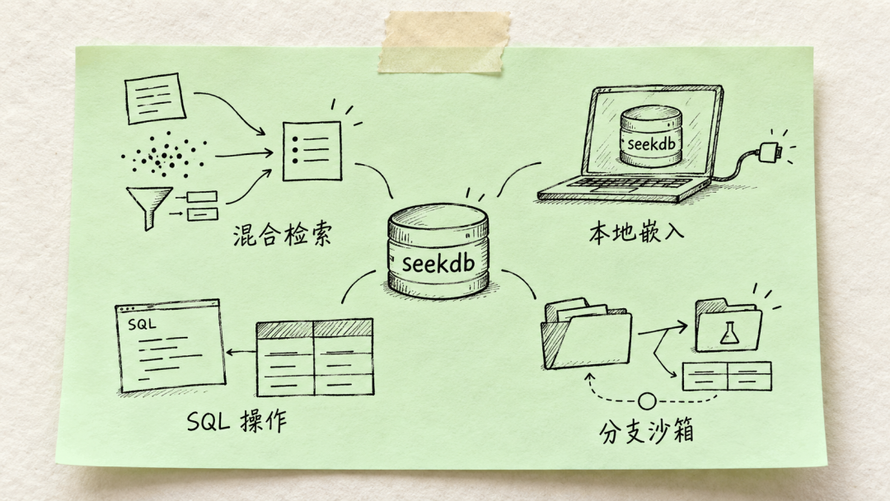
除了存和搜,它还支持 Fork、Diff、Merge 数据分支能力 [13]。Agent 可以在隔离的数据分支里修改数据、调整检索方案、比较结果,再经检查选择合并适用的表数据改动或丢弃分支。需要反复试验时,可以保留一份可供对照的起点,不必让每次尝试都直接改动主库。
seekdb 1.4.0 版本的重点是轻量化:缩小安装包,降低 CPU 与内存的基础开销,并改善了 macOS 上的运行稳定性。
seekdb 保留本地嵌入式与独立服务两种使用方式;新版嵌入式通过独立后台进程和 MySQL 协议访问,支持多个应用共享同一个实例。本地助手、开发工具和边缘应用可以按自己的部署条件选择接入方式。
尾声
富内斯记得某个黎明时南方云朵的形状,还能把它们与书皮的斑纹、船桨激起的泡沫作比较。
可那些云,早就散了。
作者博尔赫斯曾说:“很抱歉,和富内斯那一夜的原话的很多细节,已经记不清了,我只能尽量忠实地转述。”
那个记得一切的人,就这样被另一个连当晚原话都记不清的人,留在了纸上。
这篇文章原本的标题是《百万上下文 & 大模型原生记忆,Agent 何须记忆和检索》,因为感觉过于冗长,所以改成了现在的版本。在最后,继续删繁就简,直接用《博闻强记的富内斯》的结尾作个结吧~
参考资料[1] 《博闻强记的富内斯》: https://marom.net.technion.ac.il/files/2016/07/Funes-the-Memorious.pdf我认为,我说出的每一个字(我的每一个举动)都会永存于他那巨细无遗、不可动摇的记忆中。
我惟恐做出无用多余的手势,因此如履薄冰、举止拘谨。
[2] Kimi K3.1 Pro 发布: https://www.kimi.com/en/blog/kimi-k3-1-pro
[3] Humanize MLE Agents 的研究者们: https://arxiv.org/html/2610.13494v1
[4] 《Retrieval Augmented Generation or Long-Context LLMs? 》: https://arxiv.org/html/2407.16833v2
[5] MemTensor 推出的 MemT-1.0: https://github.com/MemTensor/MemT-1.0/blob/main/README_zh.md
[6] MemT 论文的编码实验: https://arxiv.org/html/2610.26825v2 .SS2
[7] PowerContext: https://powercontext.oceanbase.io/
[8] 1.4 .1:https://github.com/oceanbase/powercontext/releases/tag/powercontext-v1.4.1
[9] 生成可复用的经验: https://github.com/oceanbase/powercontext/blob/powercontext-v1.4.1/docs/en/docs/workflows/create-and-review-experience.md
[10] 生成 Skill 候选: https://github.com/oceanbase/powercontext/blob/powercontext-v1.4.1/docs/en/docs/workflows/create-and-export-skill.md
[11] seekdb: https://github.com/oceanbase/seekdb
[12] 1.4 .0:https://github.com/oceanbase/seekdb/releases/tag/v1.4.0
[13] Fork、Diff、Merge 数据分支能力: https://github.com/oceanbase/seekdb/releases/tag/v1.3.0
立即试用 OceanBase 企业版,体验国产数据库能力 180 天免费试用,零门槛开通
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69909943/viewspace-3187319/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 省级农商行核心系统升级:OceanBase 分布式架构的 4 条选型逻辑
- 再+1OceanBase 联合高校攻克并发查询预测难题 - 企业级数据库实践
- ZCode × PowerContext:跨会话的记忆接入实践 - 企业级数据库实践
- 基于 Agent 观测实践:开发态与运行态的统一追踪方案
- PowerContext 1.4.0 发布:开发做到一半 - 企业级数据库实践
- 联通云犀平台 × OceanBase - 企业级数据库实践
- 聚势领航 - 企业级数据库实践
- 从语义层到本体 - 企业级数据库实践
- 又双叒叕一万亿银行升级 | 专访湖南农信 - 企业级数据库实践
- 构建跨会话与跨 Agent 的项目上下文底座 - 企业级数据库实践
