|
维度 |
直接本地盘(hostPath / local PV) |
OpenEBS LocalPV(LVM/ZFS) |
|
性能/延迟 |
最低,纯裸盘 |
几乎一样(仍是本地,无网络往返) |
|
动态供给 |
❌ 手工建目录/PV |
✅ PVC 自动建卷 |
|
快照/克隆 |
❌ 无 |
✅ LVM/ZFS 都支持 |
|
容量配额
|
❌ hostPath 无上限;local PV 是整盘 |
✅ 每卷硬上限(LV 大小 / ZFS quota) |
|
在线扩容 |
❌ 要重做、迁移数据 |
✅
allowVolumeExpansion
在线扩 |
|
缩容 |
❌ |
❌(都缩不了) |
|
IO 限速 |
❌ |
✅ LVM 支持(VAC QoS) |
|
校验/压缩/加密 |
❌ |
✅ ZFS 支持 |
|
调度安全 |
⚠️ hostPath 易漂移踩坑 |
✅ 自动绑到有盘的节点(NDM 选盘) |
|
额外依赖 |
无 |
要装 OpenEBS(NDM/Operator/CSI) |
|
节点故障数据 |
丢 |
丢(LocalPV 无副本,这点两者一样) |
数据库容器化存储选型:OpenEBS 体系架构解析
调研背景:Kubernetes 上部署 MySQL 8.4 MGR,厘清本地裸盘与 OpenEBS LocalPV 的差异、OpenEBS 各引擎适用边界,面向生产落地选型。
一、开篇:核心问题
MySQL 实例容器化跑在 K8s 中,数据文件到底落节点本地盘,还是使用独立存储系统(例如 OpenEBS)? 很多人会误以为 OpenEBS 都是跨节点分布式存储,其实 LocalPV 系列底层依然是节点本地磁盘,只是在裸盘之上,由 CSI 组件补齐了云原生存储能力。下面先对比 直接本地盘(hostPath / K8s 原生 LocalPV) 和 OpenEBS LocalPV(LVM/ZFS)。
二、直接本地盘 vs OpenEBS LocalPV 对比
三个最值得 DBA 重点关注的要点
-
快照与克隆是数据库运维能力分水岭原生本地盘没有快照能力。备份、PITR、快速克隆 MGR 从库,只能依赖 mysqldump、xtrabackup 全量导出,耗时久。
OpenEBS LocalPV LVM/ZFS 卷快照 + 克隆可以实现秒级快照;配合
FLUSH TABLES WITH READ LOCK或者 xtrabackup 的冻结机制拿到一致性快照,克隆 MGR 成员几乎即时,对 MGR 集群扩容、故障重建价值极高。 - hostPath 调度漂移属于高危坑,生产禁止使用hostPath 不会为 Pod 绑定节点亲和性。一旦 Pod 被驱逐、重调度到其他节点,会挂载到空目录或者其他实例的数据目录,MySQL 启动后是空库或者直接异常,属于灾难级故障。 OpenEBS LocalPV 和 K8s 标准 LocalPV 都会自动注入 nodeAffinity,强制 Pod 只能调度到存有该卷数据的节点,规避漂移风险。
- 扩容与容量隔离裸盘目录写满之后只能迁移数据重建;OpenEBS LocalPV 修改 PVC 即可在线扩容。hostPath 没有容量上限,单实例写满会打满整块磁盘,影响同节点其他业务;LocalPV 可以按卷设置硬配额,实现存储资源隔离。
选型初步建议(MySQL 8.4 MGR 场景)
- 生产环境:优先 OpenEBS LocalPV LVM(ZFS 按需选择)。性能和裸盘差距极小,核心收益是快照克隆、在线扩容、容量配额、IO QoS,都是 MGR 长期运维高频能力,裸盘很难低成本补齐。
- 开发、验证、临时测试:hostPath 或原生 K8s LocalPV 足够,减少额外组件,降低复杂度。
一句话总结:直接本地盘和 OpenEBS LocalPV 读写物理介质是同一块磁盘,性能差异可以忽略;OpenEBS LocalPV 购买的不是性能,而是 云原生供给、快照克隆、扩容、配额、IO 限速这套数据库运维能力。MGR 场景优先 LVM,有校验、压缩诉求再考虑 ZFS。
三、OpenEBS 体系结构与核心组件介绍
OpenEBS 4.x 是典型的 CAS(Container Attached Storage,容器附着存储)。 核心特点:存储引擎全部以 Pod 形式运行在 Kubernetes 集群内部,不需要依赖外部 SAN/NAS 存储阵列。整体分为 控制平面、节点组件、数据平面三层。
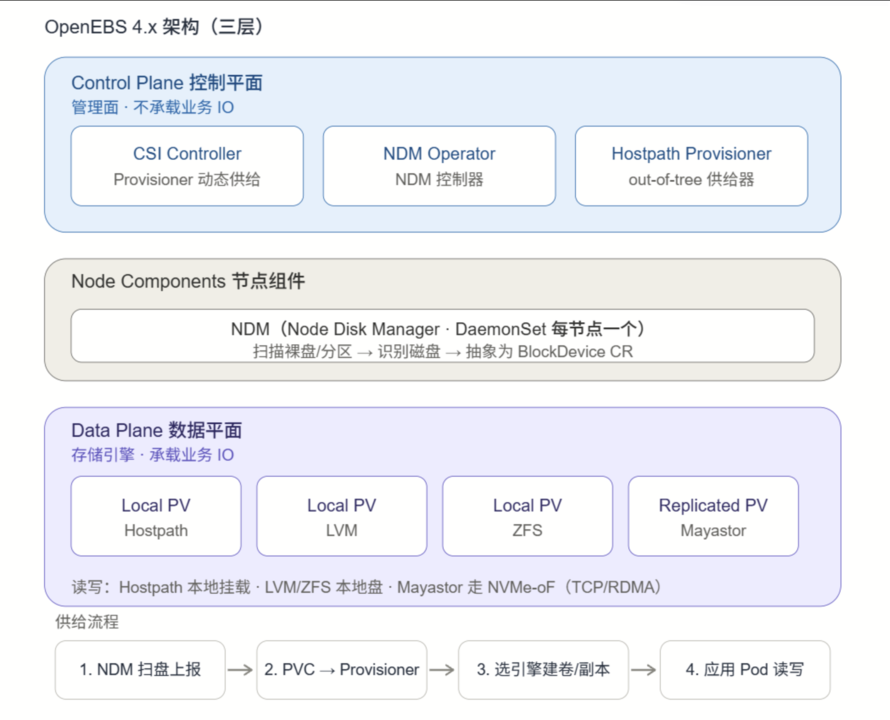
3.1 控制平面(管理面,不处理业务 IO)
控制平面负责监听 PVC、快照、卷生命周期事件,做调度与资源管理,不参与数据库 IO 链路。
- CSI Controller(Provisioner):4.x 核心供给入口。监听 PVC 创建、删除、挂载、快照事件,根据 StorageClass 参数选择存储引擎、分配节点,是 K8s 和底层存储引擎之间的统一调度器。
- NDM Operator:NDM 的控制端 Deployment,管理 BlockDevice CR、磁盘池 DiskPool,负责磁盘认领、释放、状态同步,向上层提供集群磁盘拓扑信息。
- Hostpath Provisioner:hostpath 引擎专用供给器,非 CSI 标准实现,在指定节点目录动态创建 hostpath 卷。
- 各引擎独立控制器:LVM Provisioner、ZFS Provisioner、Mayastor agent-core /csi-controller/pool operator。
3.2 节点组件:NDM(Node Disk Manager)
NDM 是 OpenEBS 的磁盘发现与管理组件,分为两部分:
- ndm DaemonSet:每个节点部署一个 Pod,扫描本机所有块设备;
- ndm-operator(Deployment):控制器,维护 BlockDevice CR 生命周期。
NDM 核心工作流:
- 扫描节点裸盘、分区(/dev/sda、/dev/nvme0n1 等);
- 每块识别到的磁盘生成一个 BlockDevice(BD)CR,记录设备路径、容量、序列号、文件系统状态;
- BD 状态:Active(空闲可用)/ Inactive(已挂载、存在文件系统,默认禁止使用)/ Unknown;
- 支持 include/exclude 正则过滤,筛选纳入管理的磁盘;
- 上层存储引擎通过认领 BlockDevice CR 占用磁盘;
- ndm-exporter:采集磁盘 SMART 指标,对接 Prometheus 监控。
3.3 数据平面(承载业务 IO)
数据平面是真正处理读写的引擎,不同引擎面向不同业务场景:
- Local PV Hostpath:节点目录,最简单,无快照、配额,延迟最低;
- Local PV LVM:本地 LVM 逻辑卷,支持快照、克隆、在线扩容、容量配额、IO 限速;
- Local PV ZFS:本地 ZFS,COW 快照,内置校验、压缩、加密;
- Replicated PV Mayastor:跨节点复制引擎,SPDK+NVMe-oF,同步复制、精简置备,适合需要存储层冗余的场景。
四、MySQL 场景:OpenEBS 引擎怎么选?
核心判断标准: 高可用能力交给 MySQL 层,还是交给存储层
场景 A:数据库层自带高可用(MGR / 主从 / InnoDB Cluster)→ LocalPV(LVM/ZFS)
本次 MySQL 8.4 MGR 部署属于该场景。 MGR 本身已经完成数据库层的同步复制,存储层再做一次跨节点复制属于冗余,会引入额外网络开销,拖慢 group commit 性能。 LocalPV 延迟最低,对 InnoDB 最友好;LVM/ZFS 自带快照克隆,支撑备份、MGR 成员重建、PITR。
重要约束:LocalPV 是节点本地存储,MGR 成员 Pod 和 PV 强绑定。节点故障后,数据依赖 MGR 其他成员重建,不能依赖存储迁移。部署要求:MGR 多个成员分散在不同节点,配合 Pod 反亲和、节点选择器隔离。
场景 B:单主 MySQL,需要存储层 RPO=0 冗余 → Mayastor
适合不搭建 MGR、只部署单实例 MySQL,但要求存储层跨节点同步复制,故障时 Pod 可以跨节点拉起、数据不丢失。 前置条件:NVMe SSD、大页内存;代价:NVMe-oF 带来额外网络延迟;Mayastor 轮询 IO 模式,空闲时也会占用分配 CPU 核。
五、Local PV LVM vs Local PV ZFS 对比
两者都是节点本地无副本 LocalPV,HA 都由 MGR 兜底,差异集中在存储特性、资源开销:
三个关键差异点展开
- 数据完整性(ZFS 最大优势)LVM 只是磁盘空间管理层,不做数据校验。磁盘静默损坏(bit rot)不会告警,数据库数据悄悄出错,风险极高。ZFS 每个数据块携带校验和,读取时校验;搭配 mirror/raidz 可以自动修复坏块,对数据库非常关键。
- 透明压缩ZFS lz4 压缩开销极低,MySQL 数据有压缩空间,节省磁盘容量,部分场景下减少物理落盘 IO。LVM 无原生透明压缩。
- 内存缓存,重点避坑ZFS ARC 缓存和 InnoDB Buffer Pool 是两层缓存,存在内存争抢。调优方案二选一:
- 限制
zfs_arc_max,压低 ARC 最大占用内存; - 数据卷设置
primarycache=metadata,数据读缓存交给 InnoDB,ZFS 只缓存元数据。 LVM 没有独立缓存层,直接使用操作系统页缓存,调优简单。
最终选型建议(MySQL 8.4 MGR)
- 追求低延迟、运维简单、不想维护 ZFS 内核模块 → LVM 优先,节点预装 lvm2、创建 VG 即可,快照克隆能力足够支撑 MGR 运维;
- 看重数据校验、透明压缩、高频快照,能接受 ZFS 内核部署与 ARC 调优 → ZFS。
ZFS 两个经典调参提醒:
- recordsize:InnoDB 页 16K,可设置 recordsize=16K 对齐,减少写放大;也可保留默认 128K,建议业务压测对比;
- ARC:严格控制上限,避免和 InnoDB Buffer Pool 抢内存。
一句话收尾:没有 ZFS 运维积累,优先 LVM;有数据校验、压缩诉求,愿意承担调优成本,选择 ZFS。MGR 场景二者都稳定可用,最终偏向运维习惯。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29654823/viewspace-3189469/ ,如需转载,请注明出处,否则将追究法律责任。
下一篇:
没有了~

请登录后发表评论
登录
全部评论
最新文章
- MySQL 8.4.10:WRITESET 模式下 DDL 为什么无法与其他事务并行复制
- MySQL 8.4 Writeset 并行复制详解:last_committed 与 sequence_number 的计算机制
- Docker网桥模式跨机访问MySQL的IP幻觉:一次主从切换踩坑实录
- SQL Server Always On 域服务账号滚动替换完整实战与底层原理
- 手把手教你用kubeadm部署生产级高可用Kubernetes集群
- redis cluster节点故障后Lettuce客户端无法自动恢复的解决方案
- MySQL自适应哈希索引
- oracle奇怪的WRONG FILE NUMBER
- rabbitmq镜像集群搭建和使用
- rabbitmq和kafka的选型
